
遇见数据集

camel-ai/SETA-Env

收藏
Hugging Face2026-07-01 更新2026-06-14 收录
官方服务:

资源简介:

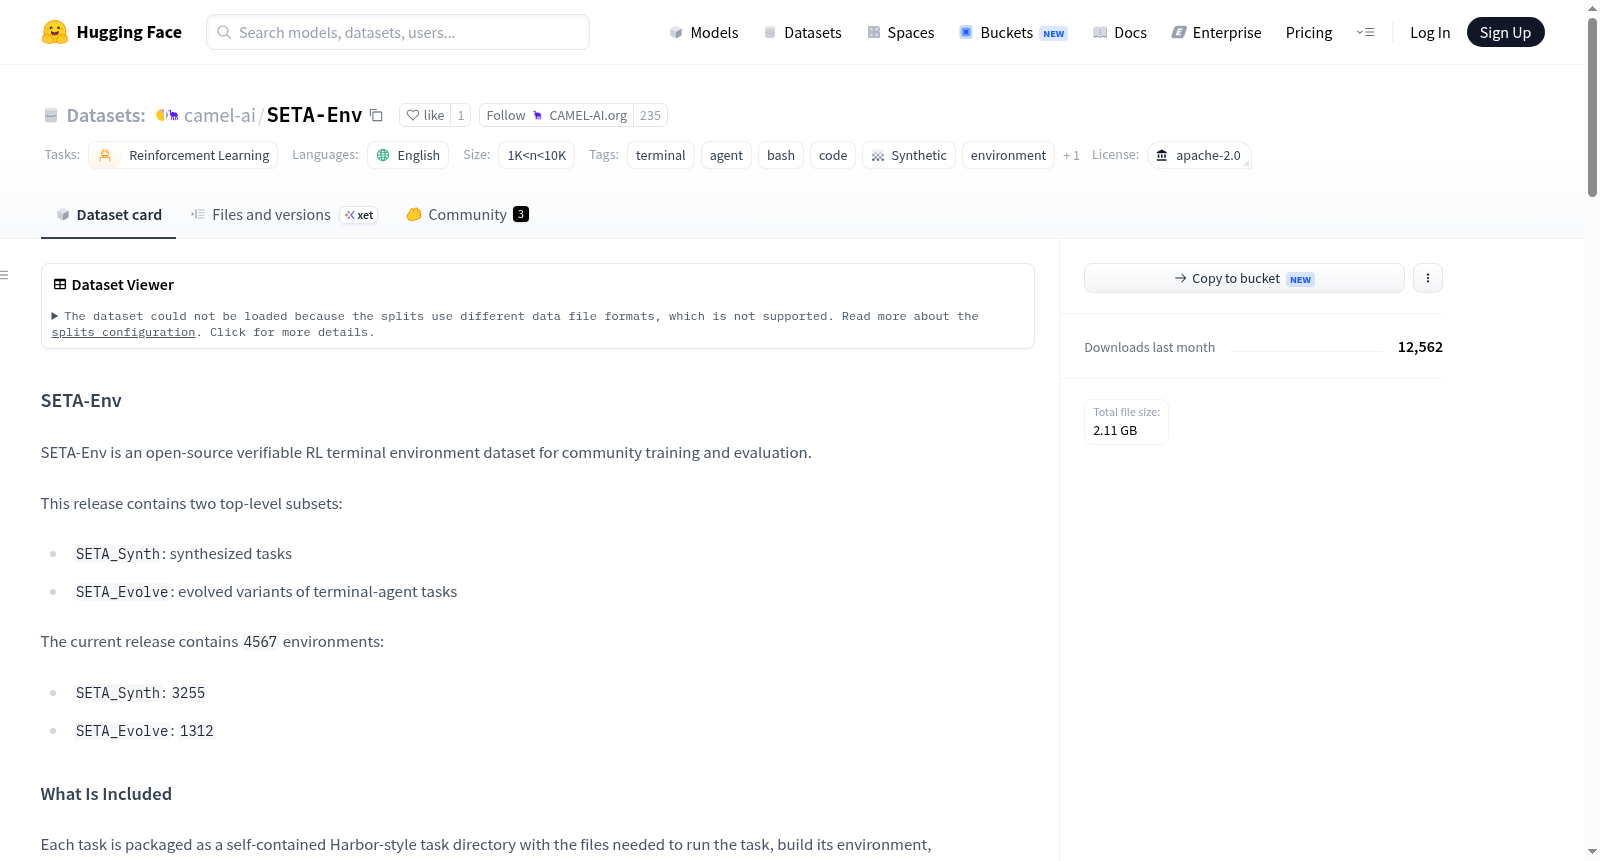
SETA-Env 是一个开源的可验证强化学习终端环境数据集,专为社区训练和评估而设计。该数据集包含两个主要子集:SETA_Synth(合成任务)和SETA_Evolve(终端代理任务的演化变体)。当前版本共包含4567个环境,其中SETA_Synth有3255个任务,SETA_Evolve有1312个任务。每个任务都打包为一个自包含的Harbor风格任务目录,包括运行任务、构建环境、执行参考解决方案和运行测试所需的文件。数据集结构清晰,任务文件夹包含task.toml、instruction.md、environment、solution和tests等子目录。数据来源多样,包括ask_ubuntu、kaggle_notebook、nl2bash、stack_overflow和unix_linux_se等,并提供了详细的来源细分统计。数据集支持混合许可证,具体取决于数据来源。

SETA-Env is an open-source verifiable RL terminal environment dataset for community training and evaluation. This release contains two top-level subsets: SETA_Synth (synthesized tasks) and SETA_Evolve (evolved variants of terminal-agent tasks). The current release includes 4567 environments: 3255 in SETA_Synth and 1312 in SETA_Evolve. Each task is packaged as a self-contained Harbor-style task directory with the files needed to run the task, build its environment, execute a reference solution, and run tests. The dataset structure includes task folders with components such as task.toml, instruction.md, environment, solution, and tests. Sources include ask_ubuntu, kaggle_notebook, nl2bash, stack_overflow, and unix_linux_se, with detailed breakdowns provided. The dataset has mixed licensing based on the source.
提供机构:
camel-ai
搜集汇总
数据集介绍
camel-ai/SETA-Env 数据集图片
构建方式
SETA-Env数据集由两个主要子集构成:SETA_Synth和SETA_Evolve,共计包含4567个终端环境任务。SETA_Synth子集从Ask Ubuntu、Kaggle Notebook、NL2Bash、Stack Overflow和Unix Linux Stack Exchange等五大来源中合成得到3255个任务,每个任务均通过结构化方式打包为Harbor风格目录,内含任务配置文件(task.toml)、指令描述(instruction.md)、基于Docker的运行时环境、参考解决方案(solve.sh)以及测试脚本。SETA_Evolve子集则在此基础上对原始任务进行演化变体生成,通过上下文变更(__b1)与难度调整(__d1)两种策略演化出1312个变体任务,以增强数据集的多样性和任务复杂度。
使用方法
数据集可通过Hugging Face Hub的snapshot_download接口便捷获取,用户指定仓库ID(camel-ai/seta-env-release)与目标目录即可完成全部数据下载。若需仅下载特定子集,可利用allow_patterns参数进行模式匹配过滤,例如使用"SETA_Synth/**"仅获取合成任务数据。下载后的每个任务目录可直接用于构建Docker镜像、执行参考解决方案并运行测试,适合用于终端智能体的训练与评估流程。该数据集遵循Apache-2.0开源协议,但部分源数据(如Stack Exchange内容)需遵循CC BY-SA许可,用户在使用时应注意相应的版权归属与引用要求。
背景与挑战
背景概述
SETA-Env数据集由Camel-AI研究团队于近期构建并公开发布,聚焦于强化学习领域中基于终端命令的智能体任务。该数据集以开源可验证的RL环境为核心,旨在为社区提供训练与评估智能体的标准化基准,其影响力在于填补了现有数据集在终端操作任务多样性及可复现性上的空白。SETA-Env包含两大子集:SETA_Synth通过人工合成技术生成3255个任务,涵盖Ask Ubuntu、Kaggle笔记本、NL2Bash、Stack Overflow及Unix Linux Stack Exchange等多源场景;SETA_Evolve则包含1312个演化变体任务,通过上下文或难度调整衍生出更丰富的复杂度层次。这些任务被组织为Harbor风格的独立目录,内置Docker环境、参考解决方案及测试脚本,显著降低了智能体系统的研发门槛。
当前挑战
SETA-Env旨在攻克的核心领域问题是终端交互型强化学习智能体的泛化能力不足,即现有模型难以在真实世界多变的命令行操作中稳定执行复杂任务。该数据集通过覆盖5大来源的4567个环境,模拟了包括系统管理、代码调试、数据科学等场景,但其构建过程面临多重挑战:首先,从Stack Exchange等异构平台提取的原始内容需经大量清洗与标准化处理,以确保指令的清晰性与环境的可执行性;其次,合成任务的生成需平衡真实性与覆盖度,避免引入偏差;再者,演化变体的设计(如上下文迭代或难度调整)需维持逻辑一致性,同时防止过度机械化的变异导致任务失真。此外,数据集许可证的混杂性(如CC BY-SA与MIT协议的兼容问题)也增加了合规维护的复杂性。
常用场景
经典使用场景
SETA-Env数据集专为强化学习领域中的终端代理(terminal agent)任务设计,其经典使用场景在于为研究者提供一个标准化、可复现的RL环境基准。该数据集包含从Ask Ubuntu、Stack Overflow等真实技术社区以及NL2Bash、Kaggle Notebook等编程场景中精心抽取的4567个任务,每个任务均以Harbor风格目录封装,内含完整的环境构建、参考解决方案和测试脚本,使得学术界能够在一个统一框架下对比不同终端代理算法的性能,从而推动该领域向更加系统化和可量化评估的方向发展。
解决学术问题
SETA-Env数据集有效解决了终端代理任务研究中长期存在的两大核心问题:一是缺乏大规模、多样化的高质量训练与评估环境,此前的工作多依赖手工构造的少量样例,难以全面衡量算法的泛化能力;二是环境可复现性不足,不同研究之间难以进行公平对比。该数据集通过合成任务(SETA_Synth)与进化变体(SETA_Evolve)两大子集的有机组合,覆盖了从问题查询、代码执行到系统管理的多元场景,不仅提供了3255个基础基准任务,还通过上下文变更和难度演化创造了1312个变体,为检验算法鲁棒性、迁移学习和零样本适应能力奠定了坚实基础。
实际应用
在实际应用层面,SETA-Env数据集可赋能一系列终端自动化产品与服务,例如智能运维系统中的故障排查代理、开发者环境中的代码调试助手以及企业级IT支持平台的自动应答引擎。通过在该数据集上训练的强化学习模型,系统能够理解自然语言描述的终端操作指令,自动生成并执行正确的bash命令,从而显著降低人工干预成本、提升运维效率。此外,该数据集还可用于开发面向Linux系统的交互式教学平台,帮助初学者通过实战任务掌握命令行技能,实现从理论到实践的平滑跨越。
数据集最近研究
最新研究方向
在强化学习与智能体系统迅猛发展的当下,SETA-Env作为一款开源且可验证的终端环境数据集,正引领着基于Bash指令的自主代理训练与评估新范式。该数据集通过合成任务与演化变体两大子集,覆盖Ask Ubuntu、Kaggle Notebook、NL2Bash等多元化真实与衍生场景,共计4567个精心封装的环境任务,为社区提供了从指令理解到环境交互、再到解决方案验证的完整闭环。其前沿价值在于不仅推动了终端代理在复杂上下文切换与难度递增挑战下的泛化能力研究,更通过结构化任务模板与标准化测试套件,为可复现的RL基准测评奠定坚实基础,进而加速了代码智能、自动化运维等热点领域中人机协同的实践落地。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

