
laion/nemotron-gym-agent-calendar-qwen3.5-122b-131k-opencode-sft-serveparity
收藏数据链接:
官方服务:
资源简介:
--- dataset_info: features: - name: messages list: - name: role dtype: string - name: content dtype: string - name: tool_calls list: - name: type dtype: string - name: function struct: - name: name dtype: string - name: arguments dtype: string - name: tools dtype: string - name: task dtype: string - name: num_turns dtype: int32 - name: num_tool_calls dtype: int32 splits: - name: train num_bytes: 143684453 num_examples: 3228 download_size: 75332262 dataset_size: 143684453 configs: - config_name: default data_files: - split: train path: data/train-* ---
提供机构:
laion搜集汇总
数据集介绍
构建方式
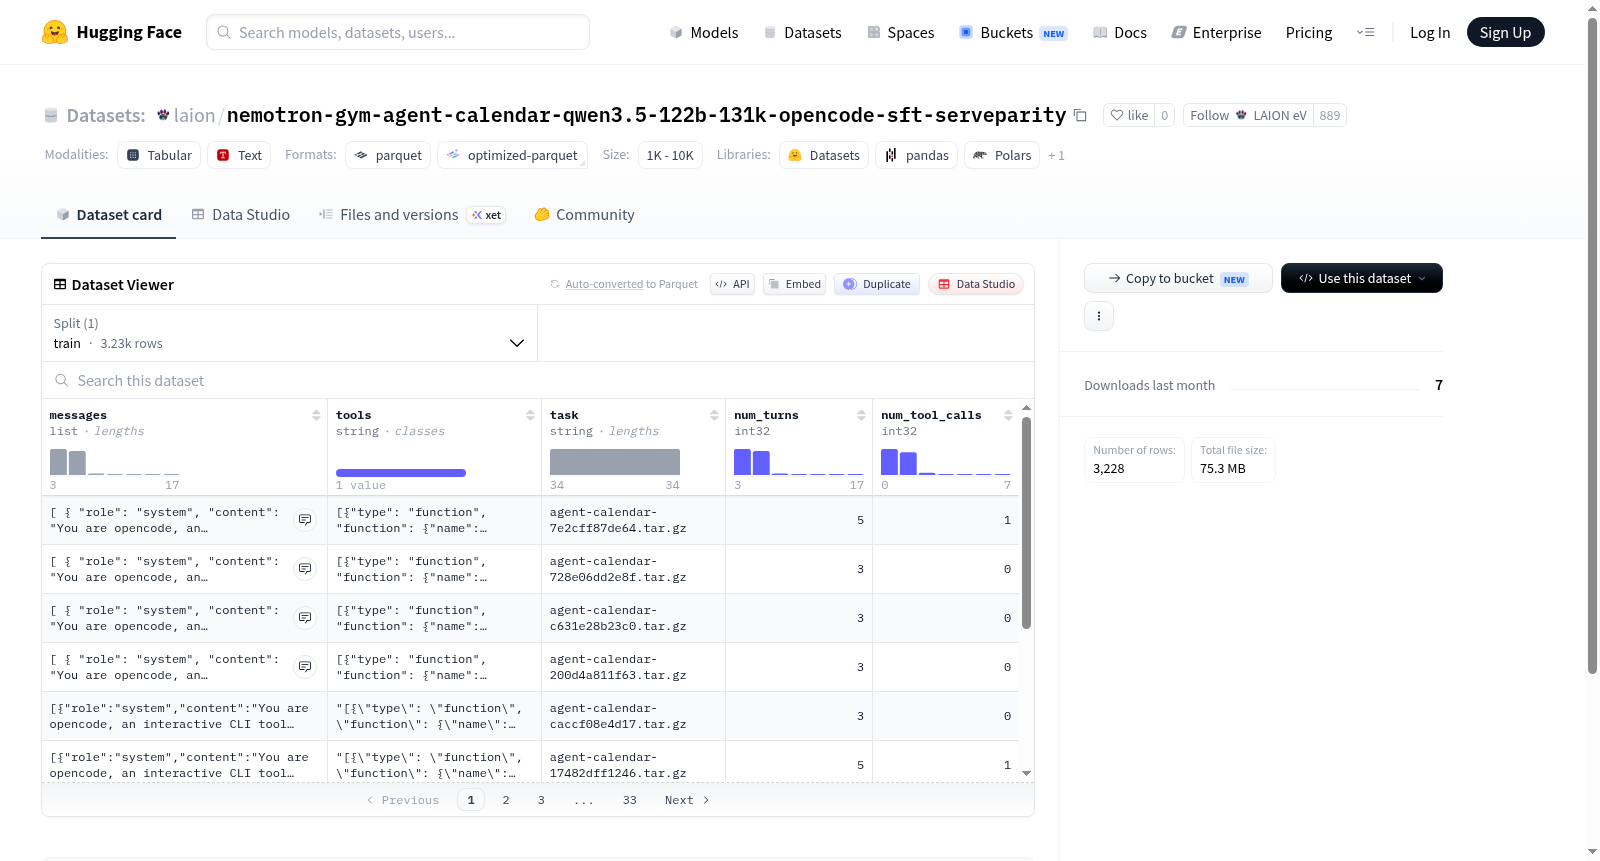
该数据集名为nemotron-gym-agent-calendar-qwen3.5-122b-131k-opencode-sft-serveparity,专为多轮对话与工具调用场景设计,旨在提升模型在日历等结构化任务中的智能体能力。数据集以对话形式构建,每条样本包含messages列表,其中每轮消息均记录角色、文本内容以及工具调用(tool_calls)的详细信息,包括调用类型与函数名称、参数。此外,每个样本还附带全局工具描述(tools)、任务标签(task)、对话轮数(num_turns)及工具调用次数(num_tool_calls),从而形成结构清晰、标注完备的SFT训练集。数据规模约14.4万字节,共3228条训练样本,均经过精细化整理与校验。
使用方法
使用该数据集时,建议将其直接用于监督微调(SFT)流程。数据采用标准的messages格式,兼容主流的对话式语言模型训练框架,如Transformers、DeepSpeed等。用户可按默认配置加载train分片,将每个样本的messages字段作为输入序列,工具描述字段作为上下文提示。在训练过程中,模型需学习根据对话历史生成正确的角色回答,并在必要时输出符合工具调用规范的函数调用参数。训练好的模型可用于日历管理等助手场景,在多轮交互中动态调用外部API完成用户指令。数据集已按HuggingFace标准格式组织,可直接通过datasets库加载。
背景与挑战
背景概述
在大型语言模型(LLM)与工具调用深度融合的浪潮中,如何构建高质量、多轮交互的智能体(Agent)训练数据成为亟待突破的核心瓶颈。nemotron-gym-agent-calendar-qwen3.5-122b-131k-opencode-sft-serveparity数据集应运而生,由NVIDIA研究团队于2024年主导创建,旨在解决日历场景下复杂多轮工具调用任务中的监督微调(SFT)数据稀缺问题。该数据集包含3228条训练样本,每条记录均涵盖完整的角色消息链、工具定义、任务标签及多轮交互细节,为提升LLM在结构化任务中的规划与执行能力提供了关键支撑。其发布推动了‘服务对等’(Serve Parity)评估范式的普及,成为连接模型指令遵循能力与实际生产部署效率的重要桥梁。
当前挑战
该数据集所应对的领域核心挑战在于:LLM在少样本或零样本条件下,难以在复杂多变的用户意图中精准规划工具调用序列,尤其在日历类场景中,时间冲突解决、参数依赖推断及多轮上下文保持等问题极易引发错误。构建过程中,团队需克服合成数据与真实环境的分布偏移,确保高质量标注的同时避免数据泄露;此外,面对131k上下文窗口的极端长度与122B参数的庞大规模,如何设计有效的SFT训练策略以平衡推理速度与回答准确性,并在不超过服务器容量下实现服务性能的对等评估,成为贯穿数据集构建与落地的双重技术壁垒。
常用场景
经典使用场景
该数据集专注于智能体(Agent)与日历工具交互的对话场景,每条样本包含多轮对话、工具调用及结构化函数参数。其经典用法在于训练大语言模型(LLM)遵循工具使用指令,通过模拟用户与日历API(如创建、查询、修改事件)的复杂对话,使模型学会自主规划调度、动态调用外部工具并解析响应结果。围绕此类任务,研究者可构建基于ReAct或Toolformer范式的智能体系统,检验模型在多步推理、工具编排与错误恢复方面的能力。
解决学术问题
该数据集主要解决了大语言模型在结构化工具使用中面临的“指令遵循偏差”与“多轮一致性”两大核心问题。传统监督微调常使模型学会机械模仿工具调用格式,却难以泛化至未见过的工具组合或多步操作。通过提供涵盖丰富工具调用流程的真实对话,该数据驱动模型在语义理解、函数参数约束遵循以及上下文依赖关系建模上取得突破,显著提升了智能体在动态环境中的决策鲁棒性与执行准确率,为任务导向型对话系统研究奠定了数据基础。
实际应用
在实际应用中,该数据集可赋能各类日历管理助手,例如通过微调后的模型自动处理用户“下周一下午三点与张三开会,若会议室忙则改到周二”等模糊指令,动态完成时间冲突检测、替代方案推荐及会议邀请发送。此外,配置了工具调用能力的对话系统可集成至企业邮箱、协同办公平台或智能个人助理中,实现从自然语言到API调用的端到端自动化,大幅提升用户在日程规划、资源协调等场景下的工作效率与使用体验。
数据集最近研究
最新研究方向
面向日历场景的高阶智能体工具调用优化研究。该数据集聚焦于利用先进大语言模型(如Qwen3.5-122B)增强智能体在日历任务中的多轮对话与工具编排能力,通过包含工具定义、多轮交互与工具调用次数的结构化数据,推动从静态对话到动态任务执行的范式跃迁。其背后映射了当前LLM代理(LLM Agent)领域的前沿热点——如何通过开放代码微调(OpenCode SFT)与服务镜像(ServeParity)策略,弥合模型在现实复杂工作流中的鲁棒性鸿沟。作为高端智能任务自动化的关键数据基座,它对于实现真正智能化的日程管理、企业级自动化助手,乃至在千亿参数级模型上实现工具调用泛化,具有里程碑式的示范意义与工程价值。
以上内容由遇见数据集搜集并总结生成


