遇见数据集

ipfs_zambia_laws

收藏
Hugging Face2026-09-07 更新2026-09-08 收录
官方服务:

资源简介:

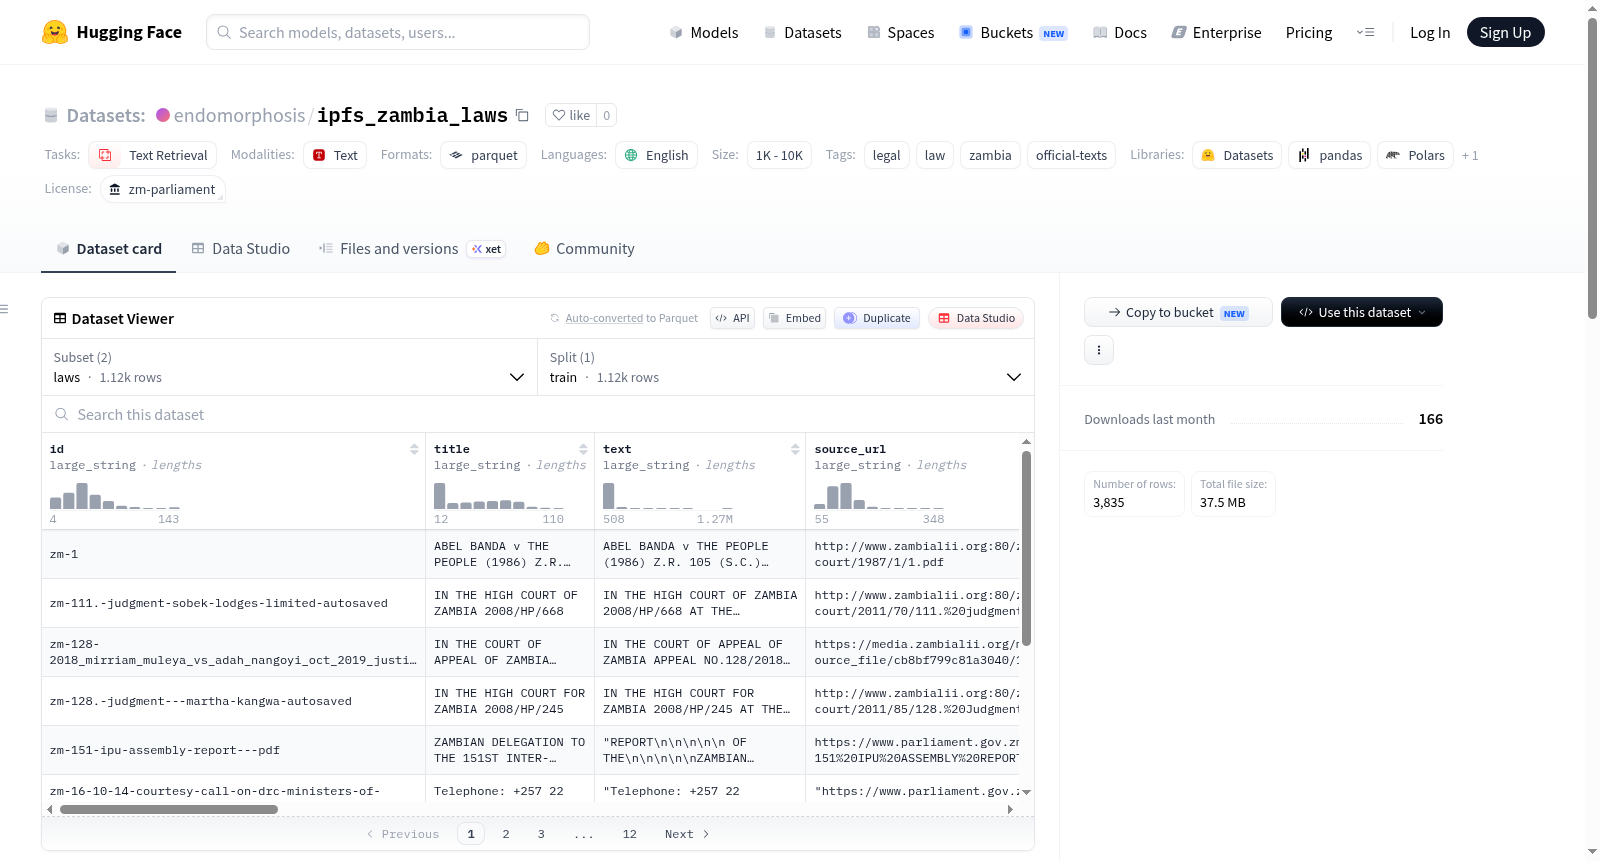
该数据集为“赞比亚法律”(Laws of Zambia)研究快照,收集自赞比亚议会(Parliament of Zambia)和ZambiaLII平台。数据集包含两个子集:laws子集(data/laws.parquet)包含1001条法律文书记录,每条记录包括法律ID、标题、全文、日期、状态、标识符、条款数量和来源URL;articles子集(data/articles.parquet)包含2067条法律条款记录,每条记录包括法律ID、条款编号、标题、文本和来源URL。数据语言为英语,覆盖赞比亚司法管辖区。该数据集适用于法律文本检索、法律分析等自然语言处理任务。注意:数据集并非官方整合版本,不构成法律建议,官方公报和政府门户网站应优先使用。许可证为zm-parliament,允许研究用途。

This dataset is a research snapshot of the Laws of Zambia, collected from the Parliament of Zambia and the ZambiaLII platform. It contains two subsets: the laws subset (data/laws.parquet) with 1001 legal document records, each including law ID, title, full text, date, status, identifier, number of articles, and source URL; and the articles subset (data/articles.parquet) with 2067 legal article records, each including law ID, article number, title, text, and source URL. The data language is English, covering the jurisdiction of Zambia. This dataset is suitable for natural language processing tasks such as legal text retrieval and legal analysis. Note: The dataset is not an official consolidated version and does not constitute legal advice; official gazettes and government portals should be prioritized. The license is zm-parliament, allowing research use.

创建时间:
2026-09-06
原始信息汇总

数据集概述

该数据集为赞比亚法律的官方立法研究快照,数据来源于 赞比亚议会 / ZambiaLII。数据集仅用于研究目的,不构成法律建议,官方公报或政府门户网站的内容具有最终效力。

基本信息

项目 内容
数据集名称 Laws of Zambia
语言 英语
司法管辖区 赞比亚
许可证 zm-parliament
任务类别 文本检索
标签 法律、赞比亚、官方文本
数据规模 1K < n < 10K
快照日期 2026-09-07

数据规模与覆盖范围

  • 法律/法规数量:1061 项
  • 条款数量:2516 条
  • 覆盖范围:基于目录的、不完整的收集

数据内容与格式

数据集包含两个配置,均为 Parquet 格式:

  1. 法律法规级数据(laws)data/laws.parquet — 每行对应一部法律或法规,包含 ID、标题、全文、日期、状态、标识符、条款数量及来源 URL。
  2. 条款级数据(articles)data/articles.parquet — 每行对应一个法律条款或章节,包含 law_id、条款编号、标题、文本及来源 URL。

附带文件

  • scrapers/collect_zm.py:数据集构建时使用的研究采集脚本
  • scrapers/common.py:采集工具共享辅助函数
  • scrapers/world_lib.py:网络请求辅助(实时官方 URL,备选 Wayback 回退)
  • scrapers/archive_fallbacks.py:Wayback / Common Crawl CDX 辅助工具

许可与复用说明

  • 官方政府/公报文本可按来源门户的公共部门条款复用。
  • 数据集的打包格式、元数据及采集脚本仅用于研究目的。
  • 该数据集不是官方整合版本,不构成法律建议,一切以官方来源为准。
搜集汇总
数据集介绍
ipfs_zambia_laws 数据集图片
构建方式
该数据集是基于赞比亚议会及ZambiaLII官方门户的立法文本构建的研究快照,采集日期为2026年9月7日。构建过程依赖自研的爬虫脚本collect_zm.py及其共享工具模块,通过实时抓取官方URL并辅以Wayback Machine回退机制,确保覆盖范围具有目录可追溯性。数据以两种粒度的Parquet文件存储:laws.parquet收录了1121项法律文书的元数据及全文,涵盖标题、日期、状态、标识符及来源链接;articles.parquet则细分为2714条条文或章节,关联至具体法律ID,并保留原文与出处。该数据集明确标记并非官方整合版本,且不构成法律建议,官方公报及门户内容优先。
特点
此数据集聚焦赞比亚法律领域,具有领域专精与层次分明的特点。其法律文书数量逾千,条文逾两千,覆盖广泛,且每条记录均附有详尽元数据,便于检索与关联分析。数据集采用双配置结构,既支持对整部法律的宏观研究,也支持对具体条文的微观洞察。来源权威,依托议会官方与ZambiaLII,并设计有Wayback回退机制,提升了数据采集的鲁棒性与完整性。此外,许可证明确为zm-parliament,适用于研究目的,但强调官方文本的优先效力,体现了严谨的学术与法律伦理考量。
使用方法
使用时可通过HuggingFace数据集加载接口获取指定配置,如laws或articles,以Pandas或类似工具读取Parquet文件,便于进行文本检索、法律条文比对或数据挖掘。研究流程建议先依据laws中的元数据(如标题、状态、日期)筛选目标法律,再关联至articles配置,深入其章节内容。由于数据集仅面向研究,应用时应交叉核验官方来源,避免直接引用本快照作为法律依据。对于需要更新或扩展语料的需求,可复用scrapers目录下的采集脚本,并参考共享工具实现实时抓取或回退策略。
背景与挑战
背景概述
赞比亚法律数据集(ipfs_zambia_laws)由研究团队于2026年9月构建,旨在系统化收集赞比亚议会及ZambiaLII平台发布的官方立法文本。该数据集涵盖1121部法律文书与2714个条款,以英文呈现,并附有法令状态、标识符及来源链接等元数据。其核心研究问题在于为法律文本检索、自然语言处理及法律信息学提供结构化的语料基础,填补了非洲法域在开源法律数据集方面的空白。该数据集的发布促进了跨学科研究,尤其在法律科技与司法透明度领域,为算法辅助法律分析、案例推理及法律知识图谱构建提供了关键资源,对非洲法律信息化进程具有推动作用。
当前挑战
该数据集面临多重挑战。领域层面,赞比亚法律体系复杂,法规分散且修订频繁,官方文本数字化程度不一,导致数据收集需依赖多渠道整合,且需确保法律文本的准确性与时效性。构建过程中,爬虫需应对官网结构变化、访问限制及内容不完整,采用Wayback回退机制虽增强鲁棒性,但仍可能遗漏未归档法律。此外,法律文本的版权与公共部门再利用条款需谨慎处理,数据集明确声明非官方合订本,不构成法律建议,这要求使用者在法律应用中注意文本权威性,避免因数据不全或过时而产生误导。
常用场景
经典使用场景
该数据集为赞比亚法律研究提供了系统化的语料库,收录了1121部法律文书及2714个条款,涵盖官方公报和议会原始文本。其核心用途在于支持法律文本的深度检索与语义分析,研究者可基于法律全文及条文粒度的结构化数据,开展立法历史追溯、法律效力评估及法规间关联性挖掘。此语料库的官方来源属性与完整的元数据,为跨学科的法信息学、计算法学及公共政策研究提供了坚实的数据基础,尤其适用于需要精确引用与合法性验证的场景。
衍生相关工作
依托该数据集,研究者已开发出针对非洲法域的高效文本采集与存档工具链(如collect_zm.py与Wayback回退机制),推动了法律语料库构建的自动化。其众包式管理框架被借鉴于其他法域的数据集制作,间接促成了跨国家法律比较研究平台的出现。条款粒度的数据格式催生了基于司法管辖区别的法律解析器及立法影响力评估模型,并为低资源法律NLP任务提供了基准资源,相关共享策略也引发了关于公共领域数据许可与使用的伦理讨论,具有深远的学术辐射效应。
数据集最近研究
最新研究方向
在司法人工智能与法律文本挖掘的交叉前沿,赞比亚法律数据集(ipfs_zambia_laws)的构建为非洲法域的数字法治研究注入了新的活力。该数据集快照囊括1121部法律文书及2714个条款,系统地整合了来自赞比亚议会与ZambiaLII的官方立法文本,并通过Wayback Machine与Common Crawl的回退机制保障了数据的稳健性与可溯源复现。其精细的粒度设计——分别存储法律层级与条款层级,并附有完整元数据与来源链接——为法律条文检索、跨法条关联分析以及基于语义的法律推荐系统等自然语言处理任务提供了高价值的语料基础。尤为重要的是,该资源聚焦于撒哈拉以南非洲的普通法体系,填补了该区域高质量法律数据集的空白,为比较法研究、法律知识图谱构建以及面向低资源环境的法律人工智能模型训练开辟了新的可能。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务