
遇见数据集

mlfoundations/MINT-1T-PDF-CC-2024-10

收藏
Hugging Face2024-09-19 更新2024-12-14 收录
官方服务:

资源简介:

MINT-1T是一个开源的多模态数据集,包含1万亿文本标记和34亿张图像,是现有开源数据集规模的10倍。该数据集旨在促进多模态预训练研究,涵盖了HTML文档、PDF文档和ArXiv论文等多种来源。数据集由华盛顿大学与Salesforce Research等机构合作创建,经过严格的文档提取、过滤、图像处理和文本处理等步骤,并使用了多种开源工具。尽管数据集经过严格过滤,但仍可能存在一些敏感信息,用户在使用时需谨慎。

MINT-1T is an open-source multimodal interleaved dataset with 1 trillion text tokens and 3.4 billion images, a 10x scale-up from existing open-source datasets. The dataset also includes previously untapped sources such as PDFs and ArXiv papers. MINT-1T is designed to facilitate research in multimodal pretraining and was created by a team from the University of Washington in collaboration with Salesforce Research and other academic institutions including Stanford University, University of Texas at Austin, and University of California Berkeley. The dataset is a comprehensive collection of multimodal documents from various sources, including HTML, PDF, and ArXiv documents, and underwent extensive data collection, filtering, and processing to ensure content relevance and readability.
提供机构:
mlfoundations
搜集汇总
数据集介绍
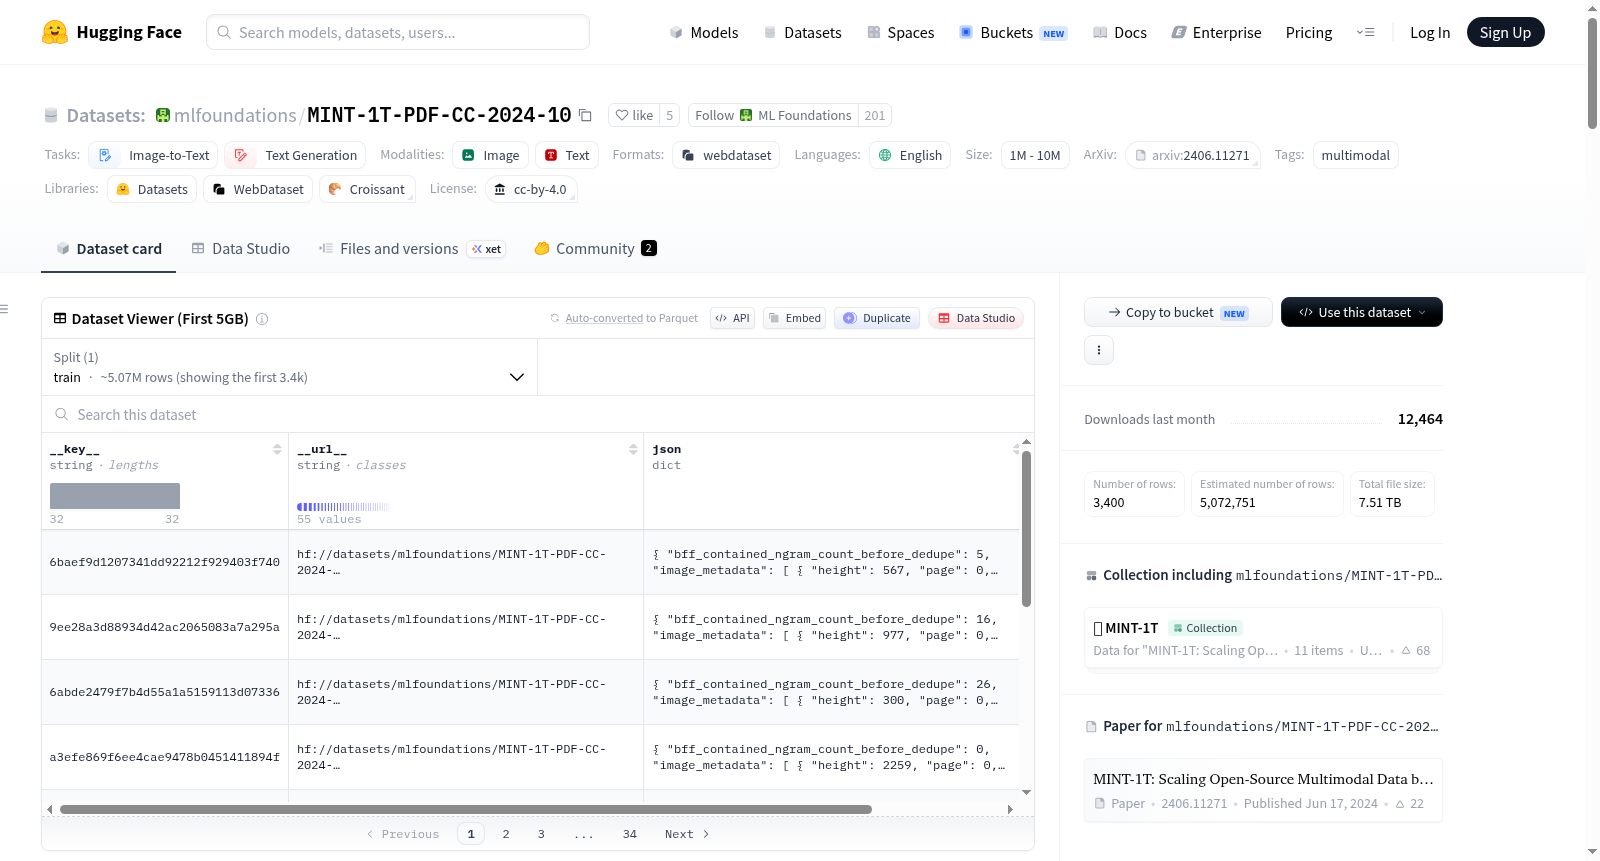
mlfoundations/MINT-1T-PDF-CC-2024-10 数据集图片
构建方式
在人工智能领域,大规模多模态数据集的构建是推动视觉与语言模型发展的关键基石。MINT-1T数据集的构建源自对开源社区缺乏海量交错式多模态预训练数据的深刻洞察。该数据集由华盛顿大学联合Salesforce研究院、斯坦福大学、德克萨斯大学奥斯汀分校及加州大学伯克利分校共同打造,整合了来自CommonCrawl的HTML文档(2017-2024年)、PDF文档(2023-2024年)以及ArXiv论文存储库的多元资源。构建流程历经文档提取、逐级过滤与精细处理:首先通过PyMuPDF解析PDF并复原阅读顺序,利用TexSoup处理LaTeX源码以交错图文;随后应用fasttext筛选英文内容,借助Bloom过滤器执行段落与文档级去重,并剔除低质量与不良内容;最后对图像进行NSFW检测、尺寸限制及宽高比调整,确保数据质量与安全性。最终形成了包含1056.8百万文档、1万亿文本令牌与34亿图像的庞大规模。
特点
MINT-1T数据集的核心特质在于其前所未有的规模与多元来源的有机融合。相较于现有开源数据集,它实现了10倍的规模跃升,涵盖1029.4百万HTML文档、24.0百万PDF文档与0.6百万ArXiv文档,其中PDF与ArXiv论文的引入填补了以往数据集在学术与结构化文档领域的空白。该数据集以交错式多模态形式组织,图文序列紧密关联,专为训练如Idefics2、XGen-MM和Chameleon等高级多模态模型而设计。在质量控制方面,构建者实施了严密的隐私保护措施,包括掩码电子邮件地址与IP地址、过滤敏感URL,并采用NSFW图像分类器剔除不当视觉内容。然而,数据集也客观存在源自网络爬取的固有偏差、外部图像URL的时效性风险以及PDF复杂布局解析的局限性,这些特性提示使用者在应用时需审慎评估。
使用方法
MINT-1T数据集主要服务于多模态预训练研究,其使用方法强调灵活性与适配性。用户可直接利用该数据集训练能够理解交错文本与图像序列的模型,例如基于Idefics2或Chameleon架构的模型。当前HuggingFace页面提供的子集为与CommonCrawl快照'CC-2024-10'关联的PDF部分,用户可通过MINT-1T集合页面获取HTML、ArXiv及其他PDF子集。鉴于数据集已按CC-BY-4.0许可发布,研究社区可自由访问与使用,但强烈建议在特定应用场景下额外施加过滤,以应对潜在的偏差与敏感内容。对于商业用途,使用者需独立核实法律合规性,并避免将数据集用于生成个人身份信息或军事相关领域。通过遵循上述指南,研究者可以充分发挥MINT-1T在推动多模态人工智能开放科学中的潜力。
背景与挑战
背景概述
在大规模多模态预训练领域,数据集的规模与质量直接决定了基础模型的性能上限。2024年,由华盛顿大学联合Salesforce Research、斯坦福大学、德克萨斯大学奥斯汀分校及加州大学伯克利分校等顶尖机构组成的研究团队,推出了名为MINT-1T的开源多模态交错数据集。该数据集包含1万亿文本标记与34亿张图像,规模较此前开源数据集提升了一个数量级,并首次系统性地整合了PDF文档与ArXiv论文等未充分挖掘的语料来源。其核心研究问题在于突破多模态预训练对专有数据的依赖,推动开放科学在视觉-语言联合建模中的发展,为训练如Idefics2、XGen-MM等具有交错图文理解能力的模型提供了关键资源。
当前挑战
MINT-1T所面临的挑战涵盖领域问题与构建过程两个层面。在领域层面,现有开源多模态数据集规模有限,难以支撑千亿级参数模型的预训练需求,且对PDF、学术论文等结构化文档的利用不足,限制了模型在科学文献理解等场景中的泛化能力。在构建层面,数据来源的异构性带来了显著困难:从CommonCrawl的WARC与WAT文件中提取PDF时,需克服复杂布局对阅读顺序的解析误差;图像链接的时效性导致部分样本面临失效风险;同时,尽管采用了NSFW检测与个人信息掩码等过滤手段,源自网络爬虫的数据仍可能残留偏见与敏感内容,需用户结合具体场景进行二次筛选以确保合规性。
常用场景
经典使用场景
在跨模态预训练领域,MINT-1T凭借其万亿级文本令牌与34亿张图像的海量交织数据,成为训练多模态大模型的基石。该数据集从CommonCrawl及ArXiv等来源精炼HTML、PDF与学术论文,通过严格的质量过滤与去重流程,确保了数据的高质量与多样性。其经典用法在于支撑像Idefics2、XGen-MM和Chameleon这类能够理解文本与图像交错序列的先进多模态模型,为模型提供前所未有的丰富上下文与视觉语义对齐能力。
衍生相关工作
MINT-1T的诞生催生了一系列围绕大规模多模态预训练的开源工作与基准研究。其构建流程中的文档解析、质量过滤与去重技术,如基于PyMuPDF的阅读顺序提取和Bloom过滤器去重,为后续数据集创建提供了可复现的范式。同时,基于该数据集训练的模型在多项视觉-语言任务上刷新了性能记录,激励了更多关于数据效率、模型缩放法则以及跨模态对齐的深入探索,形成了从数据构建到模型评估的完整研究生态。
数据集最近研究
最新研究方向
MINT-1T数据集代表了多模态预训练领域的一项里程碑式突破,通过整合万维网、PDF文档及ArXiv论文等多元来源,构建了包含1万亿文本令牌与34亿图像的超大规模交错式多模态数据资源。该数据集的发布恰逢大语言模型向多模态能力演进的关键时期,其10倍于现有开源数据集的规模优势,为训练如Idefics2、XGen-MM和Chameleon等能够理解图文交错序列的下一代多模态模型提供了坚实基础。研究团队来自华盛顿大学、斯坦福大学等顶尖机构,通过严格的文本质量过滤、NSFW图像检测、去重及隐私信息掩码等处理流程,在确保数据质量的同时兼顾伦理合规性。这一开源举措有望显著降低多模态大模型研究的准入门槛,推动开放科学运动,并为解决多模态学习中数据稀缺与规模瓶颈问题开辟新路径。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

