
Lexsi/provenance-grounded-synthetic-qa
收藏官方服务:
资源简介:
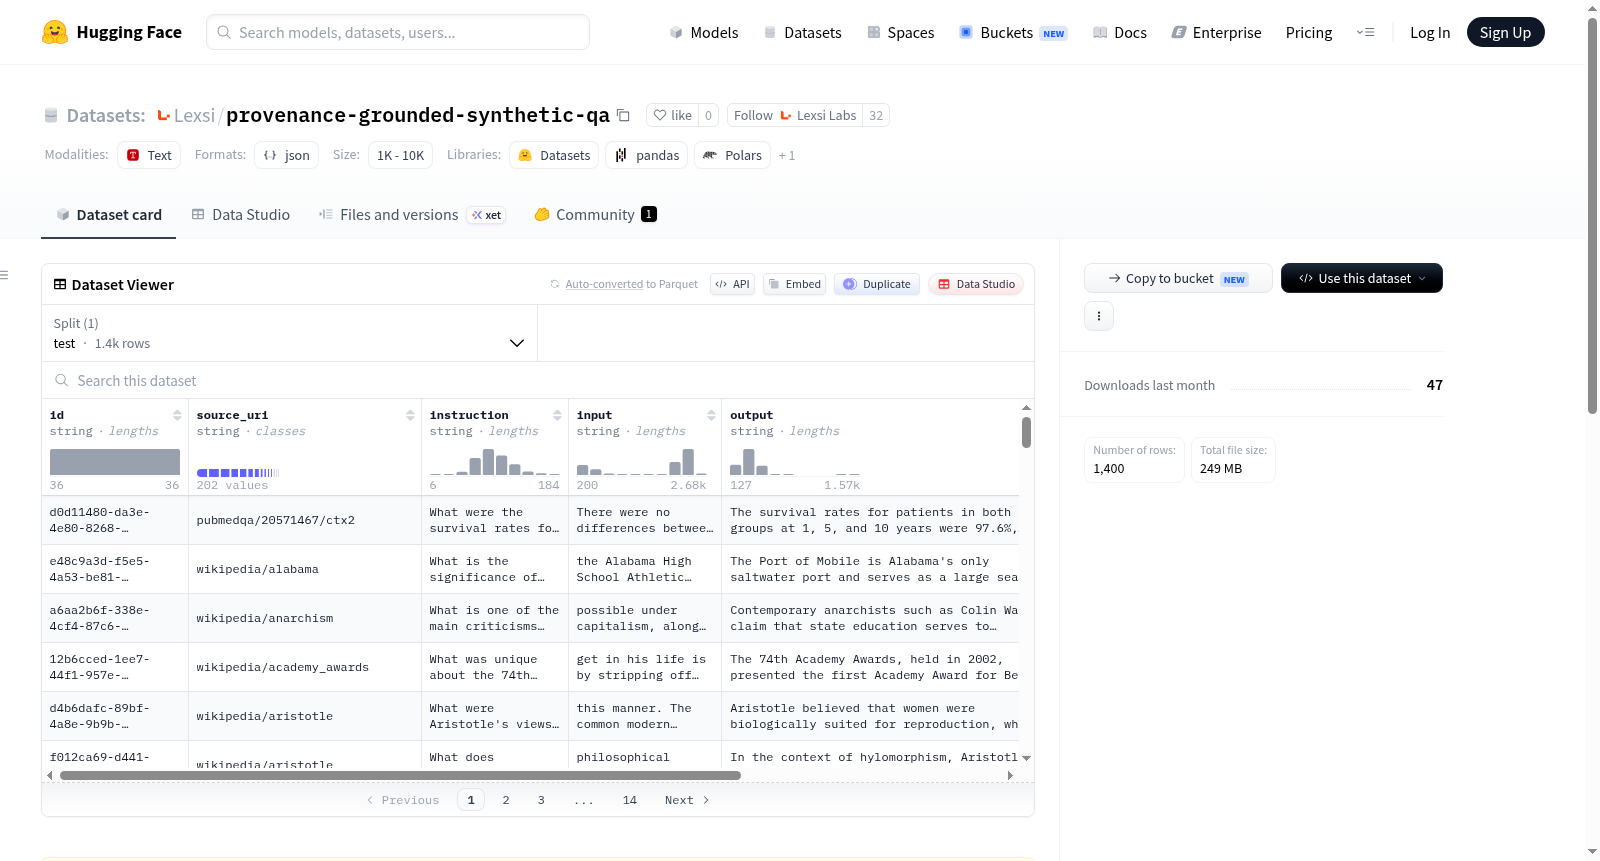
该数据集包含使用Qwen系列模型生成和过滤的合成问答对。生成模型包括Qwen/Qwen3-1.7B、Qwen/Qwen3-4B和Qwen/Qwen3-8B,过滤模型为Qwen/Qwen3.5-35B-A3B(一个具有30亿活跃参数的350亿专家混合模型)。数据集结构包括未过滤的原始问答对、通过双重过滤的问答对、仅针对幻觉过滤的问答对、基于奖励分数过滤的问答对、通过顺序过滤恢复的问答对以及一个保留的测试集。
This dataset contains synthetic question-answer pairs generated and filtered using Qwen series models. The generation models include Qwen/Qwen3-1.7B, Qwen/Qwen3-4B, and Qwen/Qwen3-8B, while the filtering model is Qwen/Qwen3.5-35B-A3B (a 35B Mixture-of-Experts model with 3B active parameters). The dataset structure comprises raw unfiltered QA pairs, QA pairs passing both filters, QA pairs filtered for hallucination, QA pairs filtered by reward score, QA pairs recovered via sequential filtering, and a held-out test set.
提供机构:
Lexsi搜集汇总
数据集介绍
构建方式
本数据集以合成数据生成技术为核心,利用Qwen3系列中的1.7B、4B及8B三种参数规模的模型分别生成初始的问答对,形成未经筛选的原始样本池。为确保数据质量,引入Qwen3.5-35B-A3B这一混合专家模型作为过滤引擎,该模型拥有35B总参量但仅激活3B参数,兼顾高效与精准。过滤流程分为双重路径:其一为幻觉过滤,剔除与给定来源内容不一致的问答;其二为奖励分数过滤,基于模型对回答质量的打分筛选高置信度样本。此外,通过序贯恢复机制,从被过滤的样本中重新获取潜在有效数据,从而构建出多层次、分领域的数据子集,并保留一份独立测试集用于后续评估。
特点
此数据集最显著的特点在于其构建过程的严谨性与可追溯性,所有问答对均明确关联至其生成模型与过滤阶段,形成清晰的‘来源证明’(provenance)链条。数据结构划分精细,涵盖未过滤、双重过滤、单向过滤及恢复样本等多类目录,方便研究者针对不同质量需求灵活选用。混合专家过滤模型的应用不仅降低了计算开销,还通过分离幻觉检测与奖励评分两个维度,从事实一致性与语义质量层面双重把关,确保最终数据兼具准确性与实用性。这种设计使得数据集成为评估和改进问答系统鲁棒性的理想基准。
使用方法
使用本数据集时,用户可根据研究目标直接加载相应子目录中的问答对,例如利用‘both_filtered_qa’获取高质量训练样本,或使用‘hall_filtered_qa’研究幻觉现象。测试集‘test_set.jsonl’以JSONL格式存储,便于快速集成到标准评估流程中。建议结合数据集提供的来源信息,在微调语言模型时采用有监督学习策略,或将其作为验证集来评估模型对事实一致性的遵循程度。对于需要分析过滤偏好的工作,可通过比较不同子集的数据分布,深入理解模型在幻觉检测与奖励评分中的行为模式。
背景与挑战
背景概述
为了推动大语言模型在开放域问答任务中的可信度与可溯源能力,研究者提出了基于来源的合成问答数据集(provenance-grounded-synthetic-qa)。该数据集由研究团队利用Qwen系列模型(包括Qwen3-1.7B、4B与8B)生成初始问答对,并借助Qwen3.5-35B-A3B这一混合专家模型进行过滤与优化,创建时间上体现了2024至2025年间大模型合成数据技术的前沿进展。核心研究问题聚焦于如何通过引入来源验证机制,减少模型在生成答案时产生的幻觉现象,从而提升问答系统的可靠性。该数据集通过多层过滤(幻觉过滤、奖励评分过滤)与顺序恢复策略,生成高质量、低幻觉的问答样本,为后续的评测与微调提供了坚实的数据基础。其在自然语言处理领域,尤其是面向事实问答与来源验证的研究中,具有重要的推动意义。
当前挑战
该数据集所解决的核心领域挑战在于大语言模型在问答任务中普遍存在的事实幻觉问题,即模型可能生成看似合理但缺乏真实来源支持的答案,这严重限制了模型在金融、医疗、法律等高可靠性场景中的应用。此外,构建过程中面临的技术难点包括:如何在保持问答对多样性与覆盖性的同时,有效剔除含幻觉或低质量的内容;单一过滤策略可能过于保守导致有用样本损失,而自由生成又无法保证准确率;多层过滤虽能提升质量,但同步引入奖励模型与幻觉检测模型之间的权衡问题,以及如何设计合理的顺序恢复机制以平衡回收率与质量。这一系列挑战要求更高的过滤精度与更稳健的来源对齐策略。
常用场景
经典使用场景
在自然语言处理与知识密集型问答系统的研究前沿,基于来源锚定的合成问答数据集(provenance-grounded-synthetic-qa)为模型训练与评估提供了坚实的基石。该数据集的核心应用场景在于构建和优化具备事实溯源能力的问答系统。研究者利用多尺度生成模型(1.7B至8B参数)合成海量问答对,再经由强大的混合专家过滤模型(35B参数,3B激活)进行严格筛选,产出从原始生成到多阶段过滤(幻觉过滤、奖励评分过滤、序列恢复)的精细化数据层级。这些问答对天然带有来源锚定特性,使其成为训练语言模型理解并忠实引用给定上下文、避免捏造事实的绝佳训练语料。经典使用方式包括将其作为微调数据训练检索增强生成(RAG)模型,或作为评估基准测试模型在限定源文档下的忠实性和准确性,从而推动可信赖问答系统的发展。
衍生相关工作
此数据集的发布激发了一系列衍生研究工作,尤其集中于模型忠实度的精细化评估与生成质量的多维改善。受其多阶段过滤流水线(幻觉过滤、奖励评分过滤、序列恢复)启发,学术界涌现出众多关于‘过滤即训练’策略的探讨,研究者开始系统比较不同过滤信号(如基于自然语言推理的幻觉检测器与基于人类偏好的奖励模型)对最终生成质量的影响权重。此外,该数据集中引入的混合专家过滤模型(Qwen3.5-35B-A3B)也为’在评估阶段使用大规模、高参数效率的模型去监督小模型的生成‘这一范式提供了实证案例。基于该数据的后续工作还包括:探索将源锚定问答扩展至跨语言与多模态场景、设计更鲁棒的对抗性测试集来挑战模型的忠实度极限,以及利用时序恢复机制启发新的课程学习或难例挖掘算法,这些工作共同推动了可信赖问答生态系统的构建。
数据集最近研究
最新研究方向
基于来源可信度的合成问答数据生成与过滤机制研究。该数据集由Qwen系列多尺寸模型(1.7B至8B)生成,并采用参数高效的MoE大模型(Qwen3.5-35B-A3B)进行双重过滤,涵盖幻觉检测与奖励评分筛选。当前前沿方向聚焦于利用分级过滤策略(包括顺序恢复机制)提升合成数据的质量与可靠性,以缓解大模型在知识密集型任务中的幻觉问题。此举对于构建可溯源、低噪声的训练数据具有关键意义,尤其推动了资源受限场景下高保真问答系统的研究进展。
以上内容由遇见数据集搜集并总结生成


