
fetch_huggingface_terminal_9096_x9p2k_drv_tickets
收藏数据链接:
官方服务:
资源简介:
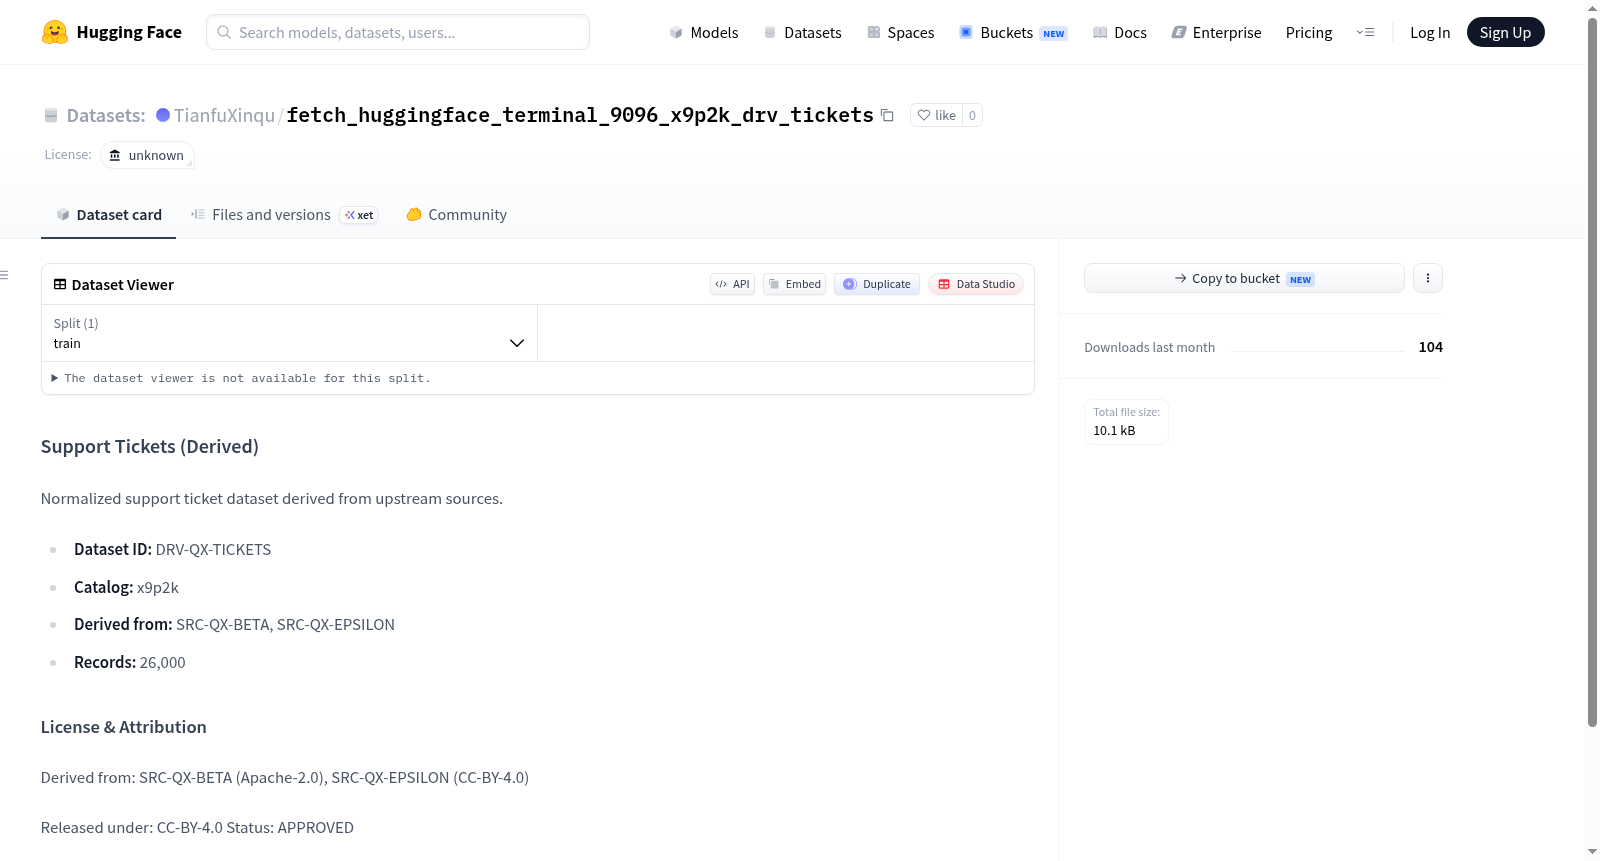
该数据集是一个派生的标准化支持工单数据集,来源于两个上游数据集(SRC-QX-BETA和SRC-QX-EPSILON)。包含26,000条记录,采用CC-BY-4.0许可证发布。数据集ID为DRV-QX-TICKETS,目录为x9p2k。该数据集适用于支持工单分类、分析、情感分析等自然语言处理任务。
This dataset is a derived standardized support ticket dataset, sourced from two upstream datasets (SRC-QX-BETA and SRC-QX-EPSILON). It contains 26,000 records and is released under the CC-BY-4.0 license. The dataset ID is DRV-QX-TICKETS, and the directory is x9p2k. This dataset is suitable for natural language processing tasks such as support ticket classification, analysis, and sentiment analysis.
创建时间:
2026-08-12
原始信息汇总
Support Tickets (Derived) 数据集概述
基本信息
- 数据集ID: DRV-QX-TICKETS
- 目录: x9p2k
- 记录数量: 26,000条
- 许可证: unknown(元数据中标注),但实际发布许可为CC-BY-4.0
数据来源
该数据集为派生数据集,由以下上游数据源规范化处理而来:
- SRC-QX-BETA(许可:Apache-2.0)
- SRC-QX-EPSILON(许可:CC-BY-4.0)
内容说明
- 本数据集是支持工单(Support Tickets) 的规范化版本,由上游来源数据整理衍生而成。
- 状态标记为APPROVED(已批准),表明数据已通过审核流程。
许可与归属
- 发布许可: CC-BY-4.0
- 上游数据归属: 分别遵循Apache-2.0和CC-BY-4.0许可协议,派生数据在CC-BY-4.0条款下发布。
搜集汇总
数据集介绍
构建方式
本数据集为支持工单数据的规范化衍生版本,源自上游两个独立数据源SRC-QX-BETA与SRC-QX-EPSILON的融合与清洗。构建过程遵循标准化流程,对原始工单记录进行字段归一化、去重及质量校验,最终形成包含26,000条记录的高质量数据集。其数据目录标识为x9p2k,数据集编号为DRV-QX-TICKETS,确保了在数据生态中的唯一性和可追溯性。
特点
该数据集继承了双数据源的互补特性,兼具Apache-2.0与CC-BY-4.0许可的兼容性,并在统一的CC-BY-4.0许可下发布,状态为APPROVED,确保了合法合规的使用性。数据经过规范化处理,消除了源数据中的格式异构性,提升了字段一致性与可分析性,适用于跨域支持工单的模式挖掘、趋势分析及自动化处理模型的训练,为智能化客户服务研究提供了坚实的数据基础。
使用方法
使用者可直接通过数据集标识符DRV-QX-TICKETS在HuggingFace平台进行访问与加载,亦可通过API按需获取。建议研究人员依据CC-BY-4.0许可条款,在学术或商业场景中灵活调用该数据。鉴于数据已高度结构化,可无缝接入主流机器学习流程,用于工单分类、优先级预测及响应时间预估等任务,同时需注意遵守许可协议中的署名要求。
背景与挑战
背景概述
该数据集名为fetch_huggingface_terminal_9096_x9p2k_drv_tickets,是一个经过标准化处理的支持工单数据集,由上游数据源派生而来。其创建时间可追溯至HuggingFace平台上的最新发布,主要研究机构或团队未明确标注,但数据集的ID(DRV-QX-TICKETS)和目录(x9p2k)暗示其可能源于某个特定的数据管理项目。该数据集的核心研究问题在于支持工单的规范化处理与集成,旨在提升客户服务领域的自动化分析能力。其从SRC-QX-BETA(Apache-2.0许可)和SRC-QX-EPSILON(CC-BY-4.0许可)两个上游源派生,记录了26,000条工单数据,并通过CC-BY-4.0许可发布,确保了数据的合法共享与使用。该数据集的发布对支持工单领域的文本挖掘、情感分析和问题分类等研究具有重要的推动作用,为相关应用提供了标准化的数据基础。
当前挑战
该数据集面临的挑战包括领域问题和构建过程两个方面。在领域问题方面,支持工单数据通常具有非结构化、多语言、高噪声等特点,且工单类别多样,涉及技术故障、账单问题、产品咨询等,使得自动分类和优先级判断成为难点。此外,工单文本常包含俚语、缩写和错误拼写,增加了自然语言处理的难度。在构建过程中,挑战主要源于上下游数据源的异构性:SRC-QX-BETA和SRC-QX-EPSILON可能采用不同的格式、字段定义和标注体系,需要进行充分的清洗、对齐和归一化处理,以确保数据的一致性和完整性。同时,数据源的许可协议不同(Apache-2.0与CC-BY-4.0),在合并时需确保合规性,并最终以CC-BY-4.0发布,这一过程对版权归属和合规审查提出了严格要求。此外,面对26,000条记录,如何保证数据质量、去除重复项、处理缺失值,以及保护用户隐私,也是构建过程中的重要课题。
常用场景
经典使用场景
该数据集作为一份经过标准化处理的客服工单语料,在自然语言处理与文本挖掘领域具有广泛的应用前景。其核心使用场景聚焦于工单的自动分类、情感分析、主题建模以及紧急程度预测等任务。研究者可借助其丰富的文本字段与标签信息,构建高效的文本分类器,以精准识别用户诉求的类别与优先级。此外,该数据集亦适用于训练对话生成模型,用于自动回复生成或知识库检索,从而提升客服系统的智能化水平。其规范化的结构也为跨语言迁移学习与多任务学习提供了坚实的实验基础。
实际应用
在实际应用中,该数据集直接赋能企业级客服系统的智能化升级。企业可基于此训练智能工单分诊模型,实现客户问题的自动归类与优先级排序,显著缩短响应时间并优化资源分配。同时,通过情感分析功能,系统能实时感知客户情绪,辅助人工坐席优先处理高风险对话,提升客户满意度。进一步地,该数据还可用于构建知识库驱动的问题推荐引擎,为客服人员提供即时解决方案,或赋能用户自助服务门户,实现常见问题的即时解答,从而有效降低运营成本并提升服务效率。
衍生相关工作
围绕该数据集,衍生出了一系列推动技术边界的工作。在文献中,已有研究基于此数据集构建工单摘要生成模型,利用序列到序列框架产出简洁的工单概要,辅助管理层快速把握问题核心。另有工作将元学习策略应用于少样本工单分类,极大提升了模型对新类别或新兴问题的适应能力。此外,该数据集也常被用作预训练语言模型(如BERT)领域自适应微调的基准,验证其在垂直领域的效果增益。这些衍生工作不仅深化了对客服场景的理解,也为后续研究提供了方法论上的启发与参照。
以上内容由遇见数据集搜集并总结生成
相关数据集

暂无相关数据集


