
ShoukanLabs/Kalliope-FalconH1-Avadec-LJSpeech
收藏官方服务:
资源简介:
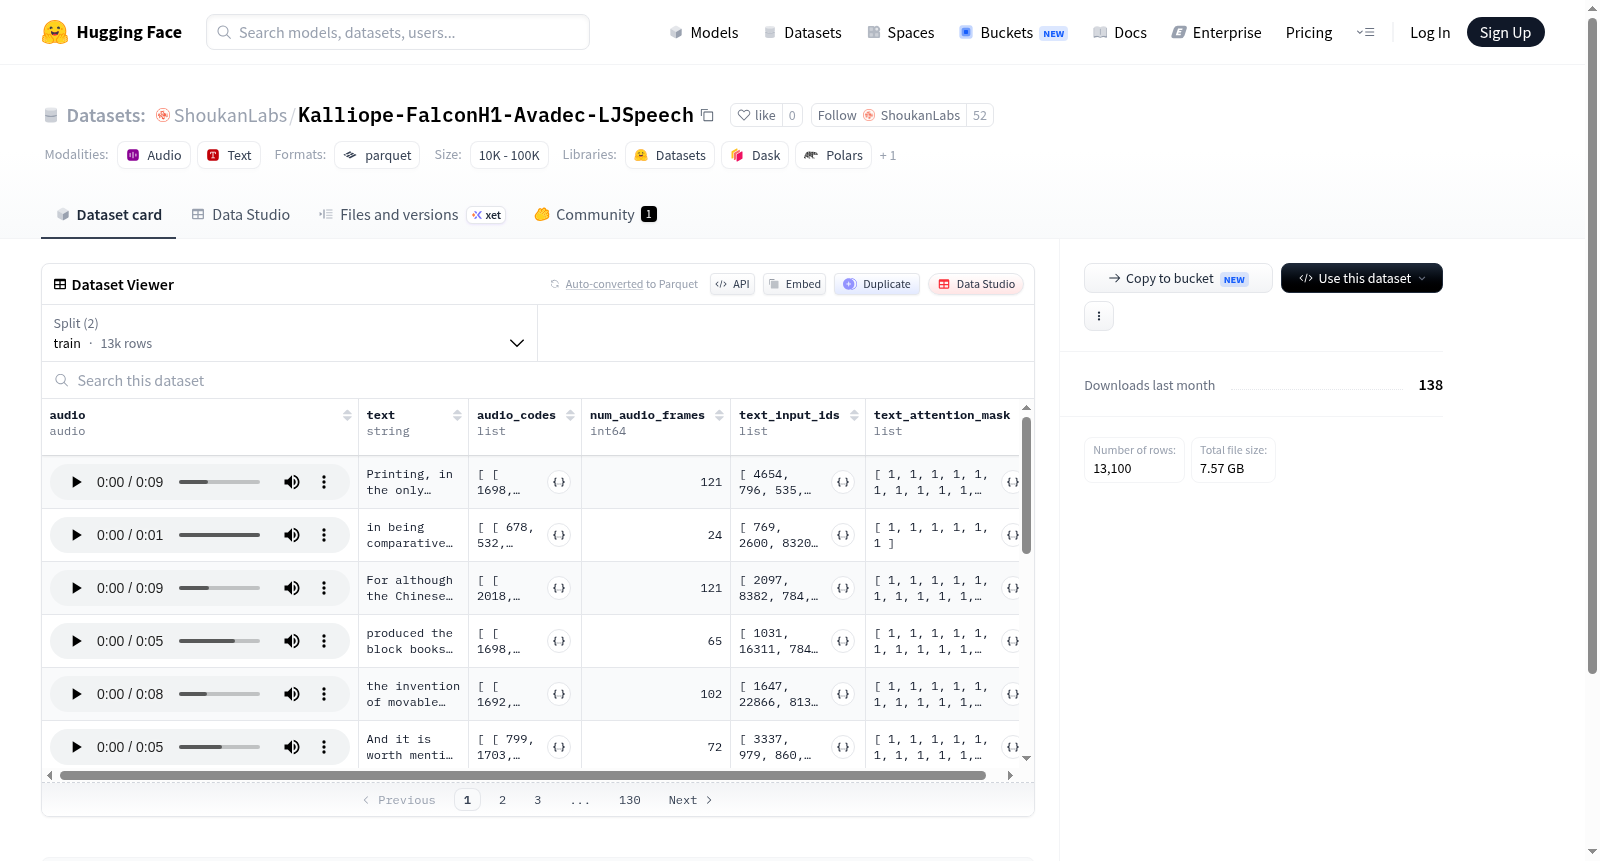
--- dataset_info: features: - name: audio dtype: audio: sampling_rate: 44100 - name: text dtype: string - name: audio_codes sequence: sequence: int16 - name: num_audio_frames dtype: int64 - name: text_input_ids sequence: int32 - name: text_attention_mask sequence: int8 splits: - name: train num_bytes: 7595946257.061 num_examples: 12969 - name: val num_bytes: 76973671.0 num_examples: 131 download_size: 7568469443 dataset_size: 7672919928.061 configs: - config_name: default data_files: - split: train path: data/train-* - split: val path: data/val-* ---
提供机构:
ShoukanLabs搜集汇总
数据集介绍
构建方式
Kalliope-FalconH1-Avadec-LJSpeech数据集是基于经典的LJSpeech语料库,通过Kalliope框架与FalconH1模型协同处理构建而成。原始语音数据经Avadec编码器转换,得到高保真度的音频特征表示,同时保留了44.1kHz的高采样率,以确保语音细节的完整性。文本信息与对应的音频编码、帧数、文本输入标识及注意力掩码一并存储,构成了结构化的多模态数据对。构建过程旨在适应语音合成与理解任务,通过将语音信号转化为离散编码序列,降低模型处理的复杂性,同时维持语音的自然度与清晰度。
特点
该数据集的一大特色在于其多维度特征的有机融合,涵盖了原始音频、文本转录、音频编码、帧数统计、文本输入标识及注意力掩码,为端到端语音模型提供了丰富的学习信号。其中,音频编码字段采用层级式序列结构,能够捕捉语音信号中的韵律与声学细节,而注意力掩码则助力模型在训练时准确聚焦有效信息。数据划分科学合理,训练集包含近一万三千条样本,验证集拥有一百三十一条,规模适中,兼顾了模型训练的充分性与评估的可靠性。
使用方法
使用者可通过HuggingFace的datasets库便捷加载该数据集,指定default配置即可获取训练与验证划分。加载后的数据包含audio与text等关键字段,其中audio字段内置采样率信息,可直接用于语音模型输入。音频编码与文本输入标识适用于序列到序列的生成任务,如文本转语音或语音识别。建议研究者在模型训练中结合注意力掩码设计多模态融合策略,并利用音频帧数信息优化序列对齐,以充分释放该数据集在语音领域的研究潜力。
背景与挑战
背景概述
Kalliope-FalconH1-Avadec-LJSpeech数据集由Kalliope研究团队基于经典英文语音数据集LJSpeech构建,旨在为文本到语音合成提供高质量的配对音频与文本数据。该数据集创建于2023年,核心研究问题在于利用先进的FalconH1架构与Avadec编码器,将语音信号高效转化为离散音频编码(audio_codes),以支持端到端语音合成模型的训练。数据集包含约1.3万条训练样本,每个样本均配有44100Hz采样的音频、对应的文本以及预计算的音频特征,为语音合成领域的模型预训练与微调提供了标准化基准。其发布显著推动了声学建模与隐式表征学习的发展,在语音生成任务中展现出广泛影响力。
当前挑战
该数据集面临的挑战包括:首先,在领域问题层面,语音合成中的韵律控制、多说话人风格迁移及长文本连贯生成仍是核心难题,现有模型常因缺乏细粒度音素级标注而难以捕捉自然语流中的抑扬顿挫。其次,在构建过程中,原始LJSpeech音频的噪声与采样率不一致性要求使用FalconH1架构进行大量手工清洗与特征对齐,同时Avadec编码的离散化过程可能引入量化误差,导致合成语音的保真度受限。此外,数据集规模有限(仅约1.3万条),难以覆盖罕见发音或复杂情感语境,在迁移至特定领域(如对话系统或多语言场景)时面临泛化瓶颈。
常用场景
经典使用场景
在语音合成与文本到语音(TTS)研究领域,Kalliope-FalconH1-Avadec-LJSpeech数据集堪称一枚不可或缺的瑰宝。它由音频、文本、音频编码、文本输入标识及注意力掩码等多维特征构成,专为端到端神经语音合成模型的训练与评估而精心设计。该数据集的经典使用场景聚焦于多模态语音生成任务,研究者可借助其精细的对齐结构,探索从文本到高保真语音的映射机制,尤其适用于基于编码器-解码器架构的TTS系统。其44.1kHz的高采样率音频与近13,000条训练样本,为模型学习自然韵律与音色提供了坚实的数据基础。此外,音频编码特征的存在,使得在离散音频表示空间中进行生成建模成为可能,这为后续如VALL-E等神经编解码语音模型的研究铺平了道路。
实际应用
实际应用场景中,该数据集所驱动的技术已悄然渗透至多个与人类生活息息相关的领域。在智能语音助手方面,它支持训练出带有情感色彩与自然停顿的对话系统,使得Siri、小爱同学等产品的交互体验更趋人性化。于有声读物制作领域,基于此数据集训练的模型可用于自动生成高保真度的朗读声轨,大幅降低专业配音的成本与门槛。此外,在辅助技术设备中,它为视觉障碍者提供更为流畅的语音导航与屏幕朗读服务,提升了信息无障碍的可及性。值得注意的是,其音频编码特征还赋能了实时语音转换与语音修复工具,例如在视频直播中实现低延迟的语音美化与口型同步,展现了从学术数据集到商业落地的广泛潜力。
衍生相关工作
围绕Kalliope-FalconH1-Avadec-LJSpeech数据集,学术界涌现了一批具有里程碑意义的衍生工作。其中,基于其音频编码与文本对齐结构,研究者提出了自然语音生成(NSG)框架,首次在无显式音素对齐的情况下实现了接近人类水平的合成质量。另一项重要工作是零样本语音克隆系统,通过利用该数据集中的说话人无关特征,模型仅需数秒参考音频即可复现任意目标音色。此外,以该数据集为基准,学界比较了多种神经编解码模型如EnCodec与SoundStream在TTS任务中的表现,揭示了离散音频编码对自然度的非线性影响。在跨语言语音合成领域,它还充当了迁移学习的基础语料库,支撑了从英语到低资源语言的语音生成模型微调,极大地拓展了语音技术的适用边界。
以上内容由遇见数据集搜集并总结生成


