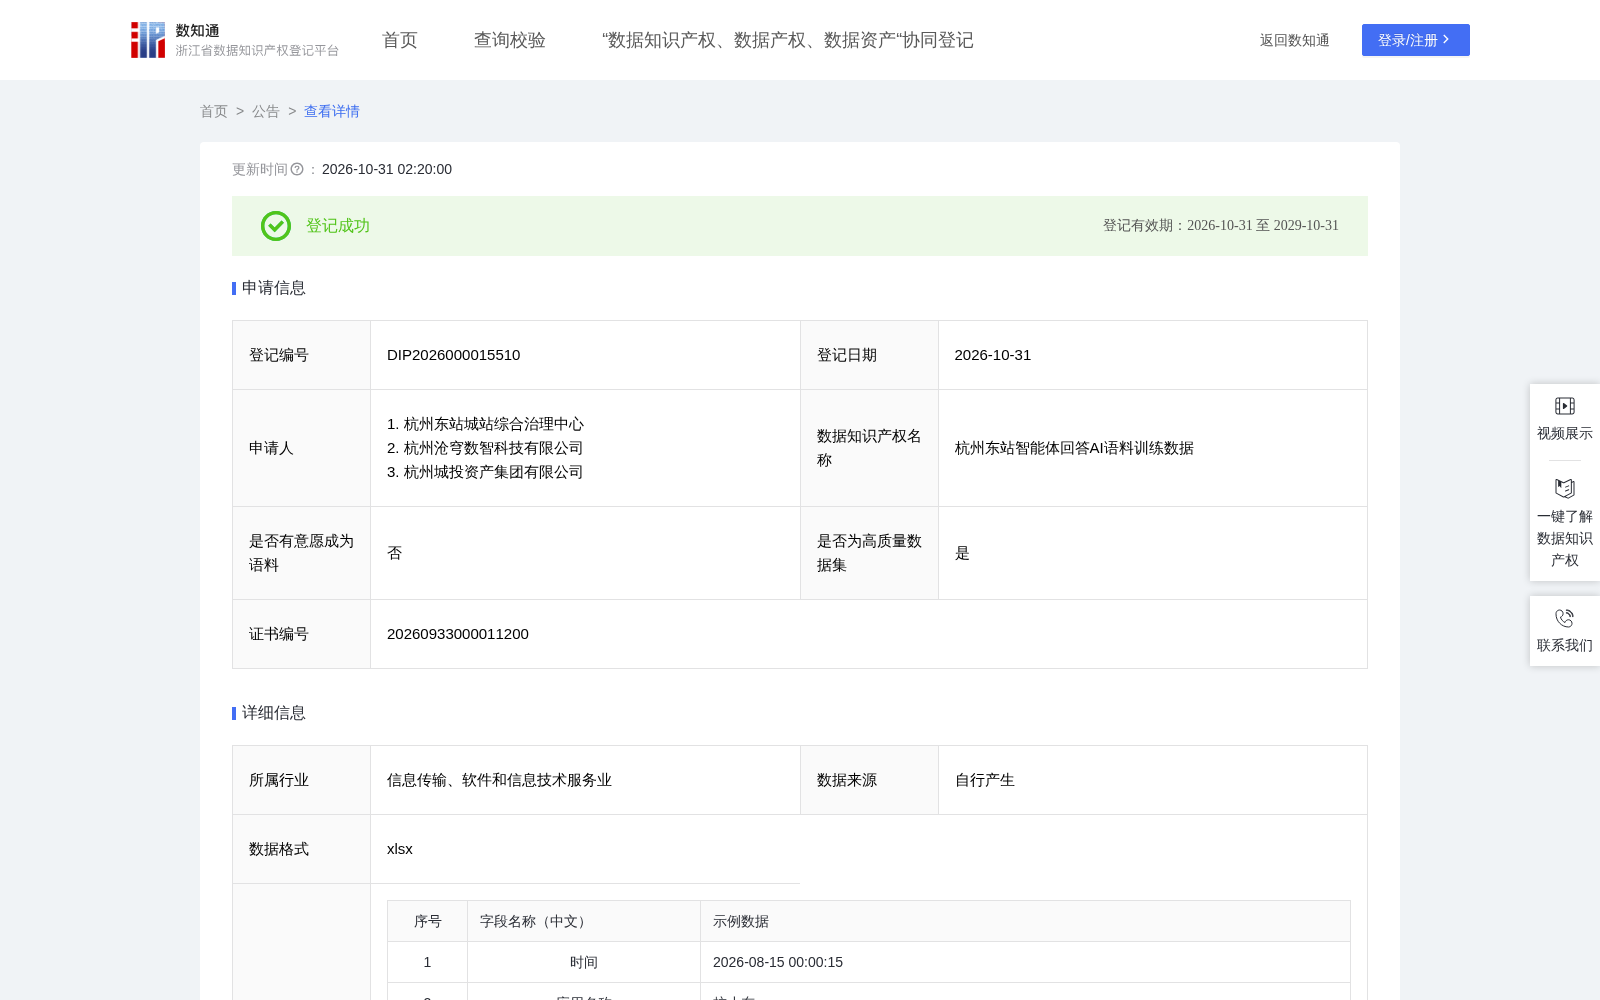
杭州东站智能体回答AI语料训练数据
收藏资源简介:
该数据用于训练杭州东站交通枢纽垂直领域专业大语言模型,使其深入掌握旅客出行咨询、站内导航、公共交通接驳、网约车与出租车调度、列车信息解读及周边配套等场景的专业术语与服务流程,显著提升智能客服在交通枢纽场景的专业问答能力。该语料可赋能智慧车站旅客服务系统升级,为杭州东站及全国同类枢纽提供高质量微调数据,支撑构建高准确性、高规范性的全天候自动咨询与引导服务,降低客服人力成本,提升旅客出行效率。同时,数据集可为科研机构及AI开发商提供稀缺的枢纽垂直领域标注资源,支撑意图分类、动态信息语义对齐、多轮对话管理等核心技术研发,推动智慧交通行业标准建立。此外,基于对海量旅客真实问询的学习,模型能够精准理解旅客在到达换乘、出发候车、接送指引及应急求助等方面的个性化需求,为开发下一代智能出行助手提供核心支撑,实现精准、及时的全流程出行陪伴与引导服务。一、加工前的数据说明:杭小东智能体真实问答数据的来源,包括用户每次输入的问题和杭小东智能体输出的答案。 二、数据清洗:剔除无效数据,统一问答格式,为算法模型构建提供规整数据输入,将回答中的第一个"{"和最后一个"}",中间的内容删除,只保留对话输出的部分。三、问题分类:利用NLP自然语言处理方法,精准分析问题和回答,首先对问题进行分词,如果问题中包含“G,g,车票,车厢,车厢,5车,4车,3车,2车,1车,6车,7车,8车,9车,0车,车次,换乘”,那就是乘车指南类别;如果问题中包含“网约车,浙A,地铁,出站口,进站口,浙a,出租车,大巴,停车场,电梯,怎么去,怎么到,打车,几号线”,那就是路线导航类别,不满足条件的就是其他问题。4、回答质量判断:在乘车指南类别中,根据专家设计的标准答案,先建立词库,包含"车次","车厢","站台","候车","请","可以","检票口","到达","出发","分钟",将答案进行jieba分词,如果包含词库里的数量大于等于三个,就是回答完整,否则回答缺失;同样建立路线导航词库,包括"上车点","米","分钟","建议","优先",将路线导航类别中的杭小东智能体输出的答案进行分词,与词库中重叠大于等于三个,就是回答完整,否则回答缺失;其他问题中可能包含一些旅游攻略、应急情况咨询等等,用回答长度和分词相结合判断,回答长度得30个字,建立的词库包含"因为","所以","例如","可以","需要",分词后与词库中大于等于一个词重叠,就为回答完整,否则为回答缺失。五、数据内容:将原始问题与经过算法加工生成的多维标注数据,形成结构化的杭小东智能体AI训练数据集,为杭小东智能体更精准的回答乘客问题,解决乘客需求提供依据。