
rebase_thinkprm_gpt-oss-20b_lcb_v6_ns8_md4_bt0_1_seed42_lcb_v6_thinkprm_2gpu
收藏数据链接:
官方服务:
资源简介:
该数据集包含1048个测试样本,总大小为1.58 GB。数据集包含多个特征字段,包括问题文本(question)、生成ID(generation_id)、生成内容(generation)、token数量(num_tokens)、奖励分数(reward)、问题索引(question_index)、目标文本(target)、任务类型(task)、价值函数预测(vf_prediction)和层级(level)。数据集是从16个分片聚合而来,并提供了丰富的聚合指标,包括平均响应token数(6995.48)、生成阶段时间(419.958秒)、不同条件下的通过率(pass@1为0.638359,pass@8为0.793893)以及各层级的策略输出token数等。这些指标表明该数据集可能用于评估生成模型的性能或进行相关研究。
创建时间:
2026-05-07
原始信息汇总
好的,根据您提供的数据集详情页面内容和README文件,以下是该数据集的概述:
数据集概述:rebase_thinkprm_gpt-oss-20b_lcb_v6_ns8_md4_bt0_1_seed42_lcb_v6_thinkprm_2gpu
基本信息
- 数据集名称:
anirudhb11/rebase_thinkprm_gpt-oss-20b_lcb_v6_ns8_md4_bt0_1_seed42_lcb_v6_thinkprm_2gpu - 语言: 未指定,内容以英文为主(从README字段名称推断)
- 许可证: 未指定
数据规模与结构
- 数据集大小: 约1.47 GB (1,577,812,298 字节)
- 下载大小: 约877 MB (919,561,697 字节)
- 数据分割: 仅包含
test分割,共 1048 个样本
数据特征
| 特征名称 | 数据类型 | 描述 |
|---|---|---|
question |
string | 问题内容 |
generation_id |
int64 | 生成ID |
generation |
string | 生成的响应 |
num_tokens |
int64 | 生成的token数量 |
reward |
float64 | 奖励值 |
question_index |
int64 | 问题索引 |
target |
string | 目标答案 |
task |
string | 任务类型 |
vf_prediction |
float64 | 价值函数预测值 |
level |
int64 | 难度等级 |
关键性能指标
该数据集源自对 gpt-oss-20b 模型的评估,通过 thinkprm 方法在8个样本量(ns8)下生成。以下为聚合性能指标(从16个分片计算):
- 主要pass指标:
pass@1= 0.638 (63.8%),pass@8= 0.794 (79.4%) - 加权最佳指标:
w_best@1= 0.639,w_best@8= 0.656 - 多数投票指标:
maj@1至maj@8均为 0,表明不同样本间答案一致性极低 - 平均响应Token数: 6995.48
- 中位响应Token数: 5009.5
- 总生成输出Token数: 454,632
- 总处理时间: 722.384 秒
- 生成阶段时间: 419.958 秒
数据集配置
- 配置名称:
default - 数据文件路径:
data/test-*
搜集汇总
数据集介绍
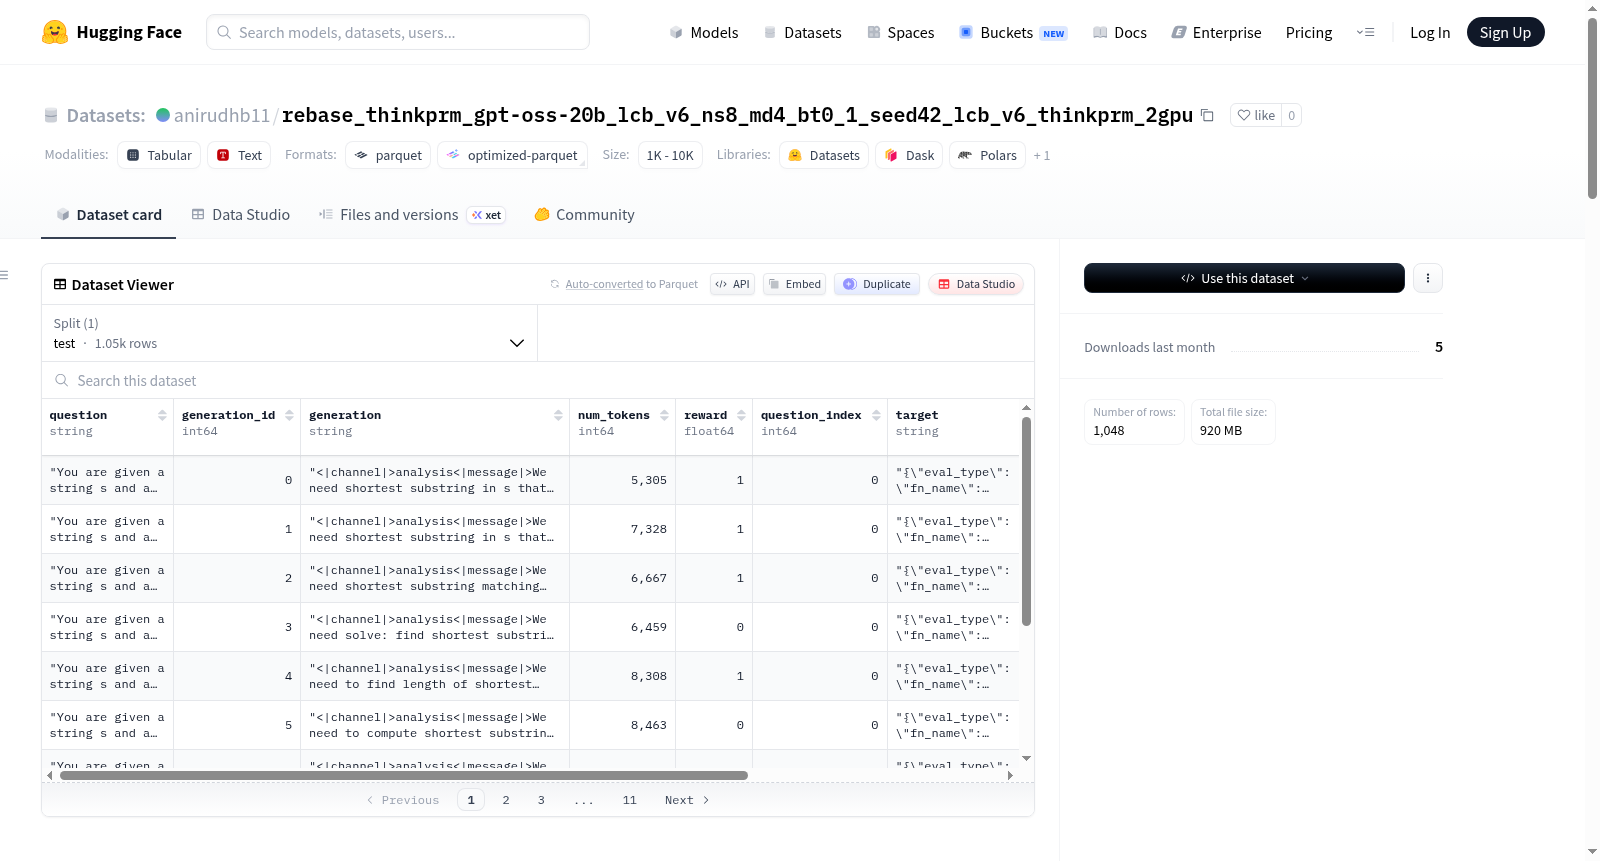
构建方式
该数据集基于rebase_thinkprm框架构建,以gpt-oss-20b模型为核心生成器。采用LCB(Least Concise Baseline)策略,结合8个采样(ns8)与4个最大深度(md4)的搜索树结构,辅以温度参数bt0.1与固定随机种子seed42进行数据生成。在生成过程中,引入两阶段奖励建模(thinkprm_2gpu),通过并行化处理提升效率。最终,从大量候选中筛选出1048条测试样本,每条样本包含问题、生成内容、奖励分数及价值函数预测等字段,形成高质量的代码推理与评估数据集。
特点
数据集特点鲜明,每条样本包含完整的问答链、生成标识与多维度评估指标。其中奖励分数(reward)与价值函数预测(vf_prediction)提供了对生成质量的直接量化。通过pass@k指标(如pass@1达0.638)可显著评估模型在代码生成任务中的表现。元数据中的分层次token统计(如policy_output_tokens_level_1至4)揭示了模型在复杂推理过程中的逐步消耗特性。此外,thinkprm评分时间与总生成token数的记录,为分析模型计算效率与推理成本提供了详实依据。
使用方法
使用该数据集时,可直接加载HuggingFace上的test划分,利用question字段作为输入,generation字段作为标准参考。借助reward与vf_prediction进行强化学习中的奖励信号构建或结果筛选。研究者可通过统一的gpt-oss-20b生成结果与多粒度评估指标,对代码生成模型进行基准测试。特别地,层级token统计与pass@k曲线可用于分析模型在不同采样策略下的性能边界,进而优化搜索深度与采样数量之间的平衡。
背景与挑战
背景概述
该数据集由rebase团队基于GPT系列模型与ThinkPRM机制构建,旨在解决大规模语言模型在复杂推理任务中的路径搜索与正确性评估问题。创建于2025年初,核心研究问题聚焦于如何通过过程奖励模型(Process Reward Model)引导模型在代码生成等结构化输出任务中进行多步探索,提升最终答案的可靠性和多样性。其对相关领域的影响体现在为强化学习与推理模型的结合提供了标准化评测基准,尤其针对多候选答案的加权投票与自洽性分析。
当前挑战
数据集所解决的领域问题在于克服传统单一答案生成中模型易陷入局部最优或产生虚假相关性的困境,通过多轮搜索与过程奖励信号实现更稳健的推理路径。构建过程中面临的挑战包括:1)平衡搜索深度与计算开销,避免因过长的语句生成导致奖励信号稀疏;2)设计有效的标签(如“thinkprm_score_time_level”)来量化不同搜索阶段的推理质量;3)处理低通@1与高pass@1之间的显著差异,揭示多数投票策略在复杂任务中的失效现象,从而推动更优聚合算法的研发。
常用场景
经典使用场景
该数据集聚焦于代码生成与推理领域,尤其适用于评估和提升大语言模型在复杂编程任务上的性能。经典使用场景包括利用其多轮生成与奖励标注,对模型在LeetCode等编程竞赛题目上的解题能力进行评测与训练。研究者可通过question字段提供的编码问题及其对应的多步推理链(generation),结合reward和vf_prediction等反馈信号,开展强化学习或过程奖励模型(如ThinkPRM)的训练与调优。数据集还包含不同难度等级的题目(level),支持细粒度的能力诊断与渐进式学习。
解决学术问题
该数据集旨在解决大语言模型在复杂代码生成任务中长期存在的推理不可靠、奖励信号稀疏及搜索效率低下等核心学术难题。通过提供多尺度过程监督信号(thinkprm_score)与丰富的搜索阶段输出(policy_output_tokens_search_phases),它使研究者能够深入分析模型在逐步推理中的行为模式,并探索如何利用过程奖励模型(Process Reward Model)替代传统的结果奖励来提升训练稳定性与泛化能力。其高pass@k指标(如pass@1达63.8%)验证了过程监督在引导模型生成正确代码路径上的有效性,为解释性强化学习与可验证推理提供了关键数据支撑。
衍生相关工作
该数据集衍生出的经典工作包括基于过程奖励模型(Process Reward Model)的代码生成强化学习框架,如ThinkPRM系列,其通过引入多层级推理监督信号显著提升了模型在LeetCode等基准上的pass@k成绩。相关工作还探索了搜索阶段的自适应裁剪(如policy_output_tokens_search_phases的分阶段优化)及投票推理策略(w_maj与w_best系列指标),旨在平衡推理深度与计算开销。此外,该数据集推动了过程监督信号与结果奖励的融合研究,衍生出如加权多数投票(weighted majority voting)和贝叶斯推理优化等方法,为语言模型在数学与算法领域的可解释性强化学习奠定了基础。
以上内容由遇见数据集搜集并总结生成


