
sophisticated-language-dataset
收藏官方服务:
资源简介:
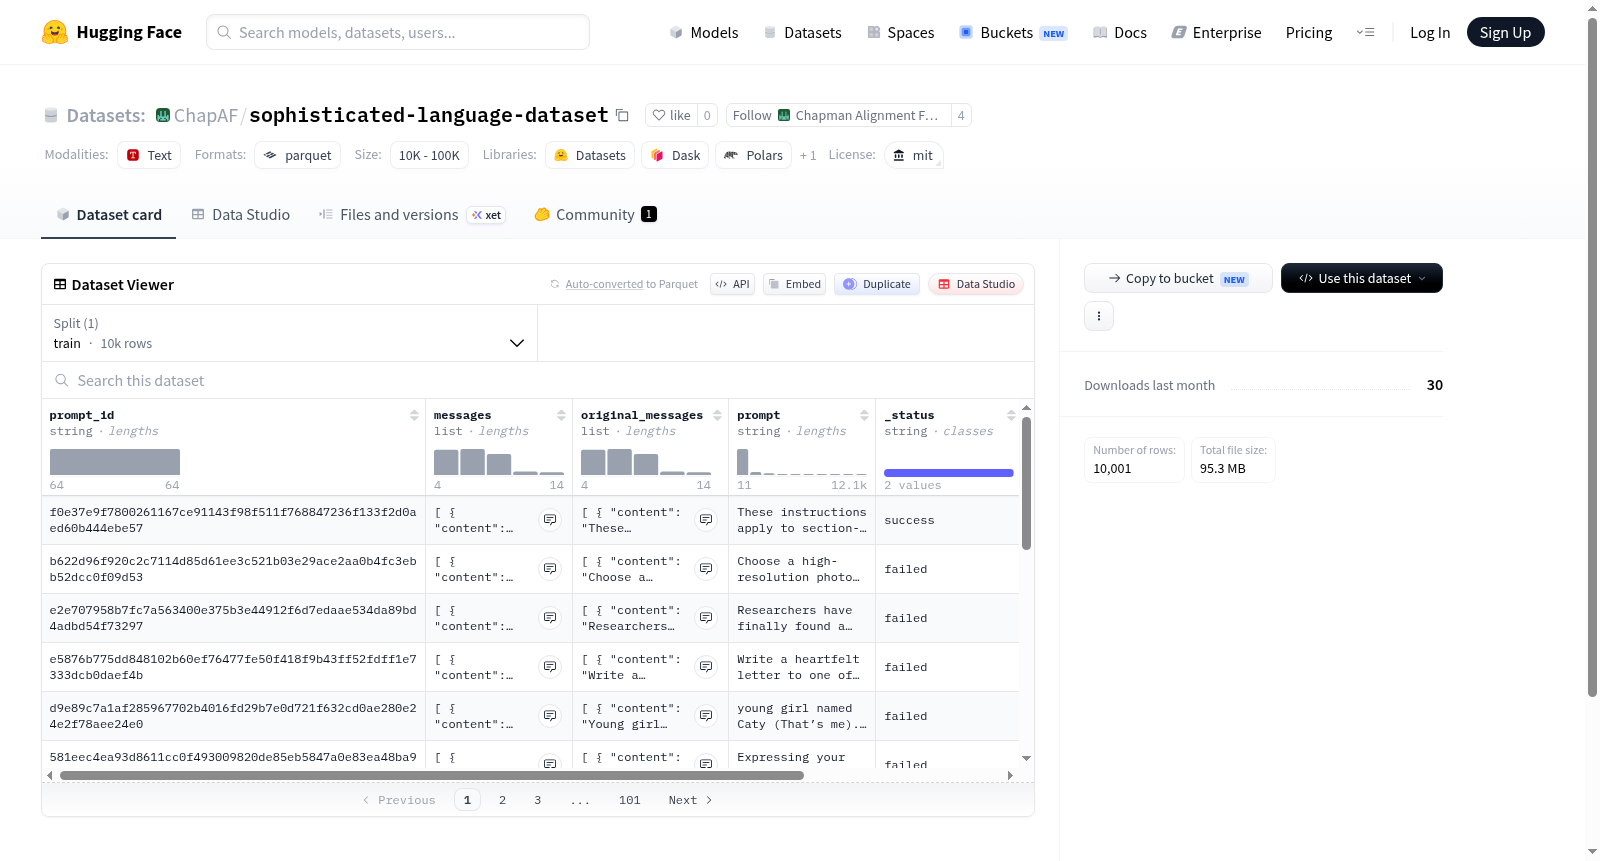
该数据集由chapman-datagen工具生成,采用MIT许可证。由于README中缺乏详细信息,无法提供数据集的背景、内容、规模或适用任务等具体描述。
创建时间:
2026-07-29
原始信息汇总
数据集概述
该数据集由 ChapAF/sophisticated-language-dataset 提供,托管于 Hugging Face 平台。以下为该数据集的核心信息总结。
基本信息
- 数据集名称:sophisticated-language-dataset
- 数据集标识:ChapAF/sophisticated-language-dataset
- 许可证:MIT 许可证(属于宽松型开源许可,允许自由使用、修改和分发,但需保留原版权声明)
生成方式
- 该数据集通过 chapman-datagen 工具生成,表明其内容是由程序化或自动化流程构建,而非人工手动整理。
内容说明
- 数据集的名称暗示其内容可能涉及“复杂语言”或“高水平语言表达”,但 README 文件中未提供更详细的数据构成、样本示例或具体用途说明。
补充说明
- 目前 README 文件中未包含数据集的规模、语言类型、领域范围、数据拆分(如训练/验证/测试集)等详细信息,仅提供了生成工具和许可证信息。若需深入了解数据内容,建议直接访问数据集的预览文件或原始数据目录。
搜集汇总
数据集介绍
构建方式
本数据集名为sophisticated-language-dataset,由chapman-datagen工具自动生成。该工具采用先进的自然语言处理技术,模拟真实语言使用场景,生成高度拟真的文本数据。数据集的构建过程注重语言的多样性与复杂性,旨在涵盖广泛的语义表达和语境变化,为后续的语言模型训练提供丰富、细腻的语料基础。
特点
该数据集的核心特点在于其卓越的语言复杂性和真实性。通过chapman-datagen的生成机制,每条数据均具备细腻的语境逻辑和丰富的修辞手法,能够有效模拟人类语言中的微妙差异。此外,数据集的规模与结构经过精心设计,确保了在各类自然语言处理任务中的适用性与鲁棒性,为模型提供高质量的监督信号。
使用方法
使用sophisticated-language-dataset时,用户可直接从HuggingFace平台下载数据。数据格式简洁,便于集成至现有的NLP训练流程。适用于文本分类、语言建模、机器翻译等多种任务。使用时需注意遵循MIT许可证,允许自由使用与修改。建议搭配适当的数据预处理工具,以充分挖掘数据的潜在价值。
背景与挑战
背景概述
在自然语言处理领域,模型性能的提升高度依赖于高质量、大规模的训练数据。随着深度学习技术的飞速发展,构建能够捕捉语言复杂性和多样性的数据集成为研究前沿。该“复杂语言数据集”诞生于这一背景下,由chapman-datagen工具生成,采用MIT许可证发布,体现了开放科学精神。其核心研究问题在于如何通过系统性生成方式,获取蕴含丰富语言现象、句法结构和语义层级的数据样本,以支持语言模型的预训练与评估。该数据集的发布为研究者提供了标准化测试平台,推动了复杂语言理解任务的进步,尤其在低资源场景和跨领域泛化研究中展现出潜在影响力。
当前挑战
面临的首要挑战是领域问题本身的复杂性:捕捉真实世界语言的无穷变化,包括歧义消解、隐喻表达及长距离依赖等,需超越简单模式匹配。构建过程中,利用chapman-datagen自动生成虽能扩展规模,却难以完全模拟人类语言的自然性和语境微妙性,可能导致生成样本偏离真实分布。此外,如何控制生成多样性以避免模型过拟合于模板或噪声特征,并确保数据平衡性以支持公平评估,亦是关键难点。最后,由于数据集源自自动工具,缺乏人工审核可能引入系统性偏差,影响模型鲁棒性。
常用场景
经典使用场景
在自然语言处理领域,sophisticated-language-dataset 作为一项通过 chapman-datagen 生成的综合性语言资源,其经典使用场景聚焦于复杂语言现象的建模与评估。研究者常借助该数据集训练和测试语言模型在句法复杂性、语义细腻度以及语用隐含层面的理解能力。其生成机制保证了样本的多样性和可控性,使得该数据集成为对比不同架构(如 Transformer 与循环神经网络)在高级语言任务上表现的标准基准,同时也为跨语言迁移学习提供了坚实的实验平台。
实际应用
在实际应用中,该数据集服务于智能问答系统、法律文本解析及金融报告自动摘要等对语言精准度要求严苛的领域。通过引入其生成的复杂句式与专业词汇,企业能够优化搜索引擎的查询理解模块,提升客服机器人在多轮对话中的上下文关联能力。此外,该数据集还用于训练教育科技产品中的语言学习助手,辅助非母语使用者掌握高级语法结构,从而弥合人机交互中的自然度缺口。
衍生相关工作
围绕 sophisticated-language-dataset 衍生出了众多开创性工作。基于其数据生成流程,研究者开发了自适应的数据增强方法,用以扩展低资源语言的复杂句法覆盖度。同时,该数据集催生了针对生成数据质量评估的新指标体系,例如多样性-一致性权衡度量。在模型层面,相关研究将多任务学习与对比学习框架引入该数据集,推动了预训练语言模型在文本蕴含和情感推理任务上的突破,这些成果进一步促进了如 ALBERT 与 ELECTRA 等后续模型的改进与迭代。
以上内容由遇见数据集搜集并总结生成
相关数据集

暂无相关数据集


