遇见数据集

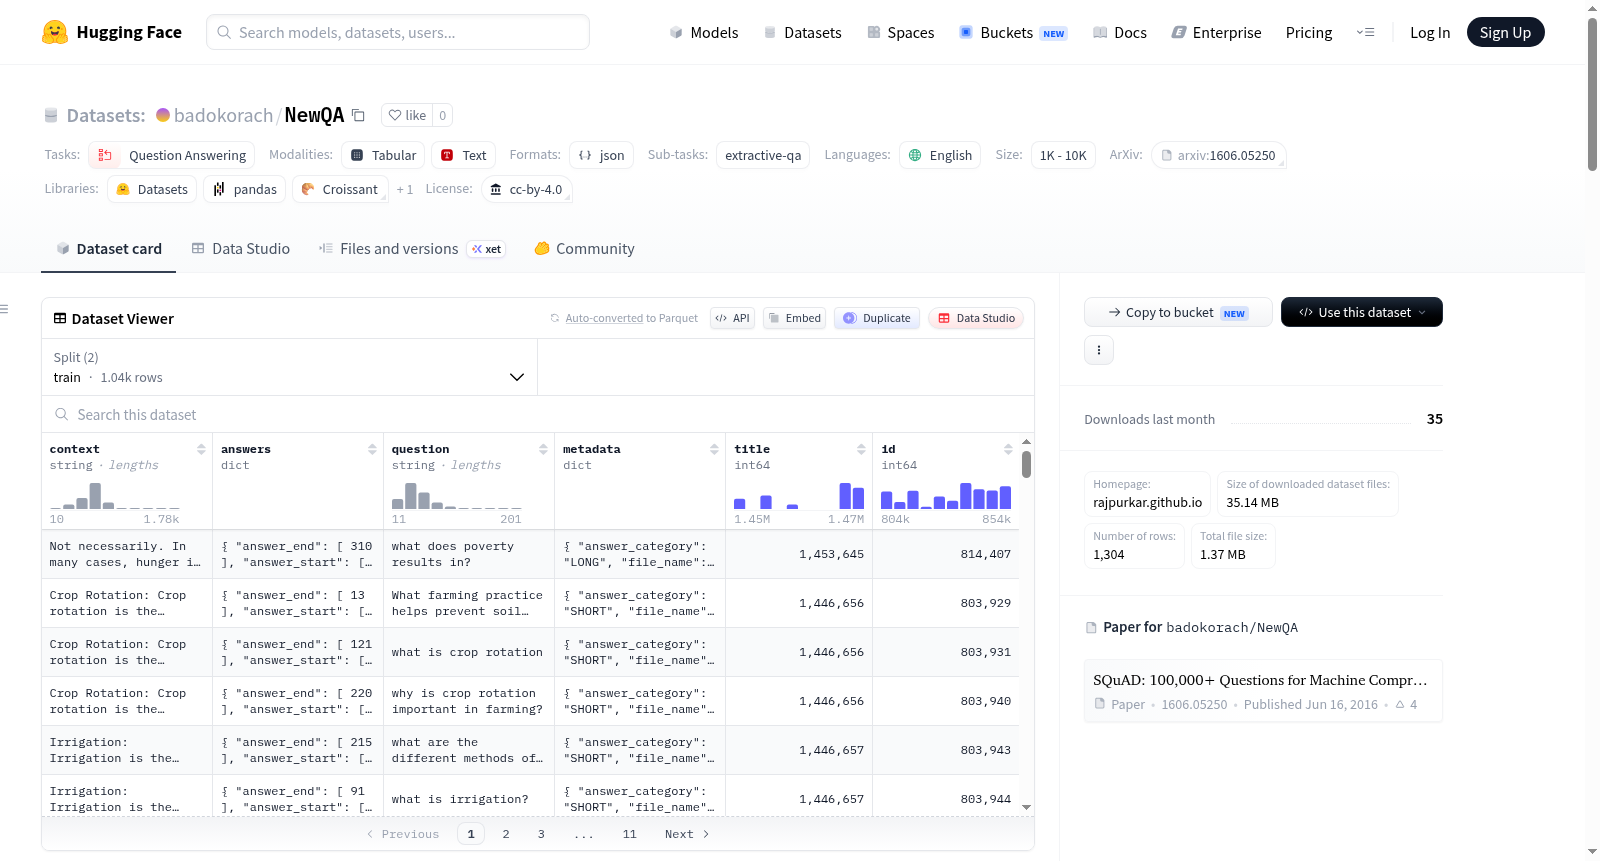
badokorach/NewQA

收藏
Hugging Face2023-07-25 更新2024-03-04 收录
官方服务:

资源简介:

斯坦福问答数据集(SQuAD)是一个阅读理解数据集,由众包工作者在维基百科文章上提出问题,每个问题的答案是对应阅读段落中的一段文本,或者问题可能无法回答。数据集包含训练集和验证集,分别有87599和10570个样本。数据集的字段包括id、title、context、question和answers,其中answers包含text和answer_start两个子字段。数据集的大小为35.14 MB,生成的数据集大小为89.92 MB,总磁盘使用量为125.06 MB。

Stanford Question Answering Dataset (SQuAD) is a reading comprehension dataset where crowdworkers create questions based on Wikipedia articles. Each question's answer is either a text span from the corresponding reading passage, or the question may be unanswerable. The dataset includes a training set and a validation set, with 87,599 and 10,570 samples respectively. Its fields cover id, title, context, question and answers, where answers contains two sub-fields: text and answer_start. The raw dataset has a size of 35.14 MB, the generated dataset has a size of 89.92 MB, and the total disk usage amounts to 125.06 MB.

提供机构:
badokorach
原始信息汇总

数据集概述

数据集名称

  • 名称: SQuAD

数据集创建

  • 标注创建者: 众包
  • 语言创建者: 众包和现有资源

语言信息

  • 语言: 英语
  • 多语言性: 单语种

许可信息

  • 许可证: CC-BY-4.0

数据集大小

  • 大小分类: 10K<n<100K

数据源

  • 源数据集: 扩展自维基百科

任务类别

  • 任务类别: 问答
  • 任务ID: 抽取式问答

训练与评估索引

  • 配置: plain_text
  • 任务: 问答
  • 任务ID: extractive_question_answering
  • 分割:
    • 训练分割: train
    • 评估分割: validation
  • 列映射:
    • 问题: question
    • 上下文: context
    • 答案:
      • 文本: text
      • 答案开始位置: answer_start
  • 评估指标:
    • 类型: squad
    • 名称: SQuAD

数据集信息

  • 特征:
    • id: 字符串类型
    • title: 字符串类型
    • context: 字符串类型
    • question: 字符串类型
    • answers:
      • 文本: 字符串类型
      • 答案开始位置: int32类型
  • 配置名称: plain_text
  • 分割:
    • 训练:
      • 字节数: 79317110
      • 示例数: 87599
    • 验证:
      • 字节数: 10472653
      • 示例数: 10570
  • 下载大小: 35142551字节
  • 数据集大小: 89789763字节
搜集汇总
数据集介绍
badokorach/NewQA 数据集图片
构建方式
在自然语言处理领域,机器阅读理解任务长期面临高质量标注数据匮乏的困境。NewQA数据集(基于SQuAD框架构建)的诞生正是为了填补这一空白,其构建过程严谨而系统。该数据集以维基百科文章为原始语料,通过众包平台招募标注人员,要求他们针对每篇文章的特定段落提出自然语言问题,并从原文中精确标注出答案所在的文本片段(即答案跨度)。每个问题均对应一个上下文段落,答案以文本及其起始位置的形式记录,确保了答案的可追溯性和精确性。最终,数据集被划分为训练集(87,599条)和验证集(10,570条),形成了规模适中、结构清晰的基准资源。
特点
NewQA数据集在阅读理解领域展现出多项卓越特性。其核心优势在于任务的抽取式问答属性,要求模型从给定上下文中定位连续文本片段作为答案,这极大提升了评估的客观性与可复现性。数据集覆盖了维基百科中广泛的主题,保证了内容多样性与领域平衡性。每条样本均包含问题、上下文、答案文本及起始位置,结构简洁而信息完整。此外,数据通过众包方式采集,问题由人工生成,自然语言表达丰富且贴近真实用户查询,有效避免了自动生成数据可能带来的语义偏差。这些特质使NewQA成为评估模型文本理解与信息定位能力的黄金标准。
使用方法
NewQA数据集的使用高度标准化,便于集成到各类问答系统中。用户可通过HuggingFace Datasets库直接加载,指定配置名'plain_text'即可获取训练与验证分割。数据以字典形式组织,包含'id'、'title'、'context'、'question'和'answers'字段,其中'answers'为嵌套字典,内含'text'(答案字符串)与'answer_start'(答案在上下文中的字符起始索引)。在模型评估时,推荐采用SQuAD官方评估指标,通过计算精确匹配(Exact Match)和F1分数来衡量预测答案与真实答案的重叠程度。该数据集广泛适用于微调预训练语言模型、训练抽取式问答系统及开展阅读理解基准测试。
背景与挑战
背景概述
在自然语言处理领域,机器阅读理解能力的评估一直是研究的热点与难点。斯坦福大学于2016年由Pranav Rajpurkar、Jian Zhang、Konstantin Lopyrev和Percy Liang等人创建的SQuAD数据集,即斯坦福问答数据集,正是为了填补这一领域大规模、高质量评估基准的空白。该数据集基于维基百科文章,由众包工作者针对文章内容提出问题和对应的答案片段,旨在推动机器从文本中精确提取信息的能力。SQuAD的问世不仅为抽取式问答任务提供了标准化的测试平台,还催生了众多基于深度学习的先进模型,极大地促进了自然语言理解技术的发展,成为该领域最具影响力的基准之一。
当前挑战
SQuAD数据集所面临的挑战是多层面的。首先,在领域问题层面,其核心任务在于解决机器对自然语言文本的精确理解与信息定位,即从给定上下文中准确抽取出与问题相关的连续文本片段,这要求模型具备对语义、句法和上下文逻辑的深度把握。其次,在构建过程中,挑战体现在数据标注的一致性和质量把控上,如何确保众包工作者提出的问题具有多样性和合理性,以及答案标注的精确性,是一个巨大难题。此外,数据集中的答案片段往往依赖于上下文中的具体表述,缺乏对同义替换、推理型问题以及不可回答问题的充分覆盖,这限制了模型泛化能力和鲁棒性的提升。
常用场景
经典使用场景
在自然语言处理领域,机器阅读理解任务一直是衡量模型语义理解与推理能力的重要试金石。SQuAD数据集作为该领域的标杆性资源,其经典使用场景聚焦于抽取式问答任务,即给定一段来自维基百科的文章作为上下文,模型需精准定位并抽取其中连续文本片段作为问题的答案。这一设定不仅考验模型对长文本的编码与信息检索能力,更对其在复杂语义环境下对答案起止位置的精确预测提出了严苛要求。学术界与工业界普遍采用该数据集对预训练语言模型(如BERT、RoBERTa)进行微调与评估,从而推动模型在细粒度文本理解上不断突破。
实际应用
在实际应用层面,SQuAD数据集所驱动的抽取式问答技术已广泛渗透至智能客服、知识检索与教育辅助等场景。例如,企业可利用基于该数据集微调的模型构建自动问答系统,从产品文档或知识库中快速提取用户问题的精准答案,显著提升服务效率。在搜索引擎领域,该技术被用于优化片段摘要生成,使用户能够直接获取信息而非遍历多个网页。此外,教育科技平台借助此类模型实现自动化的阅读理解评测,辅助学生进行文本分析与练习,展现了从学术研究到产业落地的完整价值链条。
衍生相关工作
SQuAD数据集作为机器阅读理解领域的基石,衍生了众多具有深远影响力的经典工作。其中,BERT模型通过在SQuAD 1.1上取得显著性能提升,开创了预训练-微调范式在自然语言处理中的主导地位。后续的RoBERTa、ALBERT等模型进一步优化了训练策略与架构设计,持续刷新该基准上的记录。此外,SQuAD 2.0版本通过引入不可回答的问题,直接催生了针对模型置信度校准与拒答能力的研究。在数据集层面,NewsQA、Natural Questions等大规模问答数据集均借鉴了SQuAD的构建方法论,共同推动了阅读理解技术的多元化发展。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务