SearchGen-Bench
收藏资源简介:
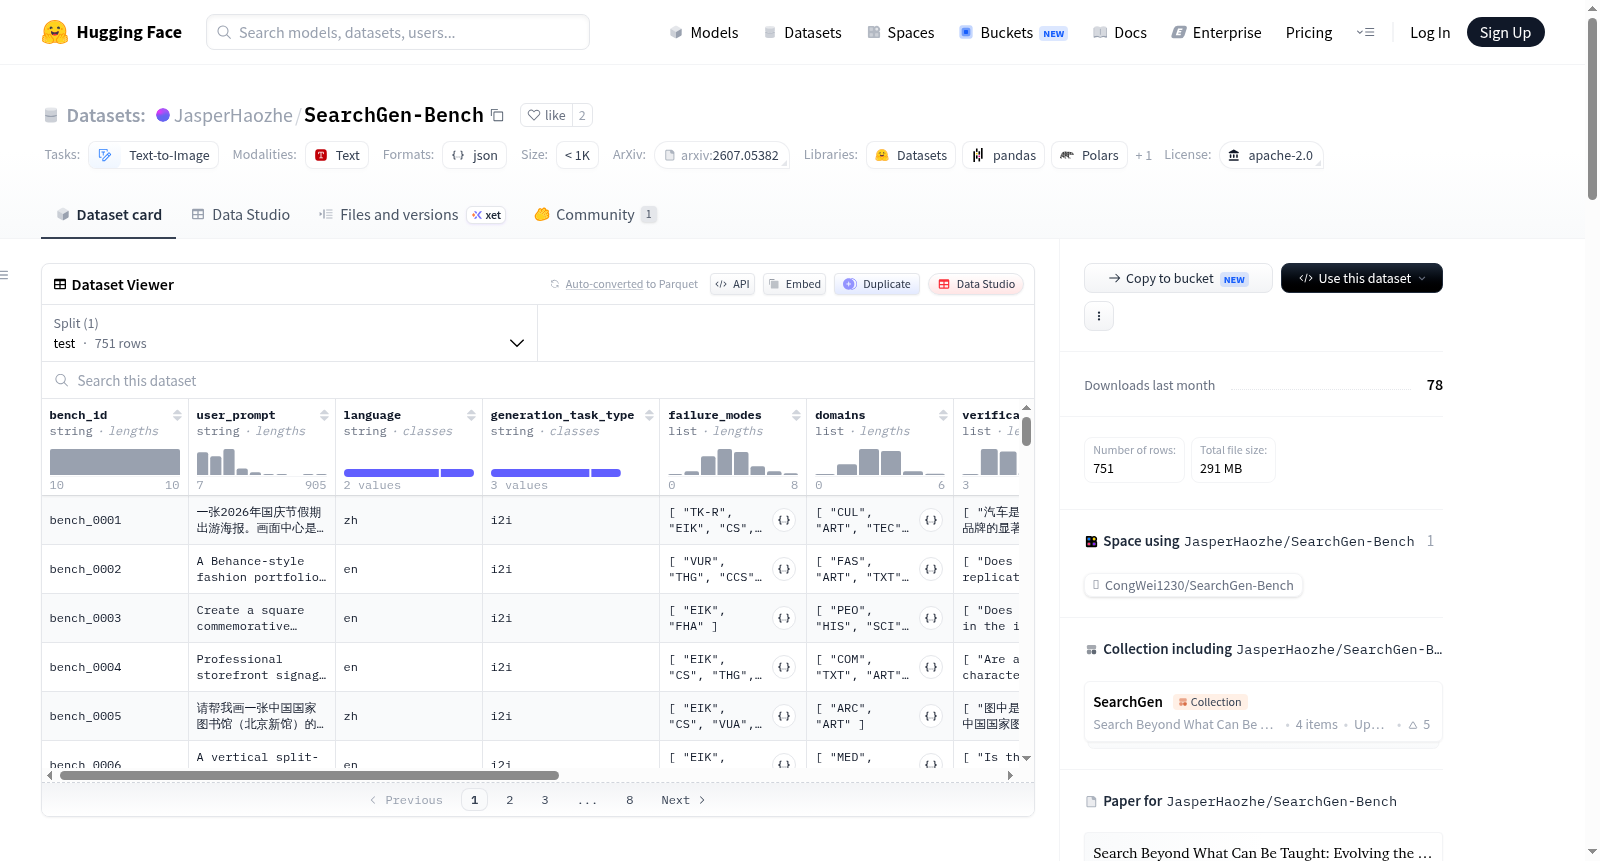
SearchGen-Bench 是一个用于评估图像生成系统的基准数据集。它包含独立的 SearchGen 基准提示和相关的参考元数据,旨在评估那些包含显式视觉参考、文本知识槽、验证清单和评估标准的图像生成提示。数据集规模包括 751 个基准提示和 1,099 张视觉参考图像。主要数据文件为 `eval_metadata.jsonl`,其中每条记录包含以下字段:`bench_id`(基准ID)、`user_prompt`(用户提示)、`language`(语言)、`generation_task_type`(生成任务类型)、`failure_modes`(失败模式)、`domains`(领域)、`verification_checklist`(验证清单)、`evaluation_rubric`(评估标准)、`text_knowledge_slots`(文本知识槽)和 `visual_reference_slots`(视觉参考槽)。视觉参考图像通过 `visual_reference_slots[].relative_path` 字段指向本地路径。此外,数据集还提供了 `eval_query_coverage.jsonl` 文件,用于将基准参考槽与 SearchGen-Corpus-1M 数据集中的查询进行关联。该数据集与训练数据集 SearchGen-20K 分离,专门用于评估目的。
SearchGen-Bench is a benchmark dataset for evaluating image generation systems. It contains independent SearchGen benchmark prompts and related reference metadata. The dataset is designed to evaluate image generation prompts that include explicit visual references, text knowledge slots, verification checklists, and evaluation criteria. The dataset scale includes 751 benchmark prompts and 1,099 visual reference images. The main data file is `eval_metadata.jsonl`, where each record contains the following fields: `bench_id` (benchmark ID), `user_prompt` (user prompt), `language` (language), `generation_task_type` (generation task type), `failure_modes` (failure modes), `domains` (domains), `verification_checklist` (verification checklist), `evaluation_rubric` (evaluation rubric), `text_knowledge_slots` (text knowledge slots), and `visual_reference_slots` (visual reference slots). Visual reference images are pointed to local paths via the `visual_reference_slots[].relative_path` field. Additionally, the dataset provides an `eval_query_coverage.jsonl` file to associate benchmark reference slots with queries in the SearchGen-Corpus-1M dataset. This dataset is separated from the training dataset SearchGen-20K and is specifically for evaluation purposes.
数据集名称:SearchGen-Bench
概述
SearchGen-Bench 是一个独立的基准测试提示集,用于评估图像生成系统在需要显式视觉参考和文本知识槽场景下的表现。该数据集专为评估设计,与训练数据集分开。
数据集统计
| 项目 | 数量 |
|---|---|
| 基准测试提示 | 751 |
| 视觉参考图像 | 1,099 |
主要文件
eval_metadata.jsonl:基准测试提示元数据。benchmark_manifest.json:基准测试计数、模式字段和参考图像策略。eval_query_coverage.jsonl:从基准测试参考槽到searchgen-corpus-1m查询的覆盖映射。
数据模式
eval_metadata.jsonl 中每行包含以下字段:
bench_iduser_promptlanguagegeneration_task_typefailure_modesdomainsverification_checklistevaluation_rubrictext_knowledge_slotsvisual_reference_slots
其中 visual_reference_slots[].relative_path 指向基准测试本地的参考图像路径,路径相对于 data_release/searchgen-bench/。所有 1,099 张基准测试参考图像的预期最终文件布局为:
data_release/searchgen-bench/reference_images/{bench_id}/ref_00.jpg
交叉引用
eval_query_coverage.jsonl通过query_id将基准测试参考槽链接到../searchgen-corpus-1m/database/search.sqlite(当存在匹配的搜索语料库查询时)。- 训练数据集是独立的,记录在
../searchgen-20k/README.md中。
许可证
Apache-2.0
任务类别
文本到图像生成(text-to-image)
引用
如果您觉得该数据集有用,请引用:
@article{wang2026searchgen, title = {Search Beyond What Can Be Taught: Evolving the Knowledge Boundary in Agentic Visual Generation}, author = {Wang, Haozhe and Feng, Weijia and Yu, Jinpeng and Liu, Che and Nie, Ping and Lin, Fangzhen and Liu, Jiaming and Huang, Ruihua and Lin, Jimmy and Chen, Wenhu and Wei, Cong}, journal = {arXiv preprint arXiv:2607.05382}, year = {2026}, url = {https://arxiv.org/abs/2607.05382} }
联系方式
权利问题和删除请求请联系:jasper.whz@outlook.com