
lightonai/mgsm-rev2
收藏官方服务:
资源简介:
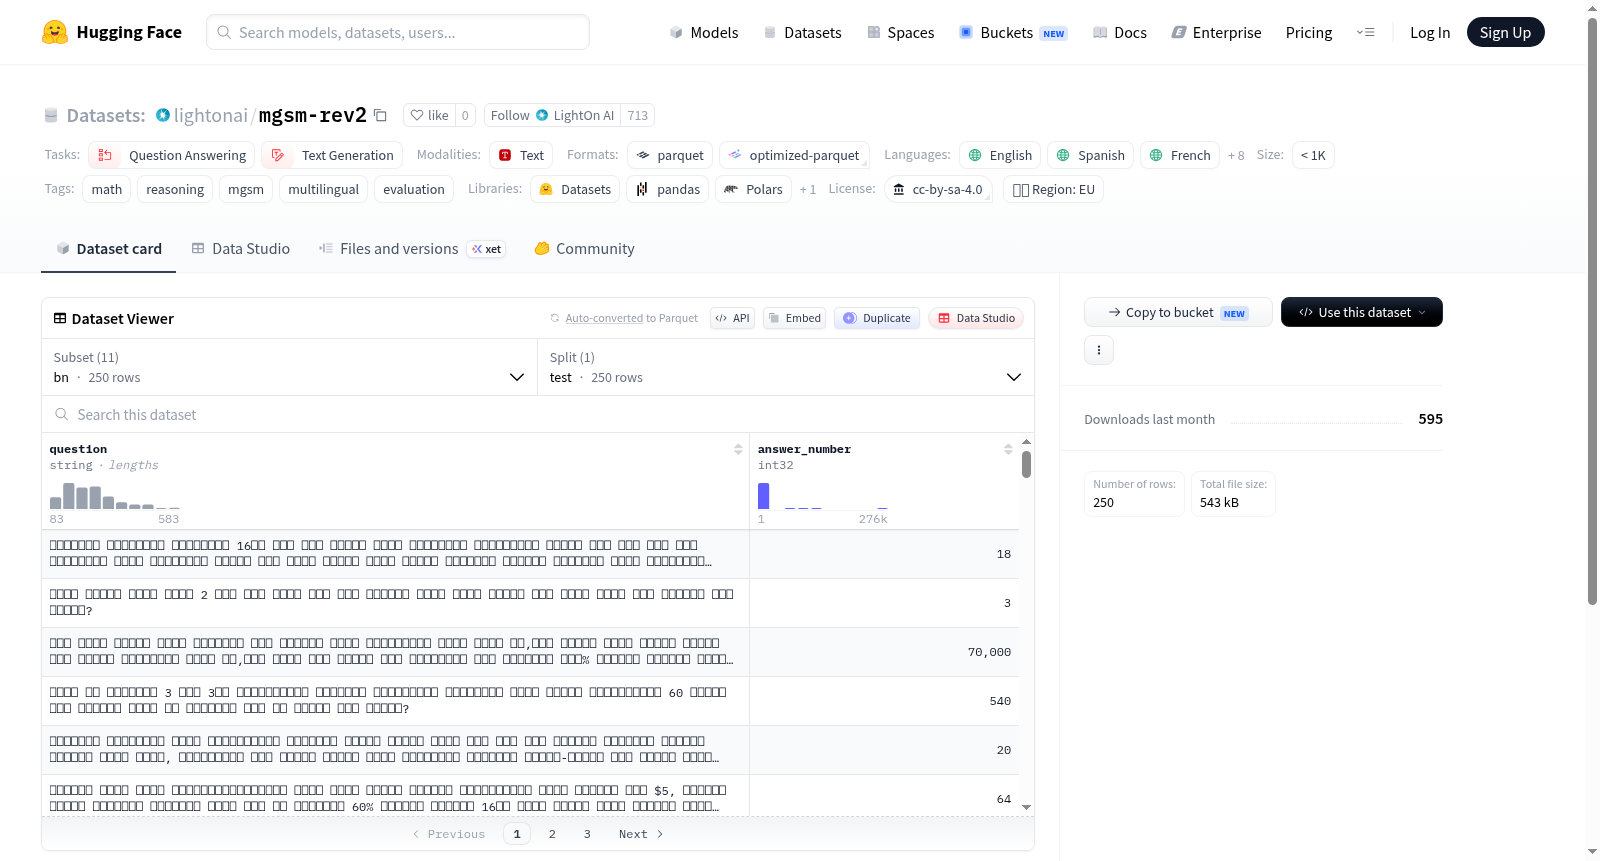
MGSM-Rev2是MGSM基准的修正版本,用于评估多语言数学推理能力,特别针对小学阶段的单词问题。该数据集覆盖10种语言,包括英语、西班牙语、法语、德语、俄语、中文、日语、泰语、斯瓦希里语、孟加拉语和泰卢固语,每个语言配置包含250个测试示例,问题以文本形式呈现,答案以数字形式提供。它旨在测试模型在跨语言环境下的数学问题解决能力,适用于问答和文本生成任务。
MGSM-Rev2 is a corrected version of the MGSM benchmark, which evaluates multilingual mathematical reasoning on grade-school word problems across 10 languages. It includes languages such as English, Spanish, French, German, Russian, Chinese, Japanese, Thai, Swahili, Bengali, and Telugu, with each language configuration containing 250 test examples. The dataset features text-based questions and numerical answers, designed to assess model performance in solving math problems in diverse linguistic contexts, suitable for question-answering and text-generation tasks.
提供机构:
lightonai搜集汇总
数据集介绍
构建方式
MGSM-Rev2数据集是在原始MGSM基准测试基础上精心修正的版本,专注于评估多语言环境下的小学数学推理能力。该数据集覆盖了英语、西班牙语、法语、德语、俄语、中文、日语、泰语、斯瓦希里语、孟加拉语和泰卢固语共10种语言,每种语言均包含250道数学应用题,总计2500个样本。每个样本由问题文本与对应的整数答案组成,构建过程中通过严谨的人工校验与自动化对齐,修正了原版数据集中存在的翻译误差与答案不一致问题,确保了跨语言评估的公平性与准确性。
特点
该数据集的核心特点在于其高度的多语言覆盖与数学推理的专注性。它涵盖了从印欧语系到汉藏语系、南岛语系等多样化的语言类型,为评估多语言大模型的数学推理能力提供了标准化的测试平台。每个子集保持250个样本的均匀规模,且所有问题均源自小学数学应用题,难度适中但需依赖多步逻辑推理。数据格式简洁统一,仅包含'question'与'answer_number'两个字段,便于直接用于评估模型的输出是否与预期整数答案匹配。
使用方法
研究者可通过HuggingFace Datasets库便捷加载该数据集,按语言配置(如'en'、'zh')选择特定子集。使用方法上,可将数据集作为测试基准,对多语言大模型进行零样本或少样本推理评估。典型流程包括:从指定语言配置中读取问题文本,输入模型生成答案,再与预存的整数答案进行精确匹配计算准确率。由于数据仅包含测试集,建议将其作为跨语言数学推理能力的标准化评估工具,而非训练数据使用。
背景与挑战
背景概述
MGSM-Rev2数据集诞生于对多语言数学推理能力评测需求日益增长的背景下,由Google Research团队于近期发布,旨在修正原始MGSM基准中存在的错误。该数据集聚焦于评估大语言模型在十种语言(英、西、法、德、俄、中、日、泰、斯瓦希里、孟加拉、泰卢固语)下处理小学级别数学应用题的能力。作为多语言推理领域的重要评测资源,MGSM-Rev2填补了非英语语言数学推理评估的空白,推动了对模型跨语言泛化能力的系统研究,为后续多语言AI系统的性能优化提供了关键基准。
当前挑战
MGSM-Rev2所应对的核心挑战在于:当前多数数学推理评测集中于英语,导致模型在多语言场景下的推理能力缺乏有效度量。具体而言,需解决跨语言数学问题表述差异带来的理解瓶颈,如不同语言对数量关系、运算步骤的刻画方式迥异。构建过程中的重大挑战包括原始MGSM数据集中的翻译错误和答案疏漏,为此团队进行了系统性修正与审核,确保每个语言子集250道题目的语义等价性与答案精确性,从而维护跨语言评测的公平性与可靠性。
常用场景
经典使用场景
MGSM-Rev2是一个面向多语言数学推理的基准评测数据集,其核心应用场景在于评估和对比不同语言模型在多语种环境下解决小学数学应用题的能力。该数据集覆盖英语、西班牙语、法语、德语、俄语、中文、日语、泰语、斯瓦希里语、孟加拉语和泰卢固语等十种语言,每种子语言均包含250道精心设计的测试题目,从而为研究者提供了一个兼具语言多样性与数学严谨性的评测平台。常见的用法是将该数据集作为测试集,在语言模型完成多语言训练或微调后,使用其衡量模型在跨语言数学推理方面的泛化表现。
解决学术问题
该数据集的推出有效回应了多语言推理领域中一个关键学术痛点,即现有数学推理基准多集中于英语场景,难以真实反映模型在非英语语言环境下的表现。MGSM-Rev2通过系统性地修正原始MGSM数据集中的翻译与逻辑瑕疵,提供了一套高置信度的评测标准。其意义在于,它使得研究者得以科学地考察大型语言模型在多语言、低资源语言环境中的推理一致性,进而揭示模型在语言迁移过程中潜藏的认知偏差与性能落差。这种跨语言评估框架的建立,对于推动多语言自然语言处理技术的均衡发展具有深远影响。
衍生相关工作
围绕MGSM-Rev2数据集,学术界已涌现出若干具有启发性的衍生研究工作。一些研究团队基于该数据集探索了多语言思维链(Chain-of-Thought)提示策略的有效性,验证了不同语言环境下提示模板对推理性能的影响。另有一些工作关注于低资源语言的数学推理能力增强,通过利用MGSM-Rev2作为评估基准,提出了基于代码切换(Code-Switching)或跨语言知识蒸馏的训练方法。此外,该数据集还催生了对语言模型在多语言环境中演绎推理一致性的批判性分析,为进一步构建更公平、更鲁棒的多语言推理系统奠定了实验基础。
以上内容由遇见数据集搜集并总结生成


