
遇见数据集

UniverseTBD/mmu_jwst_gds

收藏
Hugging Face2026-05-27 更新2026-03-29 收录
官方服务:

资源简介:

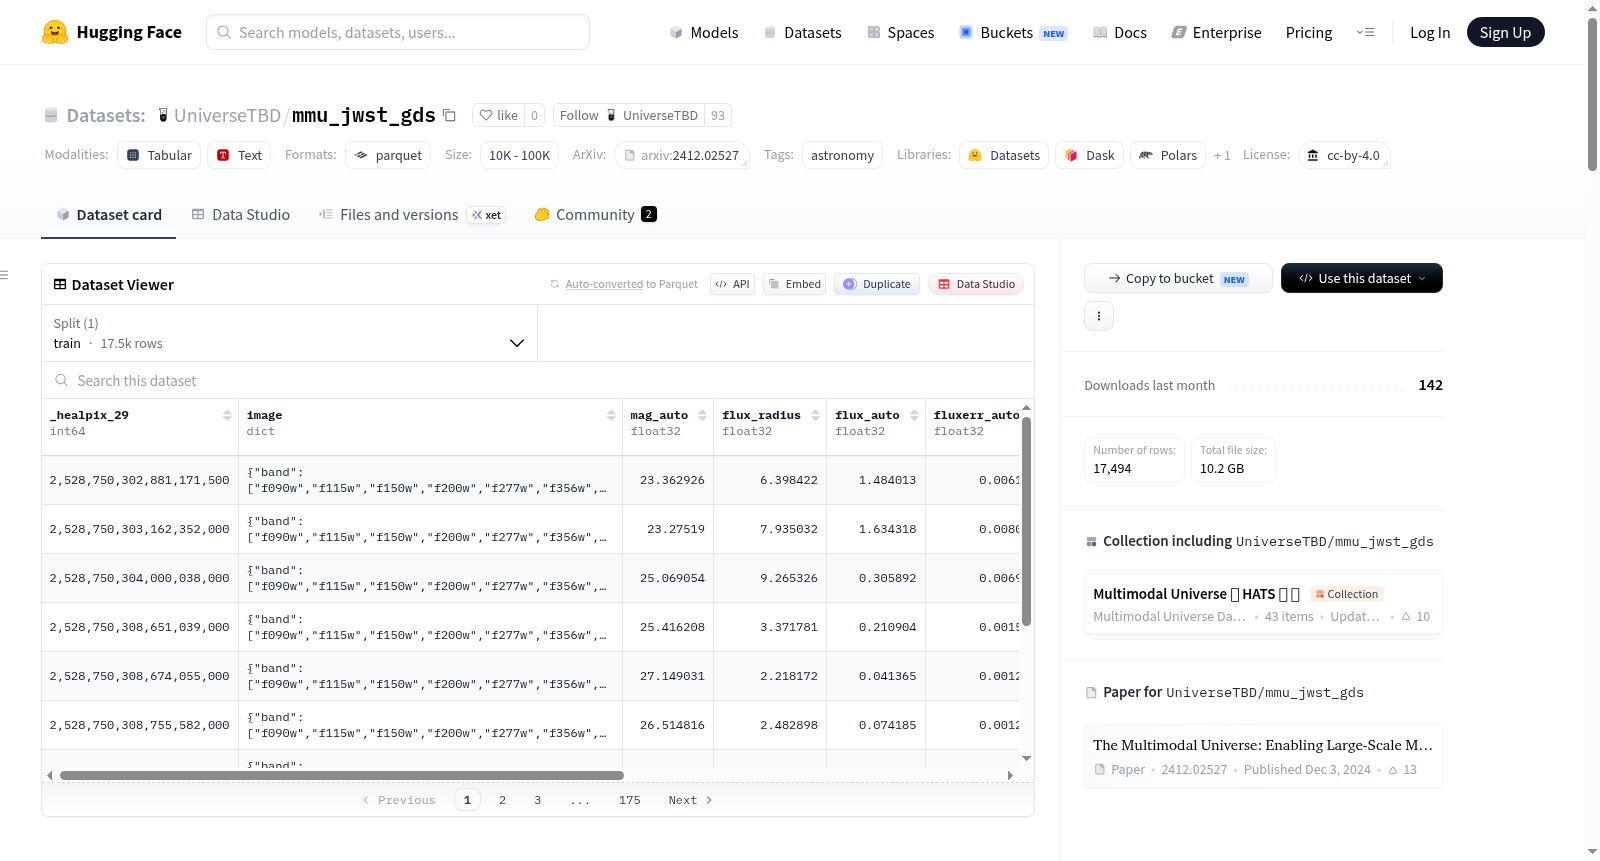
mmu_jwst_gds HATS目录集合是一个天文数据集,属于多模态宇宙项目的一部分,基于詹姆斯·韦伯太空望远镜(JWST)NIRCam的早期深场观测。数据集包含固定大小的图像切块(96×96像素),中心来自测光目录的源,图像是多波段的,具有6或7个滤镜,覆盖波长从约0.9μm到4.4μm。数据以HATS目录格式存储,使用Apache Parquet数据集,包含17,494行和11列,总大小约6.3 GiB。典型用例包括科学出版物和机器学习应用。注意事项:不同调查的波长覆盖可能不同,缺失波段用零数组表示以简化数据加载。数据来自Dawn JWST Archive (DJA)。

The mmu_jwst_gds HATS Catalog Collection is an astronomical dataset part of the Multimodal Universe project, based on James Webb Space Telescope (JWST) NIRCam observations from early deep field surveys. It consists of fixed-size image cutouts (96×96 pixels) centered on sources from photometric catalogs, with multi-band images covering 6 or 7 filters across wavelengths from approximately 0.9μm to 4.4μm. The data is stored in HATS catalog format as an Apache Parquet dataset, containing 17,494 rows and 11 columns, with a total size of about 6.3 GiB. Typical use cases include scientific publications and machine learning applications. Caveats: Different surveys have varying wavelength coverage, and missing bands are represented as arrays of zeros to simplify data loading. The data is sourced from the Dawn JWST Archive (DJA).
提供机构:
UniverseTBD
搜集汇总
数据集介绍
UniverseTBD/mmu_jwst_gds 数据集图片
构建方式
mmu_jwst_gds数据集是基于詹姆斯·韦伯空间望远镜(JWST)NIRCam早期深场巡天观测数据构建而成。该数据集以HATS(Hierarchical Astronomical Tiling System)目录格式组织,采用HEALPix分割策略将天球划分为多个分区,每个分区存储为独立的Apache Parquet数据集。核心目录包含17,494个天体的多波段图像切块(96×96像素),涵盖6至7个滤光片,波长覆盖0.9μm至4.4μm。为简化数据加载,缺失波段以零值数组填充。数据集还提供了10角秒的边际目录,以确保交叉匹配时的数据完整性。
特点
该数据集的核心特色在于其多模态与层次化结构。每个天体记录包含多波段图像数据(如通量、逆方差、掩膜)及源测量参数(如星等、通量半径),共计17列。图像的嵌套结构支持高效存储与访问。通过HEALPix分区,数据集可无缝集成至天文学分析管道,支持大规模并行处理。此外,数据集遵循CC-BY-4.0许可,作为Multimodal Universe项目的一部分,旨在推动机器学习在天文学中的应用,已发表于相关学术论文。
使用方法
推荐使用LSDB(Hierarchical Astronomical Tiling System的Python框架)访问该数据集。用户可通过`lsdb.open_catalog`方法加载全天空目录或指定锥形搜索区域(如中心坐标RA=53.0°, Dec=-28.0°,半径3600角秒)。数据集支持与其它HATS目录进行高效交叉匹配,示例代码使用`crossmatch`函数,匹配半径可设置为1角秒。此外,由于数据以Apache Parquet格式存储,开发者还可利用Pandas、PyArrow、Dask、DuckDB等工具直接读取,适用于多种科学计算与机器学习工作流。
背景与挑战
背景概述
自詹姆斯·韦伯空间望远镜(JWST)于2021年底发射升空以来,其近红外相机(NIRCam)获取的深场观测数据已成为天文学领域最具影响力的资源之一。mmu_jwst_gds数据集由多模态宇宙(Multimodal Universe)项目于2024年创建,依托DAWN JWST档案(DJA)的数据产品,汇聚了来自早期深场巡天的多波段图像切片(96×96像素,涵盖6至7个滤波波段,波长范围0.9至4.4微米)。该数据集以分层自适应四面体球面(HATS)格式组织,包含约17500个天体源的11列参数,旨在为大规模机器学习研究提供标准化、可交互的多模态天文数据,推动深度学习在天体分类、源检测等任务中的应用。
当前挑战
该数据集所应对的领域挑战在于:JWST深场图像中存在复杂的源重叠、非均匀噪声以及多波段信息缺失(如部分波段以零值填补),这要求机器学习模型具备鲁棒的特征提取与跨波段泛化能力。在构建过程中,研究团队面临将异构巡天数据统一为HATS格式的难题,需处理高达6.3GiB的磁盘数据、管理八分区的HEALPix空间索引,并设计边缘目录(10角秒容差)以确保交叉匹配的完整性。此外,多波段嵌套列(如flux、ivar)的高维结构(96×96像素网格)对数据加载和并行访问效率提出了严峻考验,需借助LSDB框架与Apache Parquet格式在避免内存溢出的前提下实现高效查询。
常用场景
经典使用场景
mmu_jwst_gds数据集作为詹姆斯·韦伯空间望远镜(JWST)近红外相机(NIRCam)深场观测数据的多模态整合成果,其经典使用场景集中于天文学领域的跨波段图像分析与星表交叉匹配。研究人员可借助LSDB框架高效加载HATS格式的星表,通过HEALPix分区策略快速检索固定大小(96×96像素)的多波段(6至7个滤光片,覆盖0.9至4.4微米)图像切块,开展星系形态分类、变源监测及高红移天体识别等任务。该数据集还支持基于空间位置的光度测量与星表星群关联,为理解早期宇宙结构演化提供了标准化的数据底座。
解决学术问题
该数据集精准回应当代天文学两大核心难题:一是大规模多波段观测数据的异构整合挑战,二是高效跨星表比对的算法瓶颈。通过将JWST深场原始图像转化为包含通量、逆方差、点扩散函数及形态参数的结构化星表,它解决了传统天文数据管理中格式碎片化与元数据不一致的问题。其HEALPix层级分区设计使得海量天文数据的空间查询复杂度从线性级降至对数级,显著提升了交叉匹配的精度与效率。这一贡献推动了机器学习在天文学中的落地,例如基于卷积神经网络的星系参数预测与异常检测,为自动化天文数据分析范式奠定了方法论基础。
衍生相关工作
围绕mmu_jwst_gds数据集已衍生出一系列影响深远的学术工作。在机器学习领域,基于该数据集的分类模型被用于JWST公开数据竞赛(如JWST Deep Field Source Classification Challenge),产出了多个可复现的星系参数预测框架。在天体物理方面,研究者通过分析其多波段通量分布与光变曲线,揭示了尘埃消光与恒星形成率之间的非线性关联,并校准了JWST滤光片系统的高红移适用范围。更广泛地,该数据集作为Multimodal Universe项目的核心组件,推动了跨模态天文数据联合分析的理论框架发展,包括光度-光谱联合嵌入与多信使天体识别等前沿方向。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

