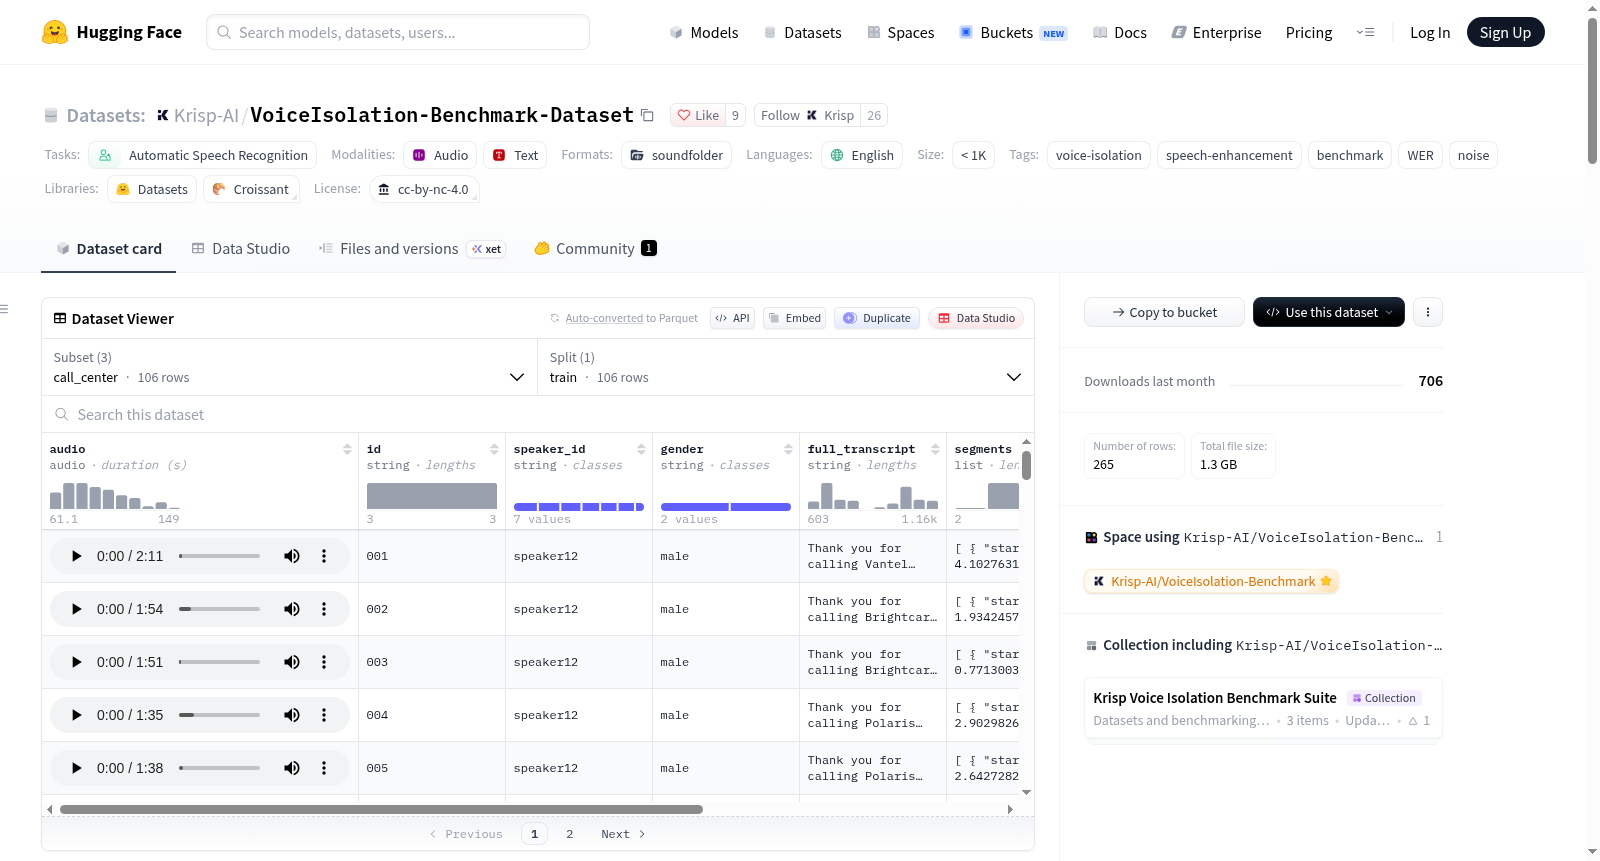
VoiceIsolation-Benchmark-Dataset
收藏资源简介:
Voice Isolation Benchmark Dataset是一个用于衡量语音隔离(Voice Isolation)技术对自动语音识别(ASR)性能影响的数据集。该数据集由Krisp团队录制,包含265个真实世界的录音,47位说话人,涵盖三种场景(工作环境、呼叫中心、电话通话),共65个脚本。所有录音均在真实环境中使用真实设备录制,无任何合成混合。数据集旨在评估当第二个说话人出现在麦克风附近时,语音转文字(STT)引擎的准确率下降情况,以及Krisp语音隔离技术对其的修复效果。录音结构通常遵循四段式脚本:主说话人开始、副说话人加入、主说话人静默而副说话人继续、主说话人重新加入。电话通话场景则仅包含主说话人,背景为环境噪音。每个录音均附带人工转录的文本(包含犹豫、重复等真实语音特征),以及时间戳分段标注(主说话人、混合、副说话人、噪音)。元数据包括文件名、唯一ID、说话人ID、性别、完整转录、分段信息、录制设备、环境等。电话通话场景额外提供手机型号和汽车型号(如果在车内录制)。音频格式为32kHz单声道16位PCM WAV。该数据集适用于语音隔离、语音增强、ASR鲁棒性评估等任务,也可用于参考无关的语音质量评估(如DNSMOS)。数据集许可为CC-BY-NC-4.0。
The Voice Isolation Benchmark Dataset is a dataset designed to measure the impact of voice isolation technology on automatic speech recognition (ASR) performance. Recorded by the Krisp team, it contains 265 real-world recordings from 47 speakers, covering three scenarios (work environment, call center, phone call), with a total of 65 scripts. All recordings are made in real environments using real devices, without any synthetic mixing. The dataset aims to evaluate the accuracy degradation of speech-to-text (STT) engines when a second speaker appears near the microphone, as well as the restoration effect of Krisps voice isolation technology. The recording structure typically follows a four-segment script: main speaker starts, secondary speaker joins, main speaker becomes silent while secondary speaker continues, and main speaker rejoins. The phone call scenario includes only the main speaker with background ambient noise. Each recording comes with manual transcriptions (including hesitations, repetitions, and other natural speech characteristics) and timestamped segment annotations (main speaker, mixed, secondary speaker, noise). Metadata includes file name, unique ID, speaker ID, gender, full transcription, segment information, recording device, environment, etc. For the phone call scenario, additional information such as phone model and car model (if recorded in a car) is provided. The audio format is 32kHz mono 16-bit PCM WAV. This dataset is suitable for tasks such as voice isolation, speech enhancement, ASR robustness evaluation, and also for reference-free speech quality assessment (e.g., DNSMOS). The dataset is licensed under CC-BY-NC-4.0.
Voice Isolation Benchmark Dataset
数据集概述
- 数据集名称:Voice Isolation Benchmark Dataset
- 发布方:Krisp Technologies, Inc.
- 许可证:cc-by-nc-4.0
- 任务类别:automatic-speech-recognition
- 语言:en
- 数据规模:n<1K
- 标签:voice-isolation、speech-enhancement、benchmark、WER、noise
数据集用途
该数据集用于测量第二人声如何影响语音转文本(STT),以及 Krisp Voice Isolation 能在多大程度上修复该问题。支持两类测量:
- STT 准确率:比较原始音频与经过 Voice Isolation 处理后音频的词错误率(WER)。
- 感知质量:在主要说话人讲话的片段上,比较处理前后的无参考语音质量(DNSMOS)。
该数据集并非排行榜,不用于对 STT 引擎进行排名。
数据集构成
- 共 265 条真实录音,涵盖 47 位说话人、3 种场景、65 个脚本。
- 全部为真实环境、真实设备录制,无合成混音。
- 提供三个配置:call_center(默认)、phone_calls、work,均为 test 划分。
记录结构
- 多数 Work 和 Call Center 录音遵循四步脚本:主要说话人开始 → 次要说话人加入 → 主要说话人静默、次要说话人单独继续 → 主要说话人重新加入。
- 每条录音包含四个标注片段,其中"secondary"片段为压力测试:该段正确的转写文本为空,而多数 STT 引擎仍会转写背景人声。
- Phone Calls 不遵循该结构,仅包含主要说话人,无刻意的第二人声,背景为环境嘈杂声与环境噪声,用于测试在失真、带限音频上的安全性。
三种场景
Work
- 96 条录音 · 29 位说话人 · 24 种设备 · 4 种房间类型 · 17 个脚本
- 典型居家办公与办公室会议场景,房间包括小型房间(10 m² 以下)、中型房间(10–20 m²)、大型房间(20 m² 以上)及开放式办公室。
- 次要人声为同事、家人或共享空间者。
- 29 位说话人(15 女,14 男),使用 24 种音频设备,涵盖专业耳机、消费级耳塞和游戏耳机。
- 脚本较 Call Center 更长、更密集,包含专有名词、数字、日期和术语。
- 使用的音频设备:Jabra Evolve 10、Jabra Evolve 20 MS、Jabra Evolve2 40、Jabra Evolve 75se、Jabra Engage 50、Poly Blackwire 8225、Poly Voyager Focus、Mpow HC5、Apple AirPods、Apple EarPods、Bose QC35、JBL Tune 500BT、JBL Tune 710BT、Soundcore Life Q30、Soundcore P25i、Samsung Galaxy Buds Live、Redmi Buds 3 Lite、Logitech G435、Logitech G733、Logitech Zone Vibe 100、Razer BlackShark V3 Pro、Livey 805DM、Cyber Acoustics AC-204TR
Call Center
- 106 条录音 · 7 位说话人 · 13 种耳机 · 4 个地点 · 28 个脚本
- 在 4 个不同地点的真实呼叫中心环境录制,各地点具有各自的背景噪声特征(邻近坐席的交谈声、键盘声、电话铃声及一般办公活动)。
- 7 位说话人(4 女,3 男),使用专业耳机。
- 28 个脚本覆盖银行、保险、医疗、IT 支持、电信、电商、旅游等坐席–客户通话场景,仅录制坐席一侧。
- 使用的音频设备:Jabra Biz 1500、Jabra Evolve 10、Jabra Evolve2 30、Jabra Evolve2 40、Cyber Acoustics AC-204TR、Cyber Acoustics AC-304TR、Livey 410DM Plus、Livey 500DM AINC、Livey 805DM、Logitech H340、Poly Blackwire 8225、Telekonnectors FS V2、Telekonnectors Sirius QD
Phone Calls
- 63 条录音 · 26 位说话人 · 18 种手机 · 4 种地点类型 · 20 个脚本
- 说话人处于移动状态:驾驶、户外步行、通勤或在商店和咖啡馆内,多数录音来自汽车。
- 挑战在于信号本身而非第二说话人:蓝牙车载麦克风、远离嘴部的扬声器、行驶车辆中的耳塞、电话编解码器、低带宽,叠加街道噪声、音乐、车厢轰鸣和人群嘈杂声。
- 26 位说话人(10 女,16 男),使用 18 种手机型号,录制自 17 种车型以及步行和公共场所。
- 使用的手机:iPhone 13、iPhone 13 Pro Max、iPhone 14、iPhone 14 Pro、iPhone 15、iPhone 15 Pro、iPhone 15 Pro Max、iPhone 16、iPhone 16 Pro、iPhone 17、iPhone 17 Pro、Samsung Galaxy S7、Samsung Galaxy S25、Samsung Fold 7、Sony Xperia 5 IV、Redmi 13C、Honor 400 Pro、OnePlus 12
标注
- 每条录音配有由人工标注员验证的手写转写文本。
- 转写文本精确记录实际所说内容,保留犹豫、假开头和自我纠正,保留如
ano.., astonishing或rec.. resolved的部分词和重启,即真实值以实际所说为准,而非清理后的版本。
音频片段标签
- primary:目标说话人(可能包含环境嘈杂声)
- mix:两位说话人重叠
- secondary:仅次要说话人
- noise:无语音,仅背景噪声
片段标签可用于分别在每种条件下测量 STT 与语音隔离效果,而非仅针对整条录音。
音频格式
- 所有录音为未压缩 WAV 文件(PCM 16-bit signed little-endian),单声道,采样率 32 kHz。
元数据字段
每个场景有一个 metadata.jsonl 文件,每条录音一个条目。所有场景共享以下字段:
file_name:音频文件路径id:唯一样本标识符speaker_id:匿名化说话人标签gender:female / malefull_transcript:完整真实转写文本segments:带时间戳的对象列表,每个含起止时间、转写文本和片段标签recording_device:耳机(Call Center)、音频设备(Work)或麦克风类型(Phone Calls)environment:呼叫中心地点、房间类型或通话情境
Phone Calls 额外增加两个字段:
phone:手机型号car_model:车型(当从汽车录制时)
发布内容
- 完整数据集以 Collection 形式发布在 Hugging Face:https://huggingface.co/collections/Krisp-AI/krisp-voice-isolation-benchmark-suite
- 包含录音、转写文本和元数据,以及每个 Voice Isolation 模型在每个文件上的输出。
- 跨 11 种 STT 配置的基准结果以 Space 形式发布:https://huggingface.co/spaces/Krisp-AI/VoiceIsolation-Benchmark
- 方法论(通过
jiwer计算语料级 WER,在 primary 片段上计算 DNSMOS-C NISQA)在该 Space 中记录。
Krisp Technologies, Inc. · 录音已匿名化;说话人 ID 不含任何个人信息。