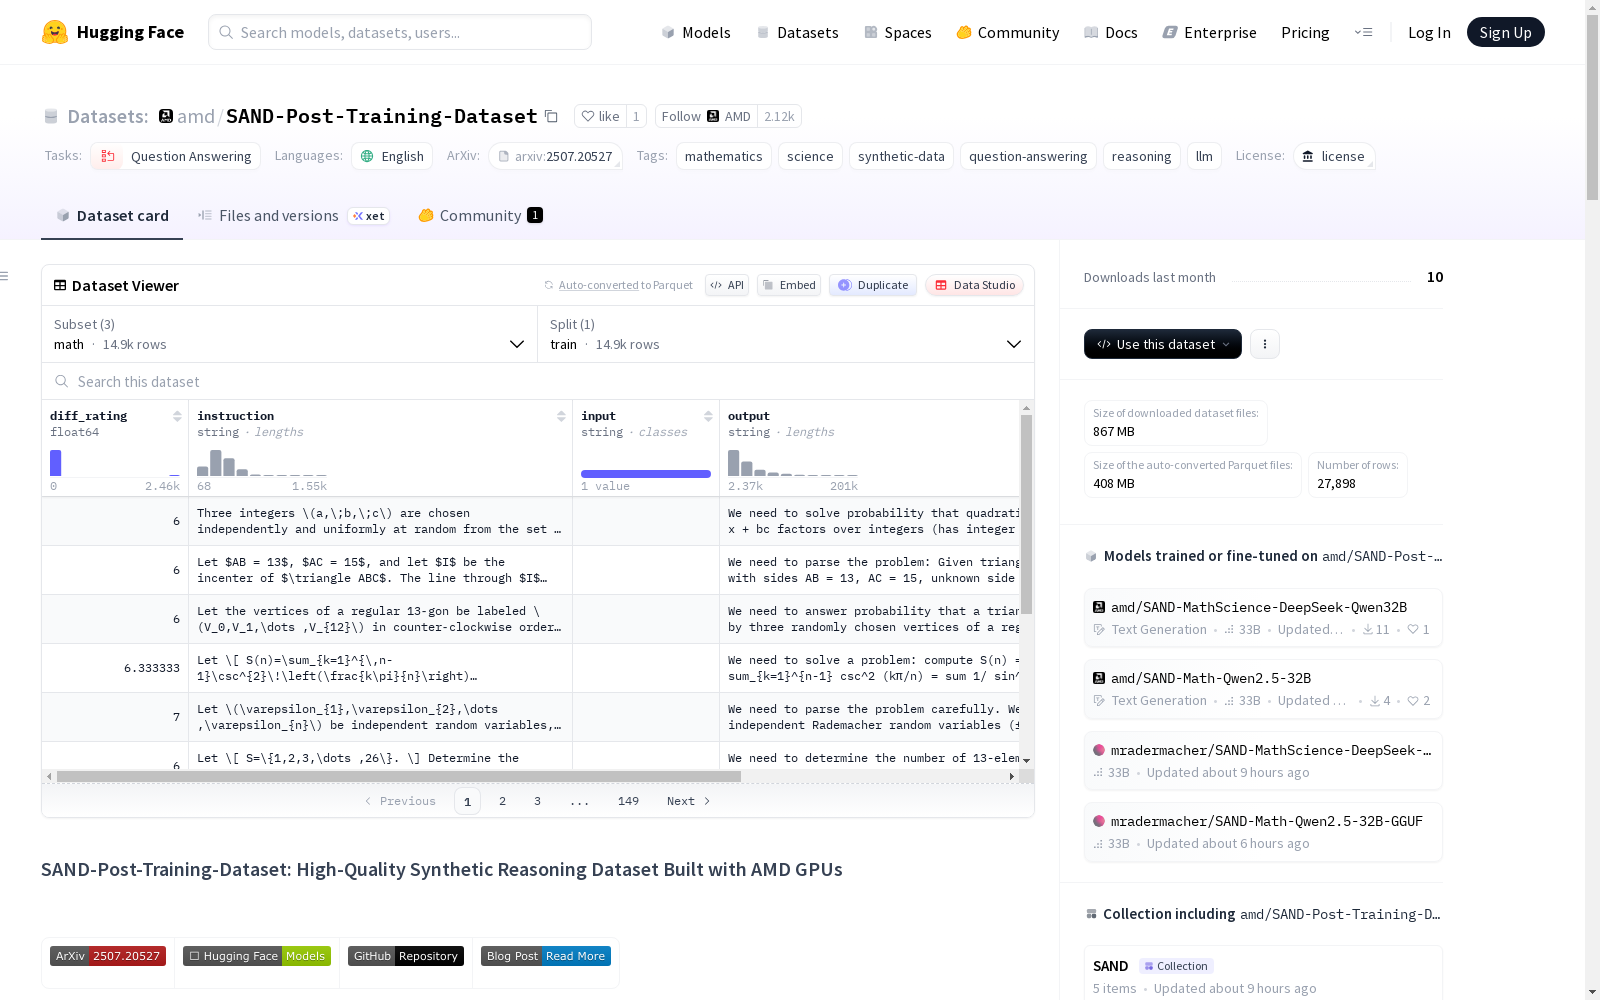
SAND-Post-Training-Dataset
收藏资源简介:
SAND-Post-Training-Dataset是一个高质量的合成推理数据集,专注于数学和科学领域。该数据集通过AMD硬件上的合成数据管道生成,强调难度和新颖性而非数量。数据集包含三个配置:math(14k高难度数学问题)、science(12k需要高级推理的科学问题)和math_dh(1k通过难度提升增强的数学问题)。数据集旨在通过精细调整大型语言模型,实现最先进的推理能力。
SAND-Post-Training-Dataset 数据集概述
数据集基本信息
- 数据集名称:SAND-Post-Training-Dataset
- 发布机构:AMD
- 语言:英语
- 许可证:Open RAIL-MSD 许可证
- 任务类别:问答
- 标签:数学、科学、合成数据、问答、推理、大语言模型
数据集简介
SAND-Post-Training-Dataset 是一个用于数学和科学领域的高质量合成推理数据集。该数据集完全使用在 AMD ROCm™ 软件栈和 AMD Instinct™ MI325 GPU 上运行的合成数据流水线构建。其核心设计理念是优先考虑难度和新颖性而非数据量,旨在通过高质量、高难度的合成数据提升模型性能。
数据集配置与规模
数据集包含三个独立的配置:
math配置:包含 14,000 个高难度数学问题。science配置:包含 12,000 个需要高级推理的科学问题。math_dh配置:包含 1,000 个通过“难度提升”过程增强的数学问题。
数据生成流水线
数据集通过一个在 AMD 硬件上运行的 4 阶段自动化流水线生成,该流水线优先考虑难度和新颖性。
流水线阶段
- 第一阶段:问答生成与一致性:从头生成新颖问题,要求教师模型生成多个独立的解决方案路径以确保正确性,仅保留所有答案一致的问题。
- 第二阶段:去重与去污染:通过嵌入相似性移除内部重复项,并扫描已知测试集以确保零污染。
- 第三阶段:难度提升:由教师模型重写中等难度的问题,引入更深层的推理链、附加约束或跨领域逻辑,以系统性提升问题复杂度。
数据集有效性验证
实验表明,使用此数据集训练的模型能够取得卓越效果。
1. 弥合代际差距
使用混合的数学/科学数据集微调 DeepSeek-R1-Distill-Qwen-32B 模型,使其在关键基准测试中达到甚至超越下一代 Qwen3-32B 模型的性能。
2. 数据效率
仅使用数据集的 math 配置进行标准监督微调,模型性能即可超越使用 5 倍至 50 倍更大数据量训练的其他模型。
快速开始
可以使用 Hugging Face datasets 库加载数据集:
python
from datasets import load_dataset
math_dataset = load_dataset("amd/SAND-Post-Training-Dataset", "math")
science_dataset = load_dataset("amd/SAND-Post-Training-Dataset", "science")
math_dh_dataset = load_dataset("amd/SAND-Post-Training-Dataset", "math_dh")
相关资源
- 论文:https://arxiv.org/pdf/2507.20527
- 模型集合:https://huggingface.co/collections/amd/sand
- GitHub 仓库:https://github.com/AMD-AGI/sand-pipeline
- 博客文章:https://rocm.blogs.amd.com/artificial-intelligence/sand-math/README.html
- 许可证文件:https://huggingface.co/datasets/amd/SAND-Post-Training-Dataset/blob/main/LICENSE
引用
如果使用此数据集,请引用相关论文。