
vector-institute/dia-state-lab-2026
收藏官方服务:
资源简介:
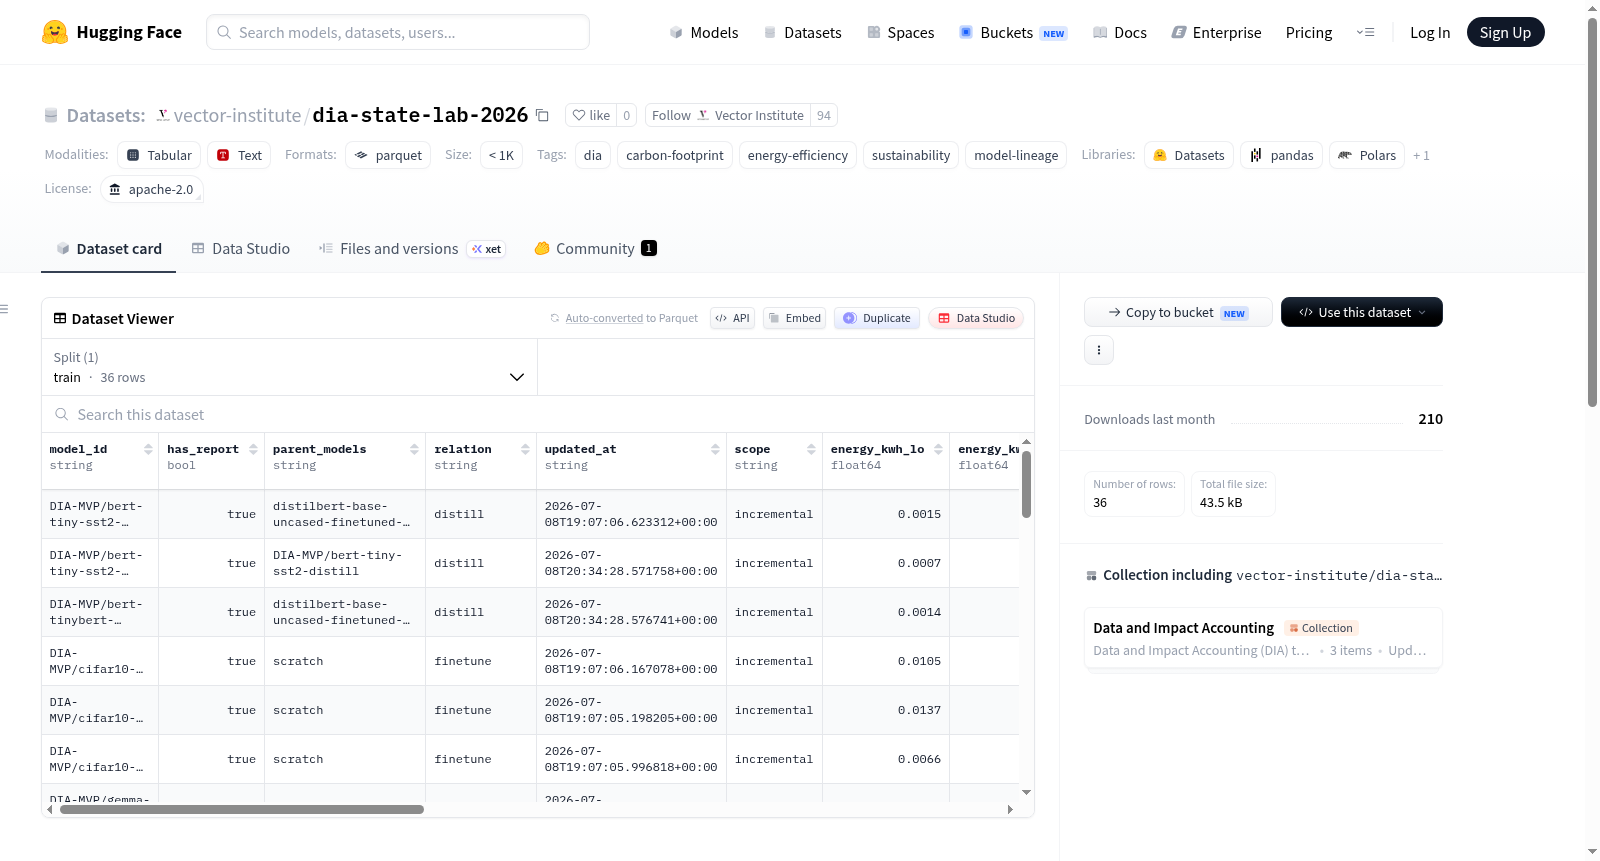
这是一个用于Data & Impact Accounting (DIA)实验室演示的汇总表,索引了在A100/A40/CPU硬件上训练的一组演示模型的训练足迹(能源、碳、水)和谱系。它通过摄入每个模型的dia_report卡生成,并被DIA Gradio仪表板读取,仅存储元数据,不存储模型权重。
This dataset is the rollup table for the Data & Impact Accounting (DIA) lab demo. It indexes the training footprint (energy, carbon, water) and lineage of a set of demo models trained across A100 / A40 / CPU hardware. It is produced by ingesting each models `dia_report` card and is read by the DIA Gradio dashboard. It stores metadata only — no model weights.
提供机构:
vector-institute搜集汇总
数据集介绍
构建方式
该数据集源于数据与影响核算实验室的演示项目,通过摄入一系列基于A100、A40及CPU硬件训练的演示模型所对应的dia_report报告卡构建而成。构建过程采用汇总表技术,以每个模型为节点生成扁平的Parquet行数据,记录能耗、碳排放、水耗区间、数据质量等级、GPU型号与使用时长、地理区域及谱系信息。同时维护一个嵌套的JSON状态文件作为仪表盘加载的真实来源。谱系聚合时,以基础模型为起点构建有向图,将基础模型及其所有后代视为一个族系,仅对每个模型自身的训练增量进行求和,对有向无环图中的合并或共享模型进行去重计数,确保族系总和的精确性。
特点
该数据集最显著的特征在于其谱系层面的精细化核算能力。它并非简单汇报绝对总量,而是提供覆盖面信息,以较低披露程度下的下限形式呈现,从而保护数据隐私与商业敏感度。碳足迹、能耗与水耗数据被明确区分为实测值、估算值与推断值三类来源,确保溯源路径的透明性与可审计性。数据集仅存储元数据而不含模型权重,使得其在满足环境影响追踪需求的同时,保持轻量级与可浏览性。结合数据质量等级的多维标记,该数据集为模型训练的环境成本评估提供了一套结构严谨、层次分明的框架。
使用方法
使用者可通过Gradio交互式仪表盘加载该数据集,仪表盘会自动读取state.json嵌套文件作为数据源,并基于nodes.parquet中的扁平化记录进行可视化呈现。数据集支持按模型族系进行浏览,展示基础模型及其全部后代的累积环境足迹。用户能够查看每个模型的能耗、碳排放与水资源消耗的区间估计,以及对应的GPU类型、运行时长和地理区域信息。对于希望深入分析的研究者,可直接利用Parquet文件通过数据科学工具进行定制化查询与聚合操作,或结合VectorInstitute/ai-impact-accounting工具包进行扩展性分析。
背景与挑战
背景概述
随着人工智能模型的规模日益庞大,其训练过程中的能源消耗与碳排放问题成为学术界与工业界关注的焦点。在此背景下,加拿大向量研究所(Vector Institute)推出的Data & Impact Accounting(DIA)实验室于2026年创建了名为“dia-state-lab-2026”的数据集,旨在系统性地量化并追踪AI模型训练的环境足迹。该数据集围绕核心研究问题展开:如何准确记录模型训练中涉及的能源、碳排放及水资源消耗,并建立模型间的谱系关系。通过聚合在不同硬件(如A100、A40、CPU)上训练的模型足迹,DIA数据集为可持续人工智能研究提供了标准化的基准,对推动负责任的人工智能发展具有重要影响力。
当前挑战
该数据集的核心挑战在于应对AI模型训练环境足迹评估的复杂性与不确定性。首先,领域问题层面,模型训练消耗的能源与碳排放依赖于硬件类型、运行时长、地理位置等多种变量,且不同阶段的模型共享与合并使得准确归属足迹成为难题。其次,构建过程中面临数据可靠性挑战:如何区分“实测”、“估算”与“插补”等不同来源的足迹数据,并确保谱系图中通过有向无环图(DAG)去重后的计算结果准确反映覆盖范围而非简单累加。此外,低披露率情况下如何提供有意义的足迹下限估计,也对数据集的构建方法提出了严苛要求。
常用场景
经典使用场景
DIA lab footprint table 数据集在人工智能与可持续发展的交叉领域中,为研究者提供了一套标准化的模型训练环境足迹索引。其经典使用场景是作为模型训练碳足迹、能源消耗与水资源利用的聚合参考表,通过记录每轮训练在A100、A40或CPU硬件上的增量数据,支持对模型家族进行子树求和与去重统计,实现从单个模型到完整训练谱系的环境影响量化。
解决学术问题
该数据集有效解决了机器学习领域长期存在的训练环境足迹数据碎片化与不可追溯问题。学术界此前难以系统评估不同硬件架构下的模型训练可持续性,而DIA lab footprint table通过引入measured、estimated、imputed三级数据质量标记,以及有向无环图去重机制,为研究者提供了可复现、可比较的环境足迹基准,推动了绿色AI与碳感知模型设计等方向的理论发展。
衍生相关工作
该数据集衍生了多项推动AI可持续性研究的重要工作。VectorInstitute基于此数据发布的开源工具包ai-impact-accounting,建立了从模型训练到环境账务的完整核算框架。此外,DIA-MVP系列模型仓库(*-a100、*-a40、*-cpu)的足迹数据被整合入该数据集,后续工作进一步提出了基于谱系树的环境影响分摊方法论,为形成统一的AI环境足迹标准奠定了数据基础。
以上内容由遇见数据集搜集并总结生成


