atlas-of-judgment
收藏资源简介:
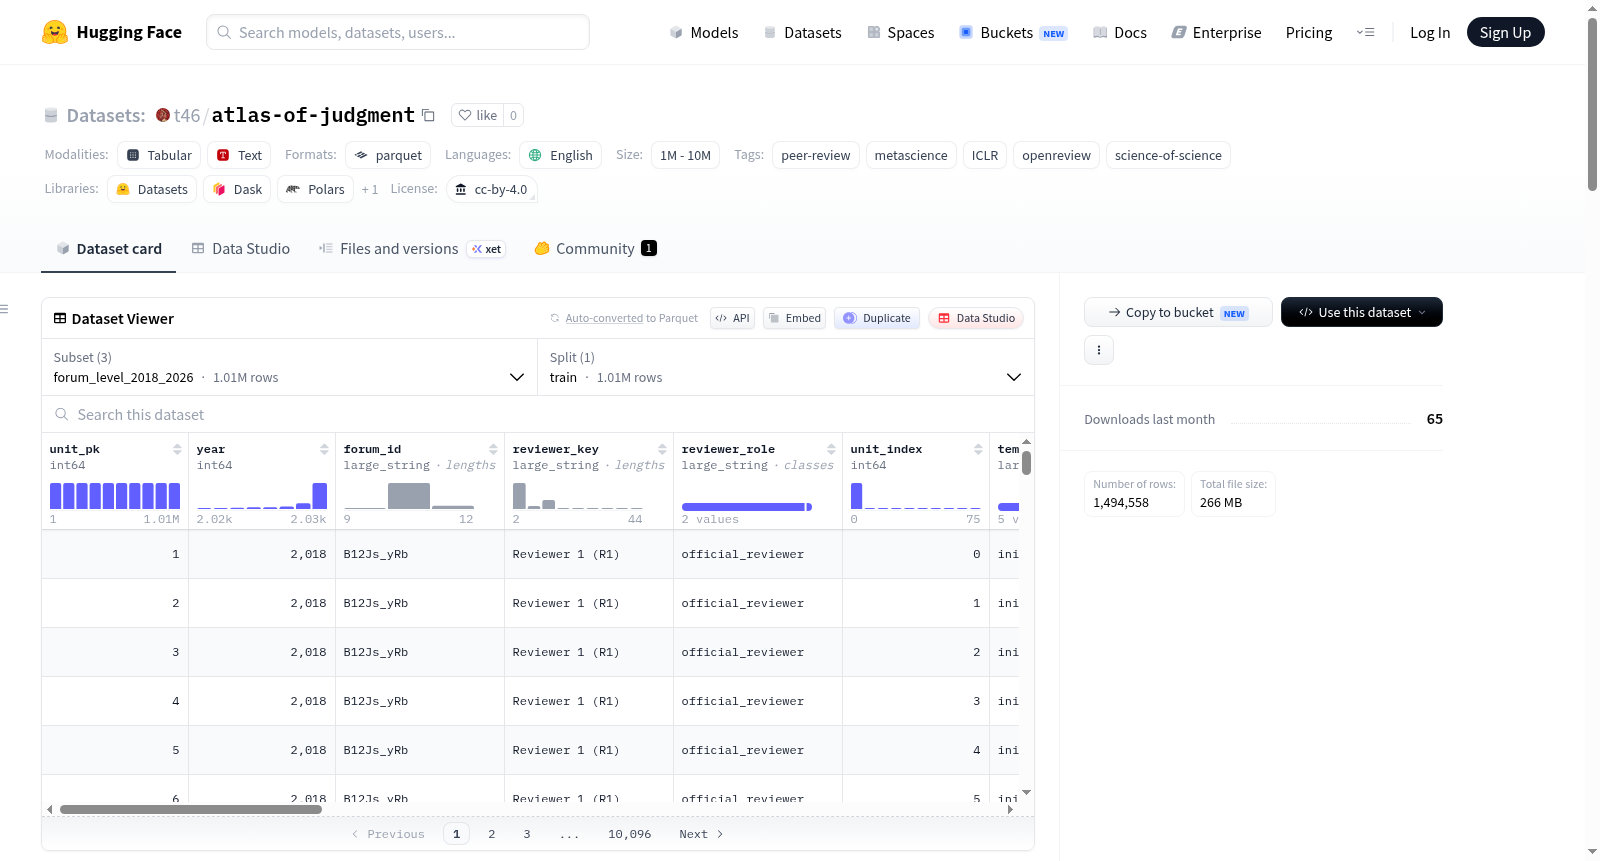
该数据集名为“Atlas of Judgment — ICLR 同行评审逻辑单元”,从 ICLR 2018–2026 年的公开同行评审(OpenReview)中提取了 1,420,178 个原子评估逻辑单元。每个单元都被分解为四个步骤:检查对象(inspected_object)、观察(observation)、推理(reasoning)和结论(judgment),并标注了基于数据诱导的 12 个审查对象 × 12 个认知标准的分类。数据集包含三个配置:review_level_2026(410,586 行,每个单元对应一个官方评审)、review_level_2026_reviews(74,380 行,每个官方评审及其单元计数)、forum_level_2018_2026(1,009,592 行,每个单元对应一个论坛内的评审者,覆盖 2018–2026 年)。所有单元均由两阶段 LLM 流水线生成(DeepSeek 备忘录层 → Qwen 结构化层),并附有支持状态(显式支持或推断支持)、模型置信度、最近中心分类标签(对象和标准的标签及其余弦相似度)等字段。此外,论坛级子集还包含年份、论坛 ID、评审者匿名 ID、时序位置、判断变化等字段;评审级子集包含论文 ID、评审 ID、证据引用数等。数据集还提供了分类法定义(taxonomy/taxonomy_v1.json)和 600 个人工标注的修辞标签单元。该数据集可用于元科学研究、同行评审质量分析、评估逻辑的自动分解与分类、以及自然语言处理中的结构化文本理解等任务。请注意,数据为机器阅读结果,并非真实标注,提取过程中约有 1.9% 的评审和 1.8% 的论坛未能成功提取,且分类法基于抽样诱导,可能存在噪声。
This dataset, named Atlas of Judgment — ICLR Peer Review Logic Units, extracts 1,420,178 atomic evaluation logic units from public peer reviews (OpenReview) of ICLR 2018–2026. Each unit is decomposed into four steps: inspected_object, observation, reasoning, and judgment, and is annotated with a data-induced classification of 12 inspected objects × 12 cognitive criteria. The dataset includes three configurations: review_level_2026 (410,586 rows, each unit corresponds to an official review), review_level_2026_reviews (74,380 rows, each official review and its unit count), and forum_level_2018_2026 (1,009,592 rows, each unit corresponds to a reviewer within a forum, covering 2018–2026). All units are generated by a two-stage LLM pipeline (DeepSeek memo layer → Qwen structured layer), with fields such as support status (explicit or inferred support), model confidence, nearest centroid classification labels (labels and cosine similarity for objects and criteria). Additionally, the forum-level subset includes fields like year, forum ID, reviewer anonymous ID, temporal position, judgment changes, etc.; the review-level subset includes paper ID, review ID, evidence citation count, etc. The dataset also provides taxonomy definitions (taxonomy/taxonomy_v1.json) and 600 manually annotated rhetorical label units. This dataset can be used for metascience research, peer review quality analysis, automatic decomposition and classification of evaluation logic, and structured text understanding in natural language processing. Note that the data is machine-read, not ground-truth annotations; approximately 1.9% of reviews and 1.8% of forums failed to extract, and the taxonomy is based on sample induction, which may contain noise.
数据集概述
Atlas of Judgment — ICLR Peer-Review Logic Units 是一个包含超过142万个原子评估逻辑单元的数据集,这些单元从ICLR同行评审(OpenReview平台)的公开评审文本中提取,每个单元被分解为四个步骤:检查了什么 → 观察到了什么 → 如何推理 → 得出了什么结论,并标注了由数据归纳出的分类体系(12个审查对象 × 12种认知标准)。
数据子集
| 配置名称 | 行数 | 粒度 | 年份 |
|---|---|---|---|
review_level_2026 |
410,586 | 一条官方评审中的一个单元 | ICLR 2026 |
review_level_2026_reviews |
74,380 | 一条官方评审(摘要+单元数量) | ICLR 2026 |
forum_level_2018_2026 |
1,009,592 | 一个论坛内某位评审者的一个单元 | ICLR 2018–2026 |
2026年评审级轨迹以最细粒度读取了该会议98.1%的官方评审;review_id是OpenReview笔记ID,因此每个单元都可以对照原始评审进行验证。论坛级轨迹读取了九年间51,813个公共论坛中的50,861个(98.2%),并增加了讨论阶段字段(temporal_position、judgment_change、update_trigger)。
主要字段
两个单元表共有的字段包括:
inspected_object/observation/reasoning/judgment— 四步逻辑分解valence— 消极、积极、条件性、不确定、混合suggested_improvement— 评审提出的具体改进建议support_status— 明确支持或备忘录推断confidence— 结构化模型自身的置信度object_key、object_sim、standard_key、standard_sim— 最近质心分类分配及余弦相似度
论坛级特有字段:year、forum_id、reviewer_key、reviewer_role、temporal_position、judgment_change、update_trigger。
评审级特有字段:paper_id、review_id、n_evidence_refs、n_missing_links。
数据来源与处理流程
- 原始数据:公共OpenReview API v1/v2,52,460个ICLR论坛,2018–2026年。
- 备忘录:
deepseek-v4-flash撰写定性元科学备忘录。 - 单元化:
qwen3.7-flash将备忘录规范化为结构化单元。 - 分类体系:从12,000个单元样本中归纳(bge-small-en-v1.5嵌入、UMAP/HDBSCAN),人工命名后通过最近质心分配给全语料库。
决策、分数和其他结果元数据从未展示给提取流程;如需可在分析时从OpenReview关联。
分析产物
analysis/ 目录包含29个JSON文件,包括元素分解、判例数据、模板数据、反事实数据(面板重绘模拟)、线程数据(199k条评审线程的回复树形状)等。
许可与引用
- 许可:CC BY 4.0,与源材料的上游许可一致。
- 引用:需注明OpenReview和ICLR评审者社区(源文本),并引用本数据集(机器阅读)。
- 隐私:仅包含公共匿名评审者ID,无非公开个人数据。
局限性
- 机器阅读而非事实真相,需验证后再做结论。
- 1.9%的2026年评审和1.8%的论坛提取失败,缺失性未经验证与主题无关。
- 标准分类体系是从约40%的试点样本中归纳的骨架,单元分配的相似度已提供以便过滤。
- 未包含子分数和决策,需从OpenReview关联。