
遇见数据集

my-patents-data

收藏
Hugging Face2026-07-25 更新2026-07-27 收录
官方服务:

资源简介:

该数据集名为全球专利出版物与中国专利族质量指标,包含两个Parquet文件,用于表格分类和特征提取任务。第一个文件cn_family_quality_master_gft.parquet以专利族为观察单位,涵盖2003年至2019年的中国核心发明专利族,包含约10,790,043行数据。该文件集成了专利质量评估的完整流程,包括语义知识重组、严格历史语义新颖性、基于IPC的知识重组稳健性度量、三年和五年远期引用、CD3和CD5破坏性度量、全窗口和五年期PageRank,以及语义KNN图的低通和高通/图傅里叶变换分量。第二个文件global_invention_patents_with_quality.parquet以专利出版物记录为观察单位,将全球发明专利申请出版物表与中国专利族质量主表通过family_id进行左连接,保留所有原始出版物级别的行和列,匹配到同一专利族的出版物获得相同的族级质量指标,并通过quality_matched标识匹配状态,未匹配的全球出版物保留在文件中但质量字段为空。该文件预期包含约121,309,581行数据。方法上,缺失的知识重组、破坏性指标或图傅里叶变换值未被零值替换,PageRank零值伴随in_citation_graph指标以标识是否在可识别引用图中。该数据集为私有资源,使用前需审查源数据许可、再分发权利和披露要求。

创建时间:
2026-07-20
原始信息汇总

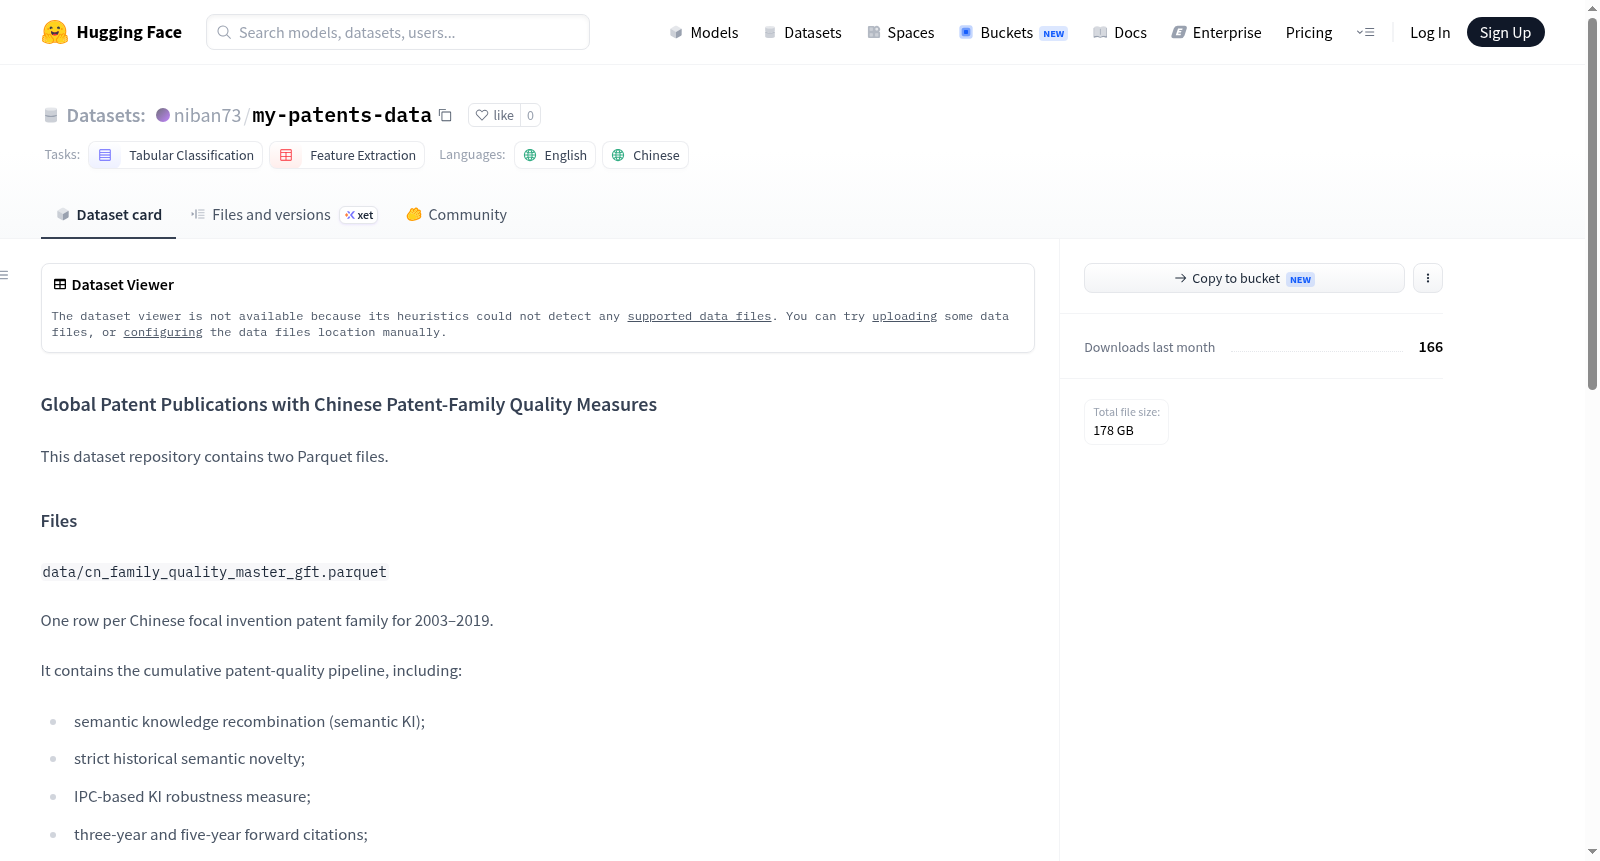
数据集概览:Global Patent Publications with Chinese Patent-Family Quality Measures

数据集地址:https://huggingface.co/datasets/niban73/my-patents-data

语言:英文、中文
任务类别:表格分类、特征提取


文件结构

  1. data/cn_family_quality_master_gft.parquet

    • 每个条目代表一个中国焦点发明专利族,时间范围为 2003–2019 年。
    • 包含累积专利质量指标,如:
      • 语义知识重组(semantic KI)
      • 严格历史语义新颖性
      • 基于IPC的KI鲁棒性度量
      • 三年和五年向前引用
      • CD3和CD5颠覆性度量
      • 全窗口和五年PageRank
      • 语义KNN图的低通/高通/GFT分量
    • 预计行数:10,790,043
  2. data/global_invention_patents_with_quality.parquet

    • 原始全球发明专利公开表,通过 family_id 左连接到专利族质量主表。
    • 保留原始公开级别的行和列。
    • 属于同一匹配族的所有公开记录共享相同的族级质量指标。
    • quality_matched = true 标识已匹配到中国焦点族质量表的公开记录。
    • 未匹配的全球公开记录保留在文件中,质量字段为空。
    • 预计行数:121,309,581

观测单元说明

  • 质量主表:专利族(patent family)
  • 全球结果表:专利公开记录(patent publication record)
  • 匹配键family_id

重要方法论说明

  • 缺失的KI、CD或GFT值未以零填充。
  • 对于无法识别引用图之外的专利族,其PageRank为零值,并附有 in_citation_graph 指示符。
  • 该仓库创建时为私有状态,更改可见性前需审查源数据许可、再分发权利和披露要求。
搜集汇总
数据集介绍
my-patents-data 数据集图片
构建方式
本数据集以中国发明专利申请族为焦点,构建了一套综合性的专利质量评估体系。核心数据文件`cn_family_quality_master_gft.parquet`收录了2003至2019年间约1079万条中国专利族记录,每一条均经由累积性质量管道处理,融入了语义知识重组、严格历史语义新颖性、基于IPC的知识重组鲁棒性等前沿指标。另一文件`global_invention_patents_with_quality.parquet`则通过`family_id`字段,将全球约1.21亿条发明专利公开记录与前述质量主表进行左连接,使得同一专利族下的所有公开版本均继承相同的族级质量度量,未匹配的记录则保留原字段并标示质量匹配状态。
特点
该数据集的核心特色在于其多维度、累积性的专利质量度量体系。它不仅包含传统的三年与五年向前引用计数,还引入了CD3和CD5颠覆性度量、全窗口及五年PageRank值、语义KNN图的低通与高通图傅里叶变换组件等前沿指标。特别值得注意的是,缺失的知识重组、颠覆性或图傅立叶变换值并未被零值替代,而PageRank零值则伴随引用图内指示器,保障了数据完整性。这种设计使得研究者能够从知识重组、新颖性、影响力和结构位置多个层面,深入剖析中国专利族的发明质量。
使用方法
本数据集以Parquet格式提供,兼容主流数据处理框架如Pandas、Dask和Spark,便于高效加载与分析。研究者可直接使用`cn_family_quality_master_gft.parquet`进行中国专利族的质量纵向分析,或通过`global_invention_patents_with_quality.parquet`探索全球专利与族级质量指标的关联。匹配标识符`quality_matched`可用于区分已匹配与未匹配记录。由于数据集默认设为私有,使用前需审阅源数据许可协议、再分发权及披露要求,以确保合规操作。
背景与挑战
背景概述
该数据集由全球专利研究团队构建,旨在系统量化中国发明专利家族的质量特征,覆盖2003年至2019年的专利数据。其核心研究问题在于融合语义知识重组、历史新颖性度量、IPC分类稳健性评估以及引用网络分析等多维度指标,以突破传统专利质性分析的局限。数据集包含超过千万个中国专利家族和上亿条全球专利出版物记录,为专利信息学、技术演进追踪及创新政策评估提供了大规模、高粒度的结构化基础,尤其在知识流动与破坏性创新研究中具有重要参考价值。
当前挑战
数据集面临的首要挑战在于专利质量的多维度量化难题,如语义相似性测量、引用网络稀疏性及指标缺失值处理,需要设计稳健的管道以避免噪声干扰。构建过程中,跨语言专利家族匹配(中英)、多源数据左连接的一致性维护,以及大型Parquet文件的高效存储与分布式处理,均对数据工程能力提出了严苛要求。此外,版权与许可限制要求谨慎控制数据公开范围,在保证科学复现与法律合规之间寻求平衡。
常用场景
经典使用场景
在创新经济学与知识产权研究领域,my-patents-data数据集为分析专利质量与技术创新动态提供了坚实基础。其经典使用场景聚焦于探究中国专利家族的技术新颖性、知识重组模式及其对后续创新的影响。研究者可借助该数据集中的语义知识重组指数、历史新颖性指标及IPC分类的鲁棒性度量,系统刻画专利族的技术突破程度。同时,前向引用次数与CD3、CD5颠覆性指标相结合,能够从引文网络视角评估专利的长期影响力。这些特征使该数据集成为专利价值评估、技术轨道识别以及创新政策评估等实证研究的理想数据源,推动了专利计量学从简单计数向多维质量度量的范式转变。
衍生相关工作
该数据集作为高价值专利质量信息的枢纽,已衍生出多项关键研究工作。基于其提供的语义知识重组与颠覆性度量指标,学者们开发了专利技术新颖性自动分类模型,用于预测专利申请的审查结果与后续授权概率。结合IPC鲁棒性度量与PageRank指标,衍生出专利技术影响力演化分析框架,揭示技术集群从萌芽到成熟的生命周期模式。此外,利用CD3与CD5指数,产生了专利颠覆性对产业创新网络结构影响的实证研究,量化了激进式创新与渐进式创新在不同技术领域的作用差异。更有工作将其与商标、论文等异质性数据融合,构建了技术与市场协同演化的动态模型,推动了跨学科创新测量体系的发展。
数据集最近研究
最新研究方向
该数据集聚焦于全球专利文献与中国专利家族质量指标的深度融合,为专利计量学与创新研究提供了前沿的数据基础。当前研究热点集中在利用图信号处理(GFT)与语义知识重组(KI)指标,挖掘专利家族的颠覆性创新潜力与知识流动模式。通过结合PageRank、CD3/CD5破坏性指数及前向引用量,研究者能够更精准地评估技术突破的长期影响。该数据集覆盖2003至2019年中国重点发明家族及全球超过1.21亿条专利记录,为探索专利质量与跨区域技术扩散的关联机制提供了大规模实证支持,对理解全球创新生态系统及专利战略制定具有重要参考价值。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

