
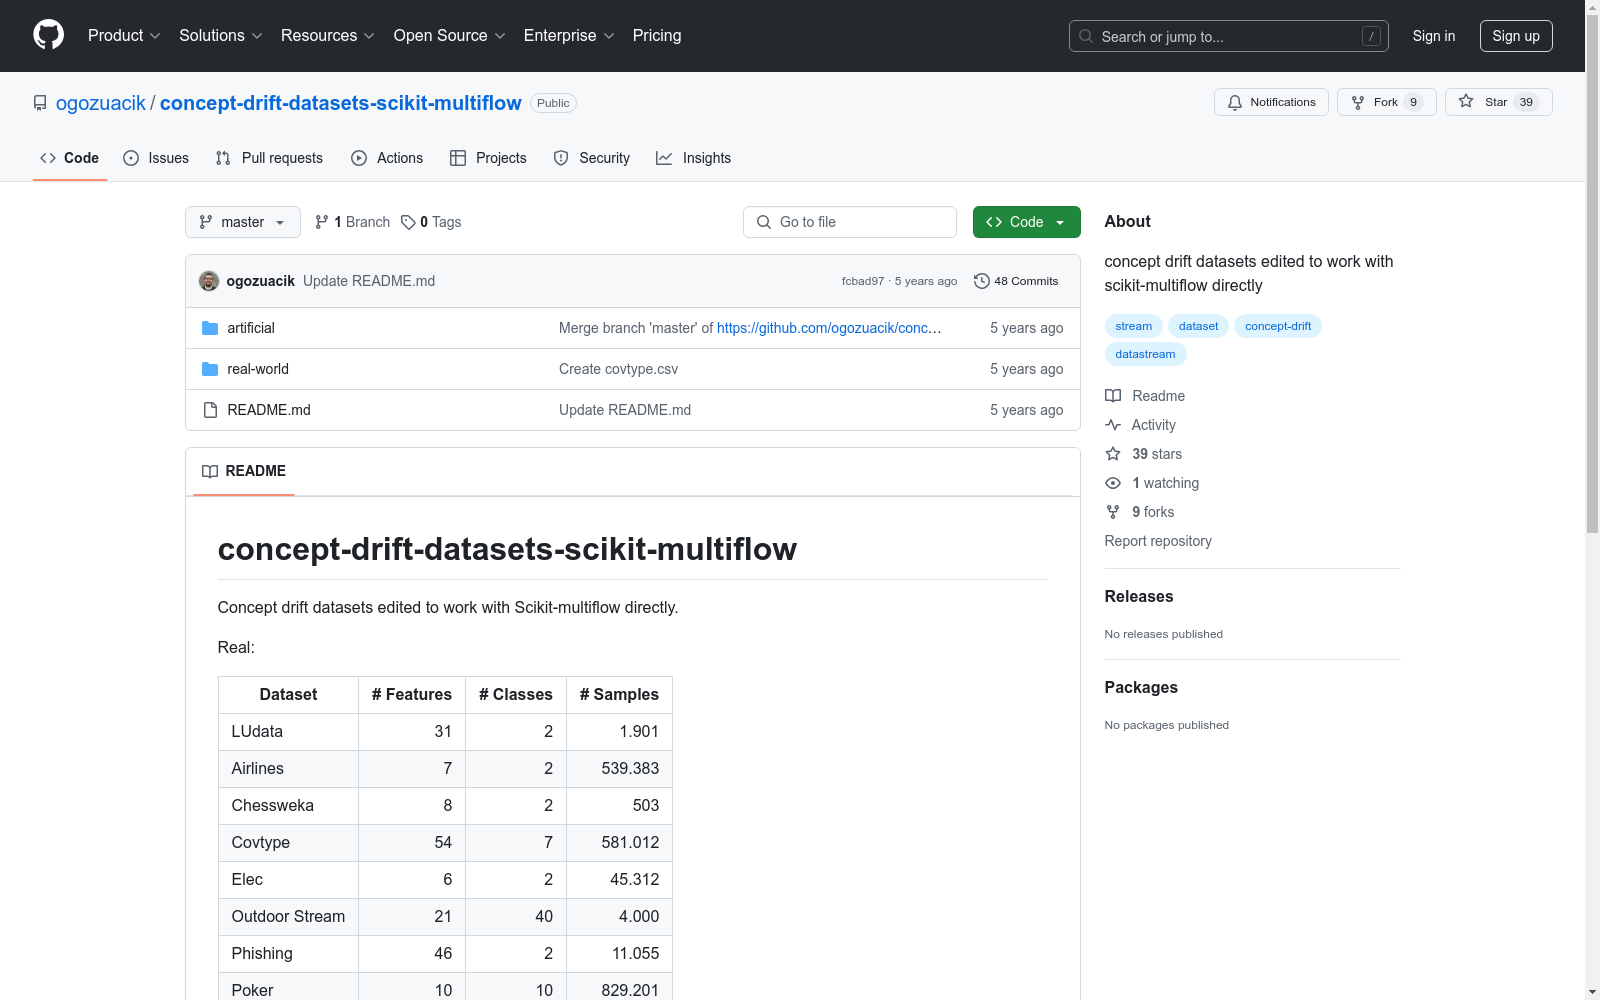
LUdata, Airlines, Chessweka, Covtype, Elec, Outdoor Stream, Phishing, Poker, Rialto, Spam, Weather, InterchangingRBF, MixedDrift, MovingRBF, Moving Squares, Rotating Hyperplane, SEA Big, Sea Stream, Transient Chessboard
收藏官方服务:
资源简介:
这些数据集用于概念漂移研究,包括真实世界和人工生成的数据集,每个数据集都详细列出了特征数量、类别数量和样本数量。
These datasets are utilized for the study of concept drift, encompassing both real-world and artificially generated datasets. Each dataset meticulously details the number of features, categories, and samples.
创建时间:
2019-07-22
原始信息汇总
数据集概述
真实数据集
| 数据集 | 特征数 | 类别数 | 样本数 |
|---|---|---|---|
| LUdata | 31 | 2 | 1,901 |
| Airlines | 7 | 2 | 539,383 |
| Chessweka | 8 | 2 | 503 |
| Covtype | 54 | 7 | 581,012 |
| Elec | 6 | 2 | 45,312 |
| Outdoor Stream | 21 | 40 | 4,000 |
| Phishing | 46 | 2 | 11,055 |
| Poker | 10 | 10 | 829,201 |
| Rialto | 27 | 10 | 82,250 |
| Spam | 499 | 2 | 6,213 |
| Weather | 8 | 2 | 18,159 |
人工数据集
| 数据集 | 特征数 | 类别数 | 样本数 |
|---|---|---|---|
| InterchangingRBF | 2 | 15 | 200,000 |
| MixedDrift | 2 | 15 | 600,000 |
| MovingRBF | 10 | 5 | 200,000 |
| Moving Squares | 2 | 4 | 200,000 |
| Rotating Hyperplane | 10 | 2 | 200,000 |
| SEA Big | 3 | 2 | 100,000 |
| Sea Stream | 3 | 2 | 40,000 |
| Transient Chessboard | 2 | 8 | 200,000 |
搜集汇总
数据集介绍
构建方式
该数据集的构建方式主要基于对多个公开可用数据源的整合与编辑,旨在为Scikit-multiflow框架提供直接兼容的概念漂移数据集。这些数据集涵盖了从UCI机器学习库、Google Sites、GitHub等多个平台获取的真实与人工生成的数据。真实数据集如LUdata、Airlines等,来源于实际应用场景,而人工数据集如InterchangingRBF、MovingRBF等,则是通过模拟概念漂移现象生成。通过这种方式,数据集不仅涵盖了广泛的特征和样本数量,还确保了在不同应用场景下的适用性。
特点
该数据集的主要特点在于其多样性和针对性。首先,数据集包含了从真实世界和人工模拟中提取的多种数据类型,涵盖了从简单的二分类问题到复杂的多分类任务。其次,数据集的规模从几百到几十万不等,能够满足不同规模实验的需求。此外,数据集特别针对概念漂移问题进行了优化,适合用于研究数据流中的概念漂移检测和适应算法。
使用方法
该数据集的使用方法相对直接,主要用于支持Scikit-multiflow框架下的概念漂移研究。用户可以通过加载这些预处理的数据集,直接进行模型训练和测试。对于真实数据集,用户可以利用其丰富的特征和样本信息,进行深入的分析和模型验证。而对于人工数据集,则可以专注于概念漂移的模拟和算法性能的评估。此外,数据集的多样性也使得它们适用于多种机器学习任务,如分类、回归等。
背景与挑战
背景概述
概念漂移(Concept Drift)是数据流分析领域中的一个核心问题,指的是数据分布随时间发生变化,导致模型性能下降。LUdata、Airlines、Chessweka等数据集是由多个研究机构和学者共同整理,旨在为概念漂移研究提供标准化的测试基准。这些数据集涵盖了从实际应用中提取的真实数据(如Airlines和Covtype)以及人工生成的模拟数据(如MovingRBF和Rotating Hyperplane),广泛应用于机器学习、数据流挖掘等领域。通过这些数据集,研究人员能够更好地理解和应对概念漂移现象,推动相关算法的发展与优化。
当前挑战
概念漂移数据集的构建与应用面临多重挑战。首先,真实数据集的获取和预处理过程复杂,涉及数据质量、噪声处理以及特征选择等问题。其次,人工数据集的生成需要精确模拟概念漂移的动态特性,确保其能够有效评估算法的鲁棒性和适应性。此外,不同数据集的规模、特征数量和类别分布差异较大,增加了模型训练和评估的难度。最后,如何设计有效的概念漂移检测和适应机制,以应对数据分布的快速变化,仍是当前研究的重点和难点。
常用场景
经典使用场景
在概念漂移(Concept Drift)研究领域,LUdata、Airlines、Chessweka等数据集被广泛应用于检测和适应数据分布随时间变化的情况。这些数据集通过模拟或实际采集的数据,帮助研究人员开发和验证能够动态调整模型以应对概念漂移的算法。例如,Airlines数据集常用于研究航班延误预测中的概念漂移问题,而Chessweka则用于验证分类器在棋盘游戏数据中的适应性。
衍生相关工作
基于这些概念漂移数据集,研究者们开发了多种先进的算法和模型。例如,基于SEA Big数据集的研究推动了在线学习算法的改进,而MovingRBF数据集则促进了动态数据流处理技术的发展。此外,Transient Chessboard数据集的相关研究为多分类问题中的概念漂移检测提供了新的视角。这些衍生工作不仅丰富了概念漂移领域的理论基础,也为实际应用提供了强有力的技术支持。
数据集最近研究
最新研究方向
在概念漂移(Concept Drift)领域,LUdata、Airlines、Chessweka等数据集的研究正聚焦于实时数据流中的模型适应性问题。这些数据集不仅涵盖了从航空、电力到网络安全的多样化应用场景,还通过人工数据集如InterchangingRBF和MovingRBF模拟了复杂的漂移现象。当前研究热点集中在开发能够动态调整模型参数的算法,以应对数据分布随时间变化带来的挑战。此外,结合深度学习和强化学习的新方法也在探索中,旨在提高模型在概念漂移环境下的鲁棒性和预测精度。这些研究不仅推动了数据流分析技术的发展,也为智能决策系统在动态环境中的应用提供了理论支持。
以上内容由遇见数据集搜集并总结生成


