
遇见数据集

gzqy1026/RemoteCLIP

收藏
Hugging Face2024-04-26 更新2024-06-15 收录
官方服务:

资源简介:

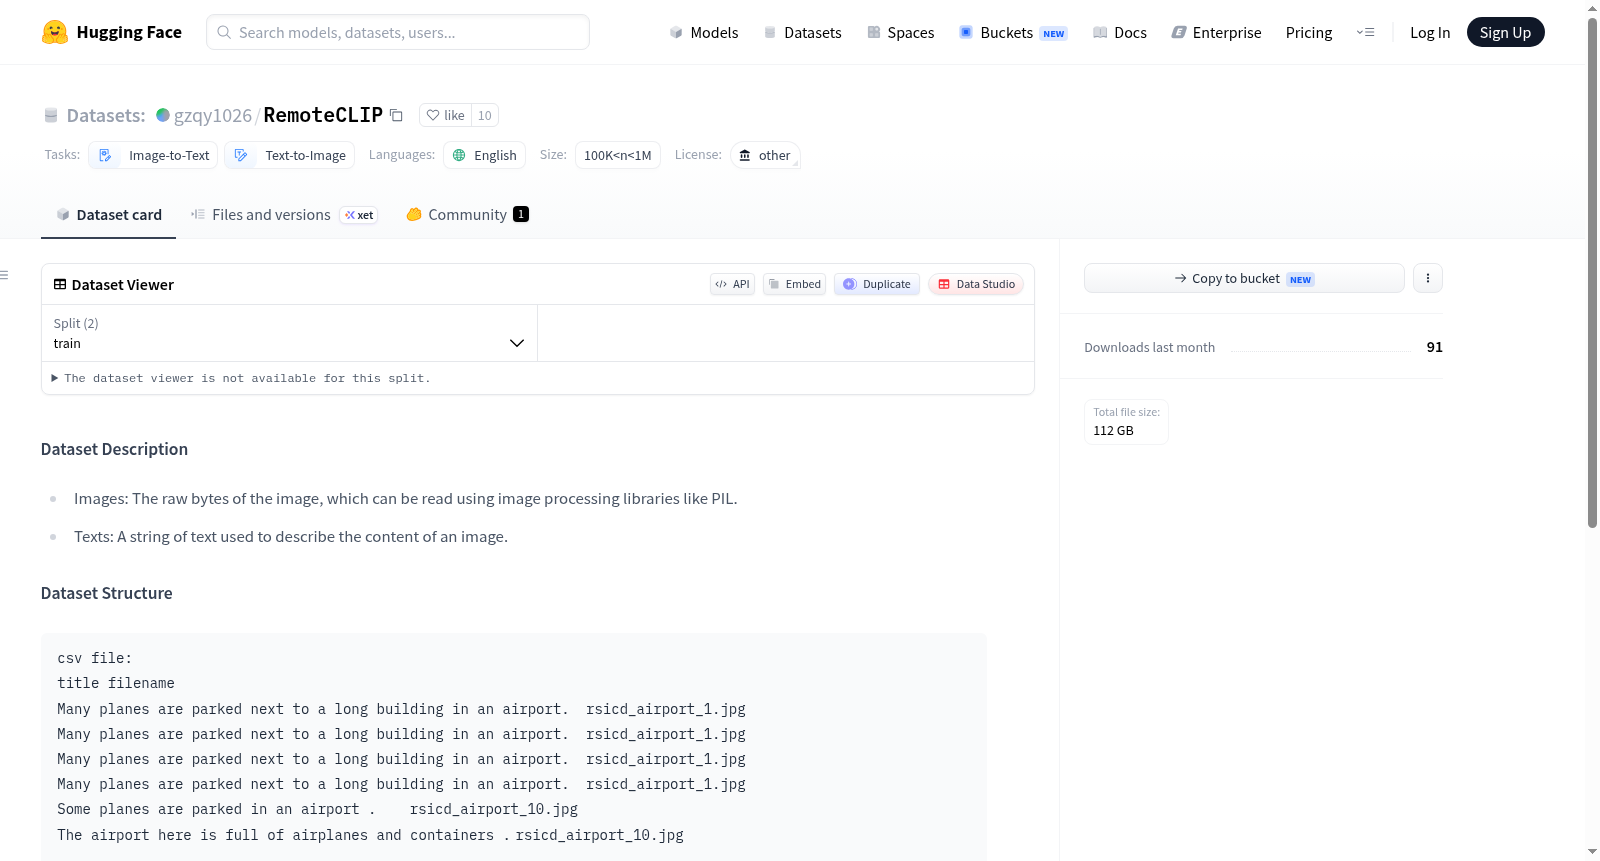
该数据集包含图像的原始字节和用于描述图像内容的文本。图像可以通过图像处理库(如PIL)读取,文本则是描述图像内容的字符串。数据集的结构以CSV文件形式呈现,包含图像标题和文件名。

The RemoteCLIP dataset is primarily used for image-to-text and text-to-image tasks. It consists of images and texts, where the image part is raw bytes that can be read using image processing libraries like PIL; the text part is a string describing the content of the image. The dataset structure is presented in a CSV file format, with each row containing a title and filename, where the title is a description of the corresponding image. The dataset size ranges between 100K and 1M.

提供机构:
gzqy1026
原始信息汇总

数据集描述

概述

  • 图像: 图像的原始字节,可以使用图像处理库(如PIL)读取。
  • 文本: 用于描述图像内容的字符串。

数据集结构

数据集以CSV文件格式存储,包含以下字段:

  • title: 描述图像内容的文本。
  • filename: 图像文件名。

示例数据: shell title filename Many planes are parked next to a long building in an airport. rsicd_airport_1.jpg Some planes are parked in an airport . rsicd_airport_10.jpg The airport here is full of airplanes and containers . rsicd_airport_10.jpg There is a small tennis court with some cars and a swimming pool beside . ucm_2080.png

引用信息

bibtex @article{liu2024remoteclip, title={Remoteclip: A vision language foundation model for remote sensing}, author={Liu, Fan and Chen, Delong and Guan, Zhangqingyun and Zhou, Xiaocong and Zhu, Jiale and Ye, Qiaolin and Fu, Liyong and Zhou, Jun}, journal={IEEE Transactions on Geoscience and Remote Sensing}, year={2024}, publisher={IEEE} }
搜集汇总
数据集介绍
gzqy1026/RemoteCLIP 数据集图片
构建方式
RemoteCLIP数据集面向遥感领域的视觉-语言理解任务构建,整合了来自多个遥感图像数据源的图像与对应英文文本描述。数据以CSV格式组织,每一行包含图像文件名与一条自然语言描述,例如机场中飞机停放场景的描述。图像以原始字节形式存储,可借助PIL等图像处理库加载。数据集规模介于10万至100万样本之间,覆盖遥感场景下的多样化目标与场景。
特点
该数据集的核心特点在于其跨模态对齐能力,将遥感图像与细粒度文本描述一一对应,为视觉-语言基础模型提供训练基础。样本涵盖机场、网球场、游泳池等典型遥感地物,文本描述兼具简洁性与信息密度,支持图像到文本与文本到图像的双向生成任务。数据集来源于已公开的遥感图像集,确保了数据真实性与领域代表性。
使用方法
使用时可直接加载CSV文件,通过文件名索引图像路径,并利用PIL读取图像数据。文本列可直接作为图像描述的标签,适用于对比学习、图像描述生成或多模态检索等任务。推荐使用PyTorch或TensorFlow框架构建数据加载器,将图像与文本对作为训练输入。数据集已集成至HuggingFace,可通过`load_dataset`接口便捷调用。
背景与挑战
背景概述
遥感领域作为地球观测与智能分析的重要交叉方向,长期受限于视觉与语言模态之间的语义鸿沟。为弥合这一差距,RemoteCLIP数据集于2024年由Fan Liu、Delong Chen、Zhangqingyun Guan等来自多所机构的研究者联合构建,其核心研究问题在于如何通过大规模图文对预训练,使视觉语言模型能够理解遥感图像中的地理空间语义。该数据集整合了RSICD、UCM等经典遥感图像描述数据源,包含超过10万张图像及其英文文本描述,为遥感领域的零样本分类、场景检索与图像描述等任务提供了统一的基准。RemoteCLIP的提出显著推动了遥感基础模型的发展,其影响力体现在为后续研究提供了可直接迁移的预训练范式,并成为连接遥感视觉理解与自然语言处理的关键桥梁。
当前挑战
RemoteCLIP所解决的领域挑战在于遥感图像的多尺度、多视角与细粒度语义理解,传统模型难以在缺乏标注的情况下泛化至复杂的地理场景,而该数据集通过图文对齐训练使模型具备了跨模态推理能力。在构建过程中,研究人员面临了多重困难:首先,遥感图像来源多样,不同数据集(如RSICD、UCM)的图像分辨率、地理覆盖范围和标注风格差异显著,需统一预处理与描述格式;其次,确保文本描述与图像内容的精确对应是艰巨任务,尤其是针对稀疏目标或模糊边界的地物(如小型机场设施与泳池),人工标注一致性难以保障;最后,数据集规模虽达十万级,但相较于自然图像领域仍显不足,如何在小样本条件下维持模型鲁棒性仍是持续挑战。
常用场景
经典使用场景
RemoteCLIP数据集专为遥感领域的视觉-语言基础模型训练而设计,其经典使用场景在于构建跨模态的遥感图像与文本对齐任务。该数据集包含数十万对遥感图像及其对应的自然语言描述,覆盖机场、港口、农田、建筑等丰富的地物类别,为多模态遥感智能分析提供了标准化的训练与评估基准。研究者常利用该数据集训练对比学习框架,以学习遥感图像与文本之间的语义映射关系,从而实现对遥感场景的零样本分类与描述生成。
解决学术问题
该数据集有效解决了遥感领域长期存在的视觉与语言模态割裂的学术难题。传统遥感图像分析主要依赖单模态监督学习,面临标注成本高、跨任务泛化能力弱等瓶颈。RemoteCLIP通过提供大规模图文配对数据,推动了遥感视觉-语言预训练模型的突破,使模型能够在不依赖特定任务标注的情况下,理解遥感图像的语义内涵。这一创新显著提升了遥感场景分类、目标检测与图像检索等任务的泛化性能,为通用遥感智能奠定了数据基础。
衍生相关工作
RemoteCLIP的发布催生了一系列具有影响力的衍生工作。研究者基于该数据集提出了面向遥感领域的改进型视觉-语言模型,如引入地理先验知识的GeoCLIP与融合多尺度特征的RemoteCLIP-Swin,进一步提升了模型对复杂遥感场景的细粒度理解能力。同时,该数据集也被用于遥感图像生成任务,推动了文本到遥感图像合成技术的发展,并启发了遥感领域多模态预训练范式的标准化研究,相关成果发表于IEEE TGRS等顶级期刊。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

