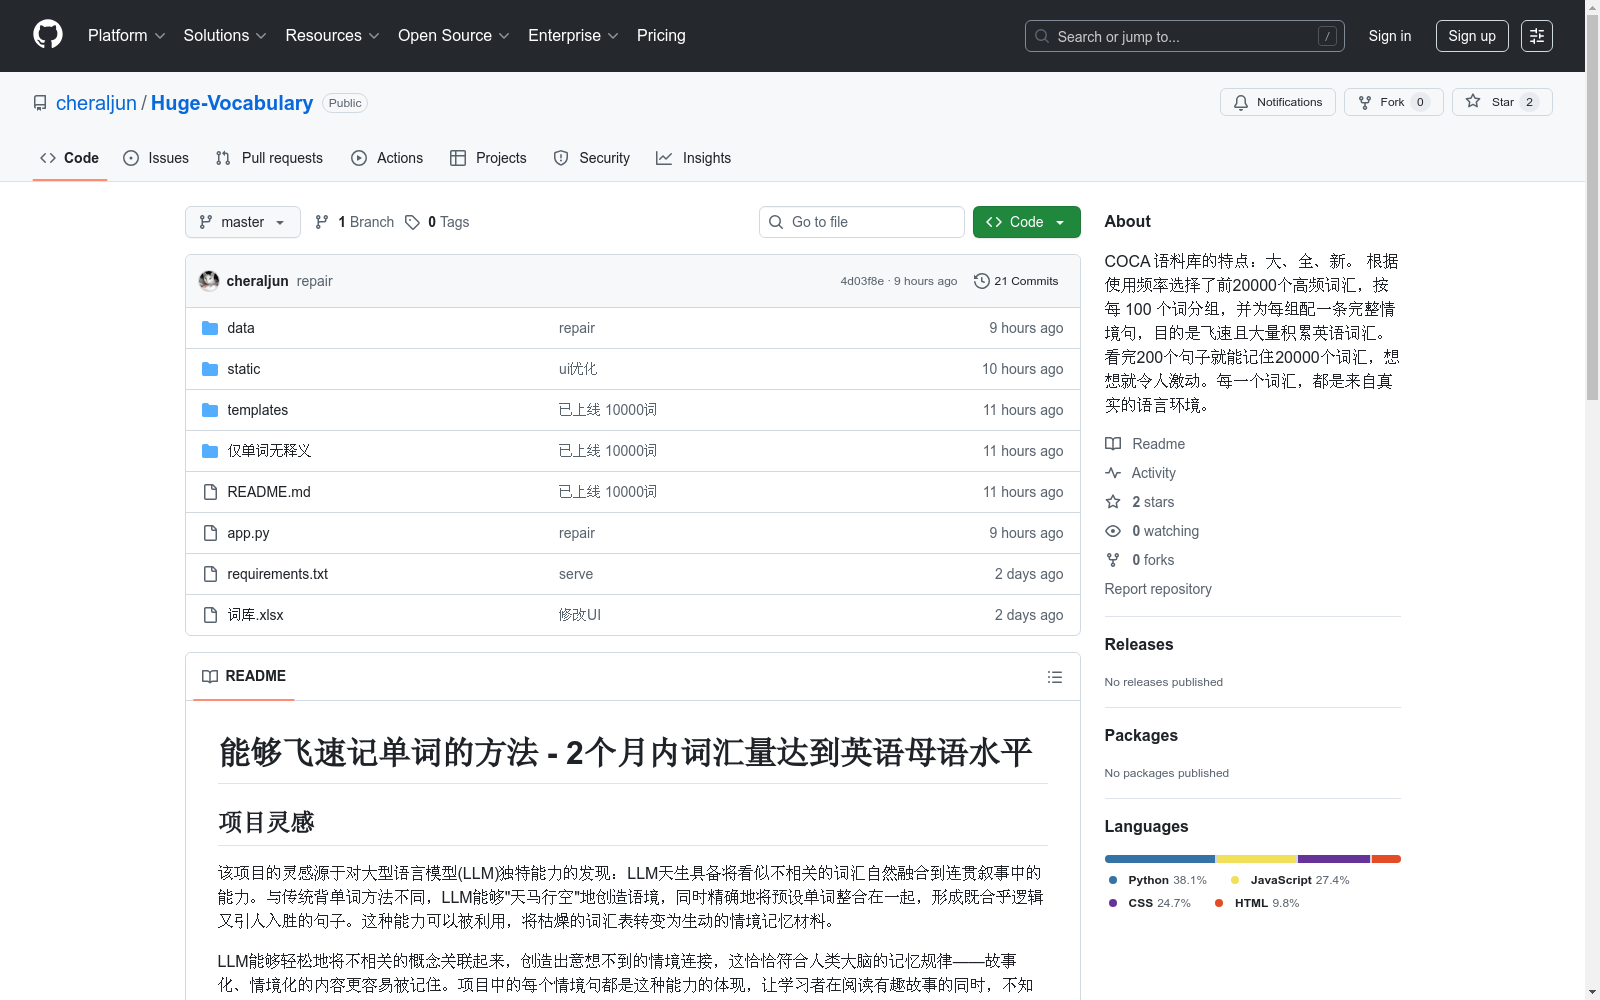
Huge Vocabulary
收藏资源简介:
Huge Vocabulary是一个基于COCA(当代美国英语语料库)构建的大型英语词汇数据集,包含使用频率最高的前20,000个单词,按每100个词分组并为每组配备一条完整的情境句,旨在通过情境化方式高效记忆词汇。数据来源于覆盖口语、小说、杂志、报纸和学术期刊等多体裁的10亿词汇语料库。
Huge Vocabulary is a large-scale English vocabulary dataset built upon the Corpus of Contemporary American English (COCA). It includes the top 20,000 most frequently used English words, which are grouped into batches of 100 words per group, with each group paired with a complete situational sentence. This dataset is designed to facilitate efficient vocabulary memorization via contextualized learning approaches. The corpus it draws from contains 1 billion words across multiple genres, including spoken language, fiction, magazines, newspapers, and academic journals.
Huge Vocabulary 数据集概述
项目简介
Huge Vocabulary 是一个利用大型语言模型(LLM)能力将高频英语词汇融合到连贯叙事中的词汇学习工具。该项目旨在通过情境记忆方法,帮助学习者在2个月内达到英语母语水平的词汇量。
核心特点
- 情境记忆:将高频词汇自然整合到连贯叙事中,形成生动的情境记忆材料。
- 词库规模:基于COCA英语语料库,筛选使用频率最高的前20,000个单词,每100个词配一条完整情境句。
- 当前进度:已更新到7,000词,持续更新中。
主要功能
- 情境句学习:每个文件包含100个高频词的情境句,单词以
[[word]]标记,网页中显示为可点击词块。 - 查词功能:点击单词查看音标、释义等详细信息。
- AI辅助:集成简单翻译功能,可根据需求调整AI提示词做其他用途。
- 移动适配:四个视图(数据库/情境句/查词/AI对话)适配各种设备。
词库来源
- COCA语料库:全球最大的英语语料库,覆盖超过10亿词汇,来源包括口语、小说、主流杂志、报纸和学术期刊五大体裁。
- 词汇筛选:从中筛选出使用频率最高的前20,000个单词。
文件说明
data/*.txt:情境句文件,每文件包含100个高频词。词库.xlsx:原始词库数据,包含单词、音标、释义。
使用方式
-
在线使用:主站 http://vocabulary.top
-
本地部署: bash pip install -r requirements.txt python app.py
浏览器访问
http://127.0.0.1:5000即可使用本地版本。
社区与支持
- 学习社区:可加入单词学习交流群,分享学习经验和心得。
- 问题反馈:添加微信
yes_smile_peace进行讨论。 - 项目支持:欢迎点个Star支持项目继续完善。
- 内容贡献:发现好的学习素材或情境句,欢迎通过PR分享。