
Itache/1000size-qwen3-embedding-4b_search-r1_filtered
收藏官方服务:
资源简介:
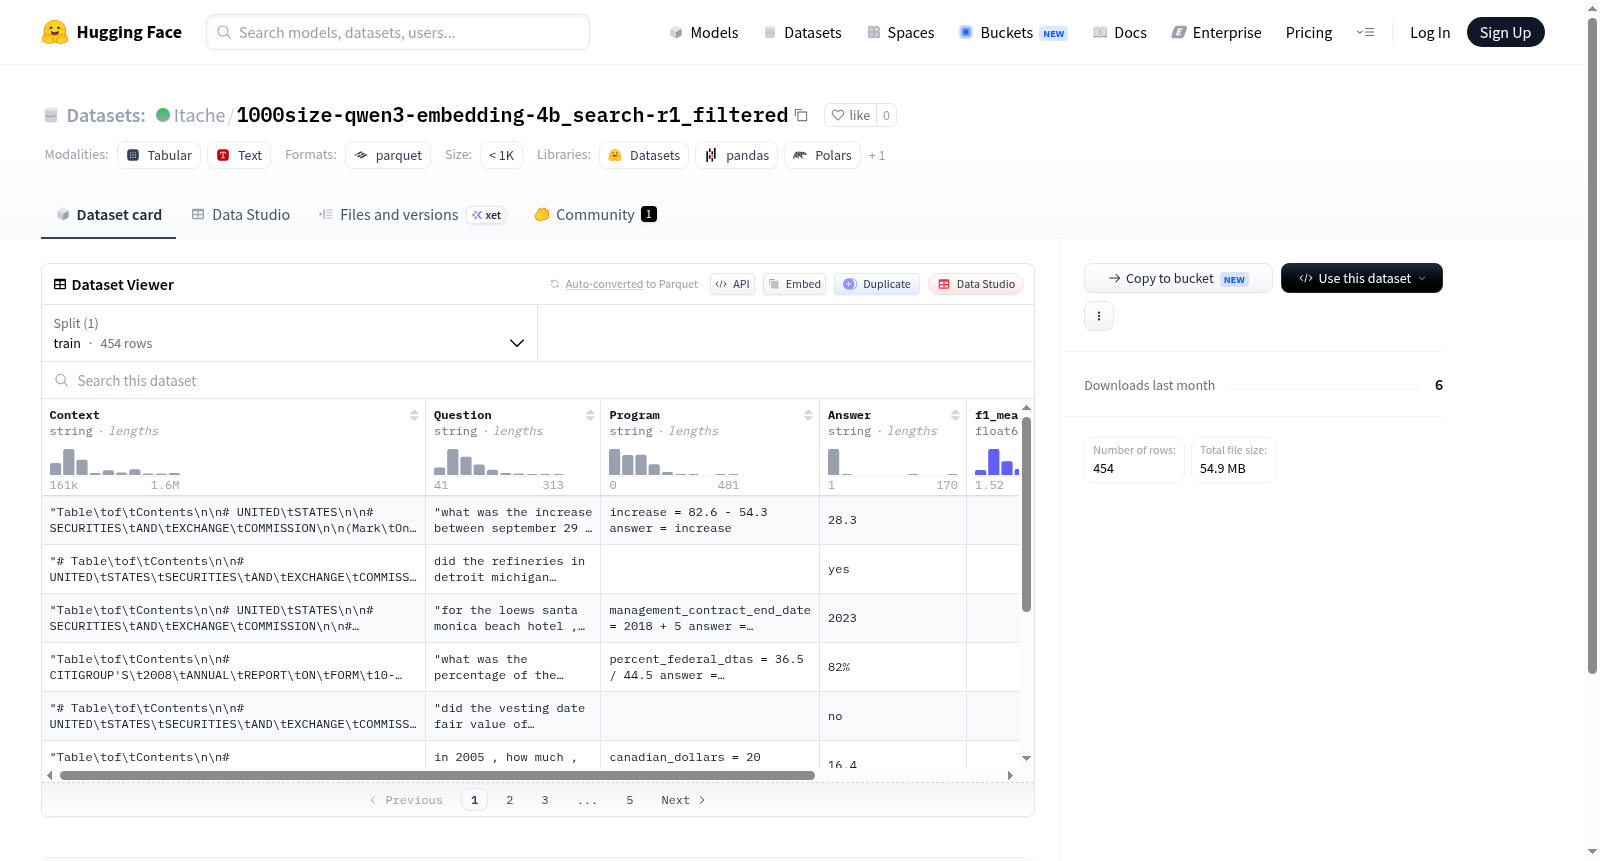
DocFinQA是一个金融文档问答数据集,旨在支持金融领域的自然语言处理任务。该数据集包含金融文档的上下文、基于上下文的问题、用于生成答案的程序代码、标准答案以及评估指标(平均F1分数和标准差)。数据集包含454个训练示例,适用于训练和评估金融文档理解、问答系统和程序生成模型。
DocFinQA is a financial document question-answering dataset designed to support natural language processing tasks in the financial domain. The dataset includes contexts from financial documents, questions based on these contexts, program code for generating answers, standard answers, and evaluation metrics (mean F1 score and standard deviation). It contains 454 training examples and is suitable for training and evaluating models for financial document understanding, question-answering systems, and program generation.
提供机构:
Itache搜集汇总
数据集介绍
构建方式
该数据集基于DocFinQA基准构建,原始数据经过精细化筛选与处理。采用Qwen3-Embedding-4B模型对文档进行稠密向量化表示,结合搜索算法(Search)与强化过滤策略(R1 Filtered),从大规模候选池中提取出高质量、高相关性的问答对。每个样本包含上下文、问题、程序逻辑与答案字段,精简至454条训练实例,确保数据密度与任务适配性。
特点
数据集以金融文档推理为核心,聚焦于复杂数值计算与逻辑程序生成,体现了对领域级问答的高精要求。利用嵌入模型筛选增强了上下文与问题的语义对齐度,而通过f1_mean与f1_std字段记录模型性能稳定性,为多轮评估提供可信指标。其以小规模高质量样本支撑深度学习的微调优化,彰显了精炼数据在指令微调与检索增强生成中的显著价值。
使用方法
适用于监督式微调与评估,尤其在金融文本解析与数值推理任务中表现突出。用户可将Context和Question作为模型输入,以Answer或Program为目标进行训练,或利用其构建检索增强管道。建议配合Qwen系列嵌入模型进行嵌套索引与相似度匹配,以复现过滤流程并扩展至其他垂直领域。
背景与挑战
背景概述
在金融文档智能处理领域,复杂的数值推理与逻辑演绎能力是评估大型语言模型实用性的核心指标。DocFinQA数据集应运而生,它聚焦于金融报告中的多步数值推理任务,要求模型从冗长、结构化的文档中提取关键信息、执行链式计算并生成精确答案。该数据集由研究团队在金融与自然语言处理的交叉领域构建,旨在弥补现有问答数据集在长文档、多步骤推理场景下的不足。通过对包含450余条训练样本的文档-查询对进行深度标注,DocFinQA为评估和提升模型在金融场景中的逻辑推理与数值稳定性提供了标准化基准,对推动金融风控、自动审计等应用的发展具有深远意义。
当前挑战
DocFinQA数据集面临的核心挑战首先源于其解决的领域问题:金融文档中数值关系的复杂性与歧义性。模型需在数十页的财务报表、招股说明书中精准定位分散的数值,并遵循隐性的业务逻辑(如折旧计算、现金流推导)执行多步运算,这对上下文理解与算术推理构成双重考验。其次,在数据集构建过程中,标注人员需将非结构化文本转化为可执行的符号化程序(Program字段),这一过程高度依赖领域知识,导致标注成本高昂且难以保证一致性。此外,样本数量仅454条,限制了模型在分布外场景的泛化能力,并可能引入标注偏差,影响基准的可靠性。
常用场景
经典使用场景
在金融文档智能分析领域,DocFinQA数据集作为专门针对复杂金融文档的问答基准,其经典使用场景聚焦于评估和提升模型对结构化财务报告、招股说明书及年度报表的深度理解能力。通过将长篇文档分割为上下文片段,并配以精确的数值型问题与程序化推理路径,该数据集要求模型不仅具备文本检索能力,更需掌握多步数值计算与逻辑演绎,成为检验大规模语言模型在财经场景下推理稳健性的黄金标准。
解决学术问题
DocFinQA的出现,精准回应了金融自然语言处理中‘长文档数值推理’这一长期未决的学术挑战。传统问答数据集多聚焦于事实抽取或简单计算,难以衡量模型对包含表格、图表和复杂文本交织的财务文档的全局理解。该数据集通过引入程序化答案格式与基于F1均值的多粒度评估指标,迫使研究者突破单纯语义匹配的局限,推动了可解释性推理、结构化信息融合及跨段落数值对齐等子课题的纵深发展。
衍生相关工作
基于DocFinQA的设计理念,研究者已开发出一系列衍生工作。例如,FinQANet在原始数据基础上引入对抗性样本增强,测试模型对财务措辞变体的鲁棒性;而Program-Aided Reasoning架构则借鉴其程序化标签格式,将推理步骤显式编码为可执行的运算序列,显著提升了数值计算的透明度。另有工作将其与表格问答数据集HybridQA联合训练,探索多模态金融文档的联合表征,这些成果共同勾勒出财务推理领域从基准测试向实用化迈进的技术脉络。
以上内容由遇见数据集搜集并总结生成


