
NJU-LINK/OmniCap-IF
收藏官方服务:
资源简介:
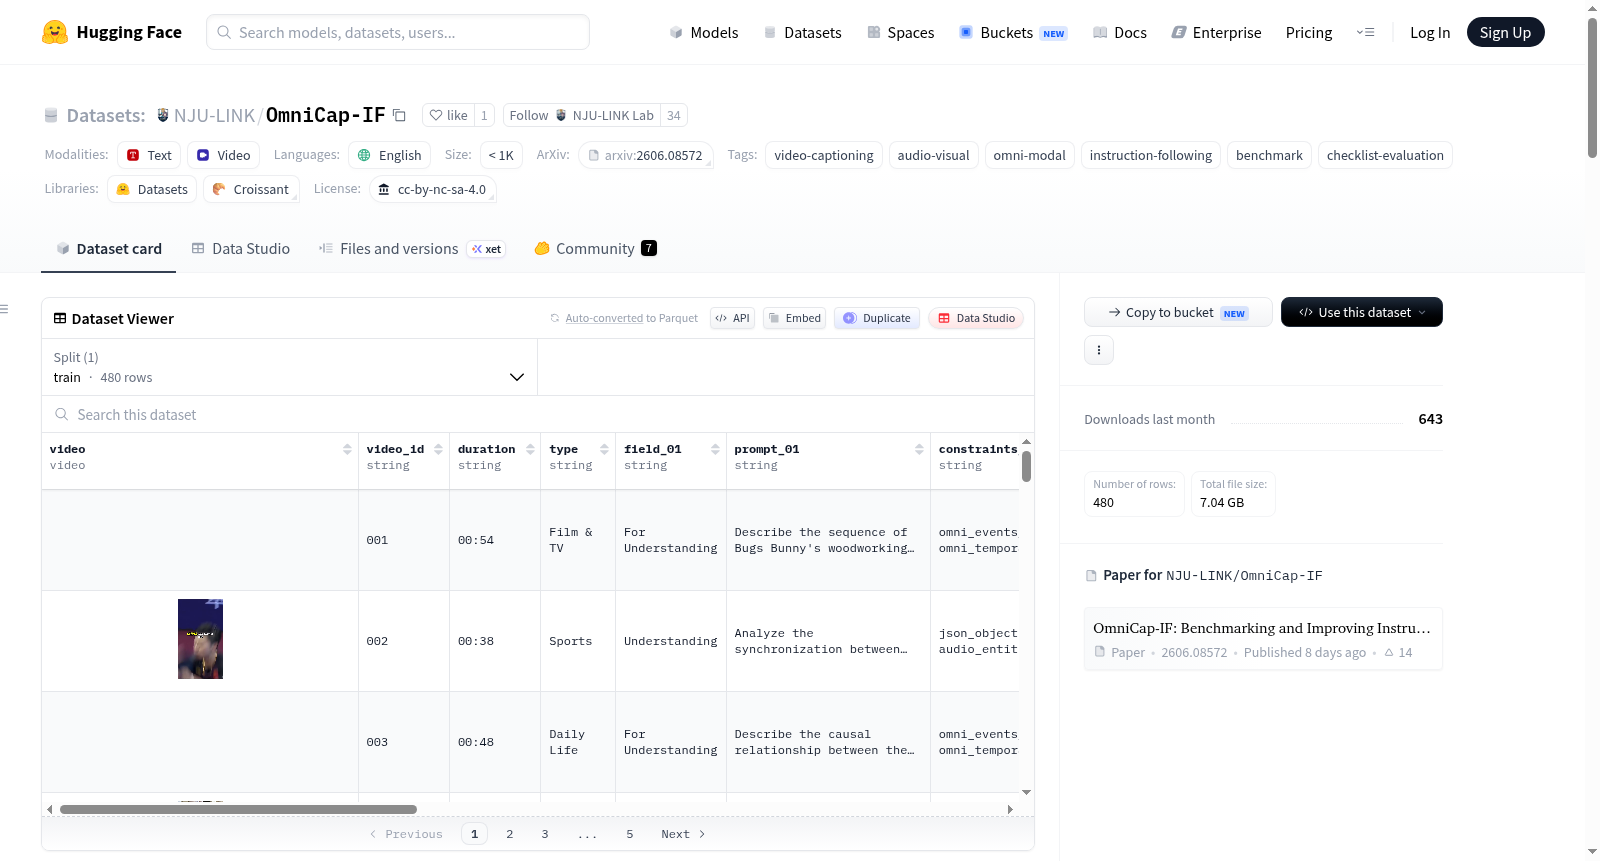
OmniCap-IF是一个用于评估全模态视频描述中指令跟随能力的基准数据集。它包含480个视频和1,920个指令样本,涵盖理解、生成、检索和面向通信的描述任务。每个样本将一个提示与细粒度的格式和内容检查清单配对,用于评估模型是否遵循结构、时间、视觉、音频和视听约束。
OmniCap-IF is a benchmark for evaluating instruction following in omni-modal video captioning. It contains 480 videos and 1,920 instruction samples spanning understanding, generation, retrieval, and communication-oriented captioning tasks. Each sample pairs a prompt with fine-grained format and content checklists for evaluating whether a model follows structural, temporal, visual, audio, and audio-visual constraints.
提供机构:
NJU-LINK搜集汇总
数据集介绍
构建方式
OmniCap-IF是一个面向全模态视频描述中指令跟随能力评估的基准数据集。其构建过程依托于精心采集的480条多样化视频素材,并通过系统化设计生成包含理解、生成、检索及面向交流的描述任务在内的1920个指令样本。每个样本不仅包含细粒度的提示信息,还配备了格式与内容双重核查清单,用以检查模型在结构、时序、视觉、音频以及视听融合等维度上是否满足用户约束。数据集的标注体系以视频ID为核心,每条视频映射四个不同类型的提示级样本,确保评估的全面性与层次性。
使用方法
使用者可通过Hugging Face提供的下载命令获取完整数据集,包括视频文件、提示标注与核查清单。评估时,需将待评模型的输出按视频ID与提示ID的格式存放于response目录下,并通过执行主评估脚本调用LLM裁判模型,基于核查清单计算格式遵从率与内容遵从率等指标。该流程要求用户提供LLM裁判的API密钥与端点地址。数据集采用CC-BY-NC-SA-4.0许可协议发布,配套完整的项目代码与模型权重(包括7B与3B两种规模),便于研究者复现实验与开展基准测试。
背景与挑战
背景概述
多模态视频描述是连接视觉、听觉与语言理解的核心任务,近年来随着全模态模型的兴起,对模型在复杂约束下遵循指令生成内容能力的需求日益迫切。由南京大学LINK实验室王嘉豪等人于2026年创建的OmniCap-IF基准数据集,旨在系统评估全模态视频描述中的指令跟随能力。该数据集包含480个视频和1920条指令样本,覆盖理解、生成、检索和通信导向的描述任务,每个样本均配有细粒度的格式与内容检查表,用以评估模型在结构、时间、视觉、音频及视听联合约束下的表现。OmniCap-IF的提出填补了现有视频描述基准在指令跟随精细化评估上的空白,为全模态视频理解与生成领域的研究提供了重要的评价标尺。
当前挑战
OmniCap-IF所解决的领域核心挑战在于,现有视频描述模型往往仅关注生成内容的通用质量,而忽视了用户对输出格式、时间戳定位、事件源归属、音频可见性及视听因果关系等显式约束的遵循。该数据集的构建过程同样面临多重困难:视频来源需涵盖广泛类别与时长的同时,确保每个样本具备多样化的指令类型与约束组合;注释阶段需构建既包含格式检查(如JSON数组、大小写)又可量化内容正确性(如事件时序、视听对应)的细粒度检查表,这对标注规范和一致性提出了极高要求。此外,如何设计评估指标以准确反映模型对多维度约束的遵循程度,亦是该基准构建中的关键挑战。
常用场景
经典使用场景
在跨模态视频理解与生成领域,OmniCap-IF 被设计为一个精细化的指令遵循基准测试集,用于评估全模态视频描述模型在严格约束下的表现。该数据集包含480段覆盖多类场景的视频,并配备了1,920条指令样本,每条指令均配套细粒度的格式与内容检查清单。模型需要同时满足结构(如JSON输出、表格格式)、时间(如时间戳)、视觉、音频以及音视频联合约束。这使得OmniCap-IF成为衡量视频描述系统是否具备精准、可控输出能力的核心测试平台。
解决学术问题
该数据集系统性地解决了当前视频描述任务中普遍存在的指令遵循能力评估缺失问题。传统评测多聚焦于描述文本的泛化质量,忽略了用户对输出格式、时间定位、事件溯源及音频可见性等显性约束的满足程度。OmniCap-IF通过引入格式与内容双重检查机制,揭示了现有模型在结构化输出、细粒度时间锚定及音视频因果建模方面的显著短板,为构建更可靠、可控的全模态视频理解系统提供了理论依据与评测基准。
实际应用
在实际应用中,OmniCap-IF 对视频内容管理系统、无障碍服务、智能检索及多模态对话系统具有直接推动作用。例如,在视频档案数字化存储中,模型需按照指定JSON结构输出带时间戳的事件描述;在辅助视障人士理解视频内容时,需明确区分视觉与音频事件来源。该数据集为这些真实场景下的模型部署提供了严格的验证标准,确保生成的描述既富有信息量,又严格遵循用户设定的格式与内容规范。
数据集最近研究
最新研究方向
OmniCap-IF数据集聚焦于全模态视频描述中的指令跟随能力评估,是当前多模态理解与生成领域的前沿研究方向。该基准涵盖480个视频与1920个指令样本,横跨理解、生成、检索及面向通信的描述任务,通过细粒度格式与内容检查清单,系统检验模型在结构约束、时间推理、视觉、听觉及跨模态因果逻辑等方面的遵循程度。这一工作呼应了多模态大模型在复杂场景下精确响应人类指令的热点需求,其基于清单的评估范式为构建更可靠、可控的视频描述系统提供了关键方法论支撑,有望推动具身智能与视频交互领域的发展。
以上内容由遇见数据集搜集并总结生成


