music-mood-recs-assets
收藏资源简介:
本数据集是music-mood-recs非商业学生深度学习课程项目的衍生资源,旨在支持音频情绪分类与基于内容推荐(使用单一CNN模型)的演示应用运行。数据集包含从MTG-Jamendo数据集(情绪/主题子集,30-TAR样本)中提取的2,247条音轨及其处理后的特征,具体包括:原始音频的低码率MP3文件、预计算的对数梅尔频谱图(.npy格式)、每条音轨的64维CNN分类嵌入向量,以及用于索引的音轨清单文件(CSV格式)。数据来源于MTG-Jamendo数据集,其元数据遵循CC BY-NC-SA 4.0许可,而音频文件则根据原始上传者选择的多种Creative Commons许可(包括CC BY-NC-SA、CC BY-NC-ND、CC BY-SA等)进行分发。该数据集及其镜像仅限用于非商业研究和学术目的。
This dataset is a derivative resource from the music-mood-recs non-commercial student deep learning course project, designed to support the operation of a demo application for audio mood classification and content-based recommendation (using a single CNN model). It contains 2,247 tracks extracted from the MTG-Jamendo dataset (mood/theme subset, 30-TAR samples) along with processed features, including: low-bitrate MP3 files of the original audio, precomputed log-mel spectrograms (.npy format), 64-dimensional CNN classification embedding vectors for each track, and a track inventory file (CSV format) for indexing. The data is sourced from the MTG-Jamendo dataset, with metadata licensed under CC BY-NC-SA 4.0, while audio files are distributed under various Creative Commons licenses chosen by the original uploaders (including CC BY-NC-SA, CC BY-NC-ND, CC BY-SA, etc.). This dataset and its mirrors are intended solely for non-commercial research and academic purposes.
数据集概况
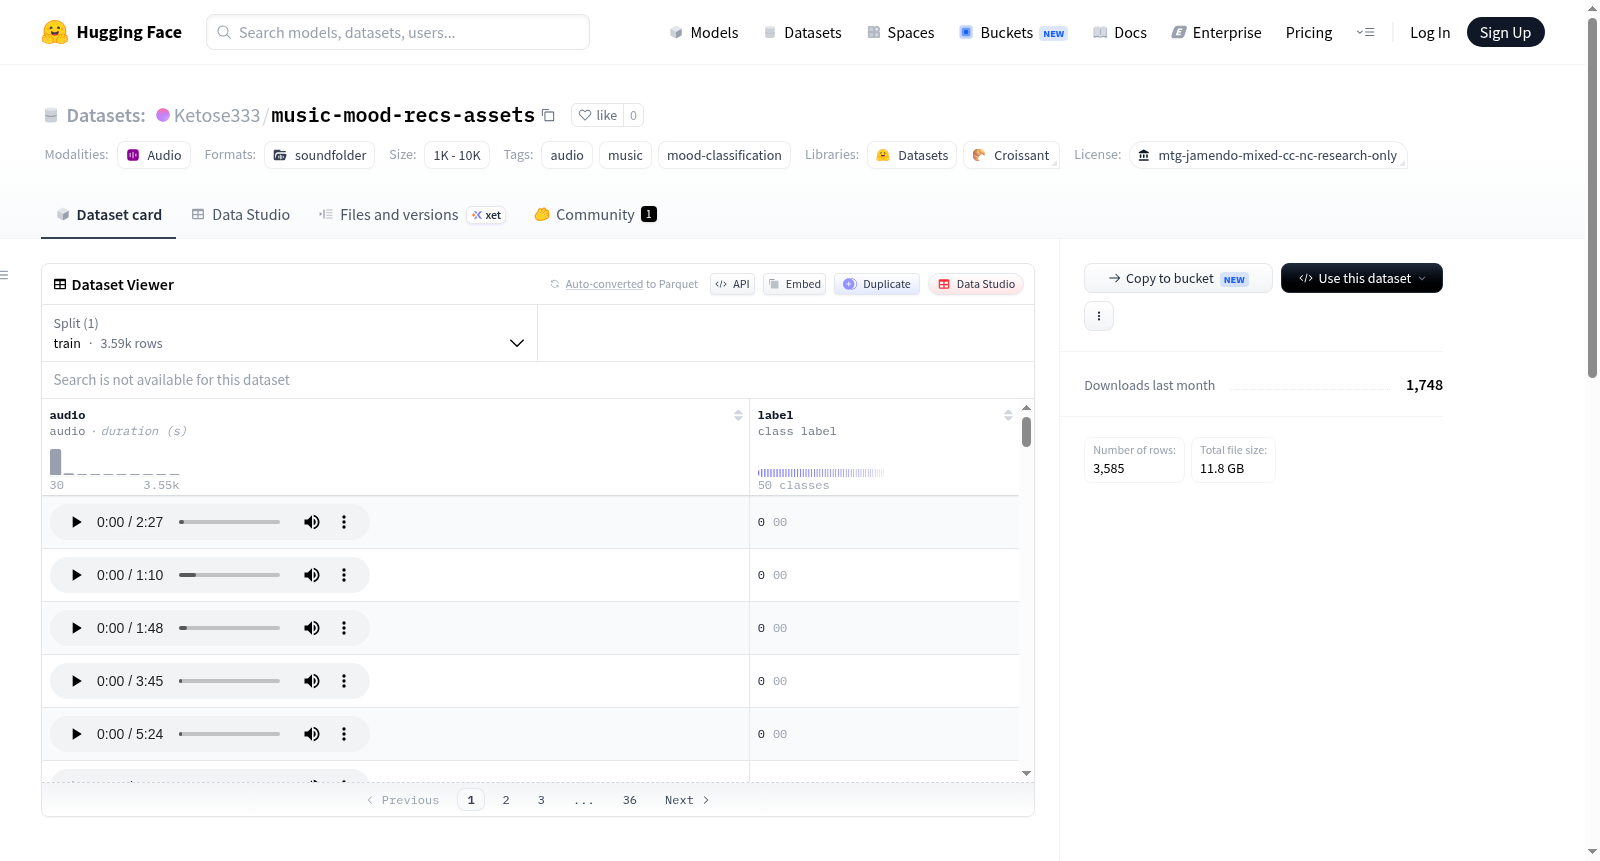
该数据集是 music-mood-recs 项目的衍生资产,源自 MTG-Jamendo Dataset(情绪/主题子集),包含 3,585 首曲目。其存在目的是为项目的 Streamlit 演示应用提供运行时所需的文件,避免将约 7GB 数据直接捆绑到 Git 仓库中。
来源与许可
- 源数据集:MTG-Jamendo Dataset(情绪/主题子集,50-TAR 样本),访问地址:https://github.com/MTG/mtg-jamendo-dataset
- 元数据许可:CC BY-NC-SA 4.0
- 音频许可:每首曲目由 Jamendo 上传者指定单独的 Creative Commons 许可。权威的逐曲目艺术家署名及许可信息见 audio_licenses.txt。
- 使用限制:MTG-Jamendo Dataset 仅限非商业研究和学术用途。其他用途(包括商业用途)需获得 Jamendo S.A. 的书面授权。此镜像仅用于支持上述非商业课程作业用例。
- 许可类型:other(标签
license_name: mtg-jamendo-mixed-cc-nc-research-only)
数据集内容
该镜像托管以下数据:
data/audio/— 3,585 首曲目的低比特率 MP3 音频文件artifacts/melspecs/— 预计算的对数梅尔频谱图(.npy格式)artifacts/embeddings.npy— CNN 分类嵌入矩阵(每首曲目 64 维)artifacts/melspec_manifest.csv— 梅尔频谱图清单文件artifacts/subset_meta.csv— 曲目元数据清单文件
相关标签与名称
- 标签:audio、music、mood-classification
- 正式名称:music-mood-recs assets (MTG-Jamendo mood/theme subset mirror)
额外说明
此镜像仅托管 Streamlit 应用运行时所需的衍生数据。报告的图表以及项目自身的下载/训练脚本位于主仓库(Ketose333/music-mood-recs),不在此处。