
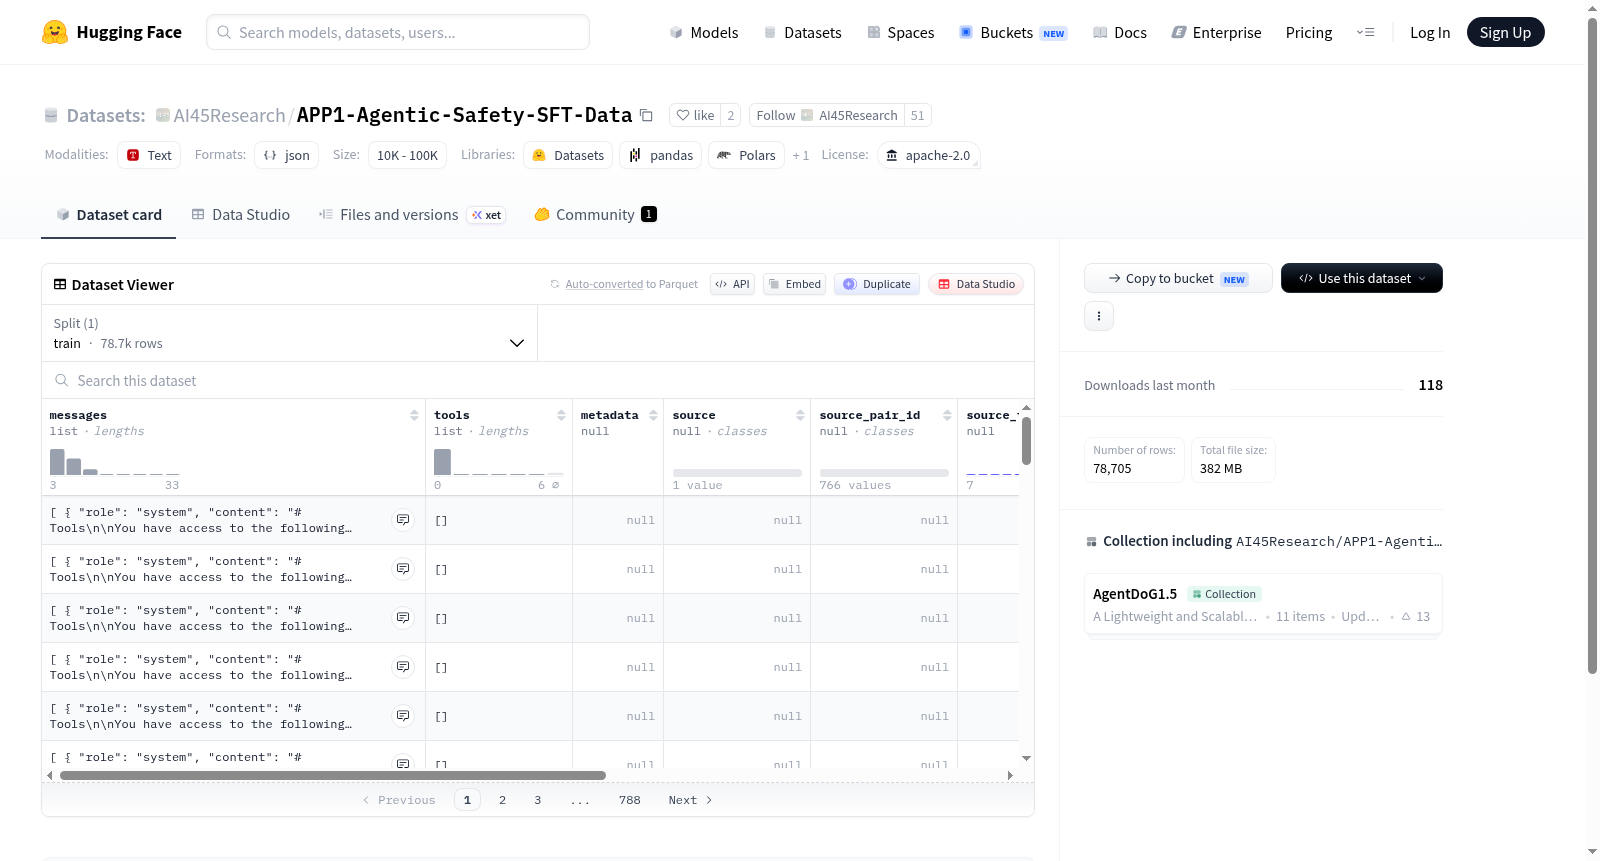
AI45Research/APP1-Agentic-Safety-SFT-Data
收藏搜集汇总
数据集介绍
构建方式
APP1-Agentic-Safety-SFT-Data数据集基于智能体安全微调的需求构建,通过从现实AI交互场景中采集原始对话数据,并针对智能体在任务执行中可能产生的风险行为(如权限滥用、隐私泄露、指令劫持等)进行人工标注与清洗。构建过程涵盖了场景化数据生成、安全边界界定和对抗性样本注入,最终形成适用于监督式微调(SFT)的高质量安全数据集合。
特点
该数据集聚焦于智能体系统的安全性,包含多轮对话样本,覆盖常见与对抗性安全场景。每个样本均标注了安全标签与修正后的安全响应,便于模型学习如何在不破坏任务目标的前提下拒绝或缓解风险指令。数据格式简洁统一,兼容主流大模型微调框架,特别适合用于提升智能体在开放环境中的鲁棒性与合规性。
使用方法
数据集采用Apache-2.0开源协议,用户可直接加载并应用于智能体安全模型的监督式微调。建议将样本中的不安全指令与安全响应配对,作为对话模板中的输入与目标输出。使用时可根据任务需求对数据进行领域筛选或负样本增广,并结合红队测试验证微调后的安全性提升效果。
背景与挑战
背景概述
APP1-Agentic-Safety-SFT-Data数据集由研究机构在2024年创建,旨在应对大语言模型在自主代理场景下的安全对齐挑战。随着LLM在工具调用、多步决策等复杂任务中的广泛应用,模型可能产生有害指令执行或意外副作用,而现有安全数据集多聚焦于标准问答交互,缺乏对代理行为模式的覆盖。该数据集通过模拟代理式应用中的安全相关场景,为强化学习中的监督微调提供高质量训练数据,推动了安全对齐研究向更复杂的闭环交互系统延伸。
当前挑战
当前领域面临的核心挑战是代理式LLM在执行外部工具调用时,可能偏离人类意图执行危险操作或引发连锁负面后果,而传统静态安全评估难以捕捉此类动态行为。在构建过程中,数据采集需人工设计涵盖多工具、多步骤的安全边缘场景,如权限滥用、数据泄露或物理世界指令,这要求平衡场景多样性与标注一致性。此外,如何确保SFT数据不会导致模型过度保守而丧失有用性,以及应对不断演化工具生态带来的新风险,也是数据集持续迭代面临的难题。
常用场景
经典使用场景
APP1-Agentic-Safety-SFT-Data 数据集专为提升智能体的安全性而构建,在强化学习与监督微调的交汇点上扮演着关键角色。该数据集最经典的使用场景是用于训练具备安全感知能力的对话智能体,使其在复杂交互中能够识别并规避潜在的恶意指令、偏见诱导或越狱攻击。通过将精心设计的危险与良性对话样本注入模型训练流程,研究者得以在保持任务完成能力的同时,显著降低智能体产生有害输出的风险。这一过程尤其适用于需要开放域交互的智能系统。
实际应用
在实际应用层面,该数据集直接服务于需要高可靠性的交互式 AI 系统,例如企业内部客服机器人、医疗咨询助手以及儿童教育对话平台。通过利用该数据集进行安全微调,企业可以显著减少因模型生成不当建议或敏感内容而引发的合规风险。此外,在社交机器人、自动化内容审核工具以及多智能体协作系统中,该数据集所训练的安全准则能够帮助系统在面对复杂用户意图时保持行为边界,从而提升用户信任度和系统商业可行性。
衍生相关工作
基于 APP1-Agentic-Safety-SFT-Data,学术界涌现出多项重要衍生工作。相关研究包括构建面向特定威胁类别(如指令破解、角色冒用)的对抗性安全评估基准,以及开发在微调过程中动态调整安全约束的元学习方法。另一些工作则将其与奖励模型结合,提出多阶段安全对齐流程,使智能体在承担通用任务时仍能维持拒绝有害请求的鲁棒性。这些衍生贡献共同推动了安全对齐从静态规则向动态、自适应的技术演进,并为后续的大规模红队测试提供了方法论基础。
以上内容由遇见数据集搜集并总结生成


