
GenueAI/Matrix2-Pretrain-25k
收藏官方服务:
资源简介:
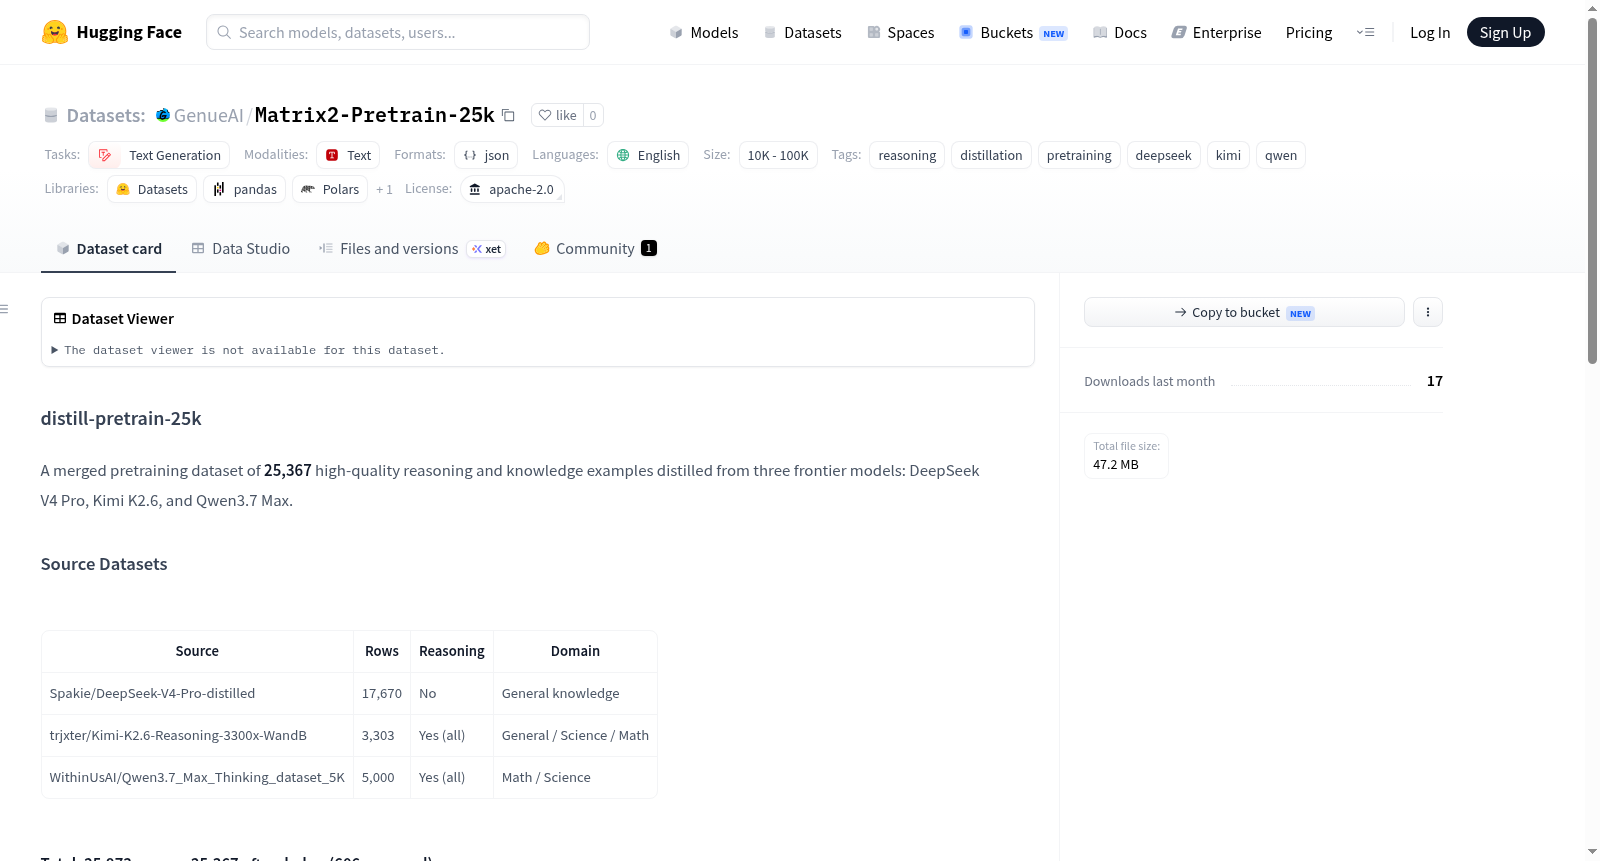
distill-pretrain-25k 是一个合并的预训练数据集,包含 25,367 个高质量推理和知识示例,这些示例从三个前沿模型中蒸馏而来:DeepSeek V4 Pro、Kimi K2.6 和 Qwen3.7 Max。数据集用于文本生成任务,特别强调推理、蒸馏和预训练,涵盖通用知识、科学和数学领域。数据格式为 JSONL,每行包含一个文本字段,其中部分行包含推理痕迹。数据集适用于语言模型的持续预训练(尤其是 7B-14B 规模)、推理蒸馏(从前沿教师模型中学习链式思维模式)以及知识注入(吸收跨通用、科学和数学领域的高质量答案)。
A merged pretraining dataset of 25,367 high-quality reasoning and knowledge examples distilled from three frontier models: DeepSeek V4 Pro, Kimi K2.6, and Qwen3.7 Max.
提供机构:
GenueAI搜集汇总
数据集介绍
构建方式
Matrix2-Pretrain-25k数据集通过整合来自DeepSeek V4 Pro、Kimi K2.6和Qwen3.7 Max三种前沿大语言模型的知识蒸馏结果构建而成。原始数据总计25,973条,经过严格的去重处理后保留25,367条高质量样本。构建过程以JSONL格式存储,每个数据条目包含单一的`text`字段,将用户提问、推理链与模型回答以结构化模板融合,形成适用于因果语言模型预训练的纯文本数据。数据来源涵盖无推理的通用知识、全量推理的科学数学题目以及混合推理的跨领域内容,充分保证了样本的多样性与深度。
特点
该数据集的核心特点在于其高质量的知识蒸馏属性和结构化推理表征。在25,367条样本中,超过8,300条(占比约32%)包含显式的推理/思考轨迹,源自Kimi与Qwen模型的思维链输出,为模型学习逻辑推导过程提供了珍贵素材。数据经统一清洗后约45MB大小,涵盖约45M字符与6.2M词,且以固定随机种子42进行混排确保结果可复现。按回答长度划分为两类:18,286条长格式问答(回答≥50字符)和7,687条短摘要式回答,适配不同预训练任务需求。
使用方法
该数据集专为大语言模型的继续预训练与推理蒸馏任务设计,尤其适用于7B至14B参数规模模型。用户可通过HuggingFace的`datasets`库便捷加载,调用`load_dataset("GenueAI/distill-pretrain-25k", split="train")`即可获得经过标准化处理的训练集。数据集中嵌入的推理链可被直接用作思维链监督信号,用于增强模型在数学、科学和通用知识等领域的复杂推理能力。建议在预训练阶段将原始文本直接作为因果语言模型的输入,无需额外预处理,模型将借助其高质量的Q&A结构与推理注释,逐步内化来自前沿教师模型的深层知识模式。
背景与挑战
背景概述
在大语言模型快速发展的背景下,知识蒸馏与推理能力增强成为提升模型性能的关键路径。Matrix2-Pretrain-25k数据集由GenueAI机构于近期构建,整合了来自DeepSeek V4 Pro、Kimi K2.6和Qwen3.7 Max三个前沿模型的经过蒸馏的高质量推理与知识样本,共计25,367条数据。该数据集旨在支持7B-14B规模语言模型的持续预训练、推理蒸馏以及知识注入,聚焦于通用知识、科学与数学领域的问答与思考链学习,对提升小规模模型的推理能力和领域知识掌握度具有重要影响,为开源社区提供了一种低成本获取前沿模型能力的高效途径。
当前挑战
该数据集所解决的领域核心挑战在于,如何从小规模教师模型中高效蒸馏推理与知识模式,以弥补中等规模模型在复杂推理任务上的能力差距。构建过程中面临多重挑战:首先,需从三个来源异构的数据集中去除606条重复项,确保训练数据的独特性;其次,需统一不同格式的推理追踪与问答结构,以适配因果语言模型的预训练需求;最后,在保证13%的短回答与82%的长回答数据混合时,维持数据质量与分布均衡,避免模型学习到不一致的模式,这对数据清洗与格式规范提出了较高要求。
常用场景
经典使用场景
该数据集通常被用于大语言模型的持续预训练阶段,尤其是针对7B至14B参数规模的模型。其设计初衷在于通过汇集来自DeepSeek V4 Pro、Kimi K2.6和Qwen3.7 Max三大前沿模型的优质推理与知识样本,为模型注入更丰富的世界知识和更成熟的思维链能力。研究者可直接利用其JSONL格式的文本字段进行因果语言建模训练,其中约32%的样本包含完整的推理轨迹,为模型提供了可模仿的从问题到答案的思考过程,尤其适合那些希望在预训练中提升模型复杂推理能力的探索。
实际应用
在实际应用中,Matrix2-Pretrain-25k主要赋能需要部署于受限环境的中小型大语言模型。通过使用该数据集进行持续预训练,企业或研究机构可开发出在数学、科学及通识知识问答上表现更佳的轻量级模型。例如,它可用于提升教育领域智能辅导系统的解题能力,或改进科技公司客服机器人的知识覆盖与推理准确性。其Apache 2.0的开源许可也降低了商业落地的门槛,便于开发者快速集成并迭代自有模型。
衍生相关工作
该数据集为后续研究提供了多源、多格式的蒸馏数据范式,催生了一系列相关工作。最直接的衍生方向是将其作为基线,对比不同蒸馏策略(如仅保留推理轨迹 vs. 仅保留答案)对下游模型推理能力的影响。此外,该数据集的成功构建也启发研究者探索更大规模的多源蒸馏数据集,例如融合更多领域专家模型的知识,或者针对特定语言(如中文)进行类似的高质量预训练数据收集工作。其去重逻辑和混合比例也为数据配比优化方面的学术探索提供了参考案例。
以上内容由遇见数据集搜集并总结生成


