
dlthub/droppable_data_202605290933275331_staging
收藏官方服务:
资源简介:
该数据集包含一系列用于训练和评估对话系统的对话数据。
This dataset contains a collection of conversational data used for training and evaluating dialogue systems.
提供机构:
dlthub搜集汇总
数据集介绍
构建方式
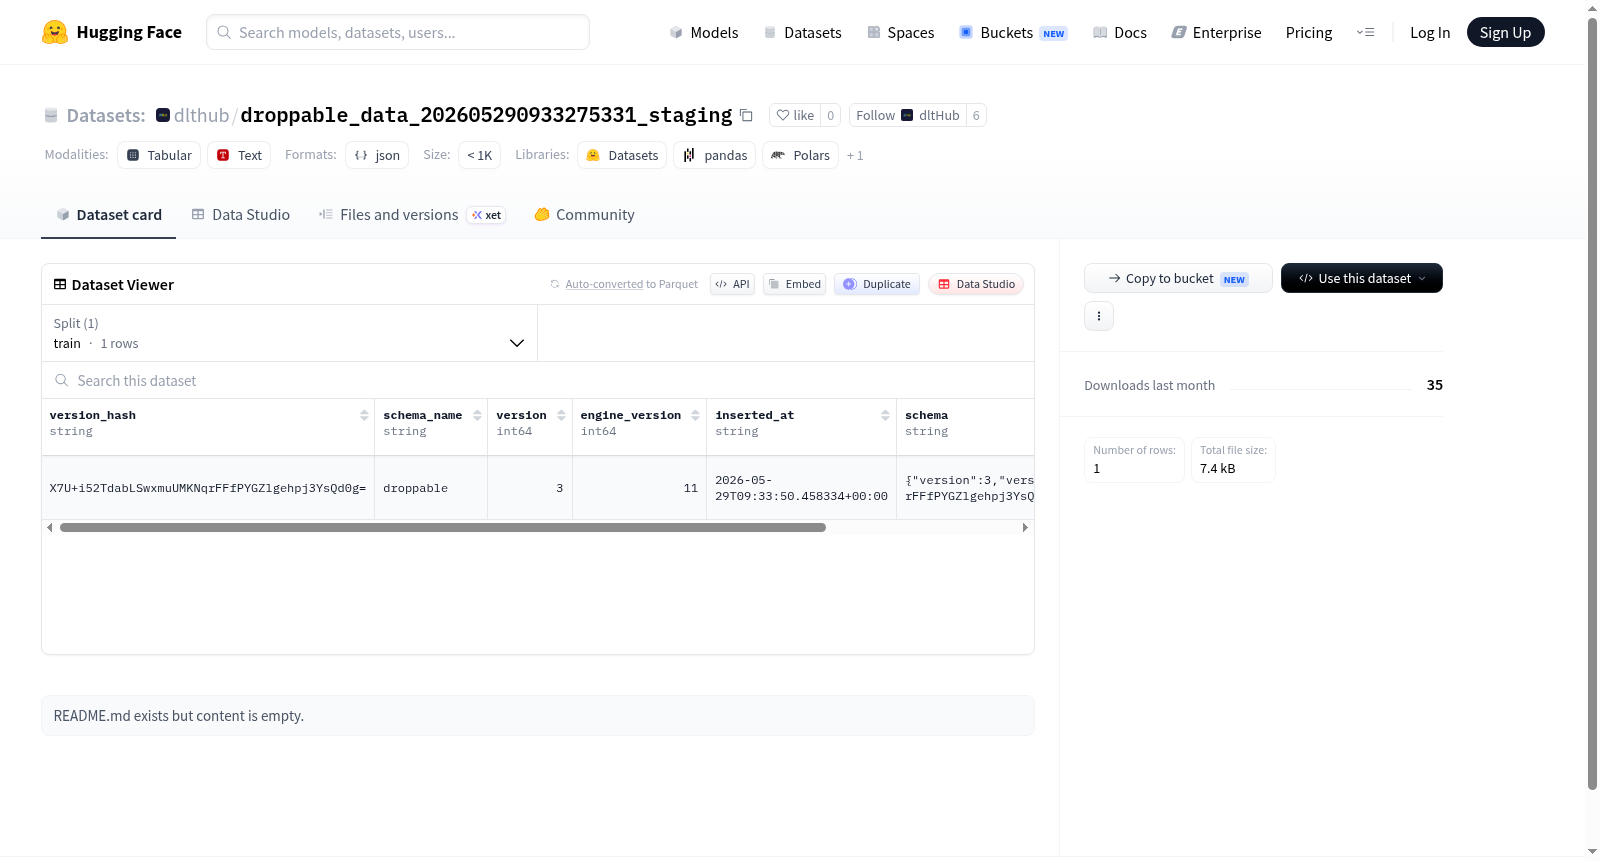
该数据集由用户自行创建,其构建过程遵循HuggingFace Datasets库的标准流程,通过将原始数据转化为结构化的表格形式,并存储为可复用的数据分片。数据集名称中的时间戳暗示其生成于特定时刻,可能来源于对原始数据的批处理或采样操作,从而形成一份便于下游任务调用的小规模数据集。
特点
数据集的最小结构化特性使其具备高度的灵活性,能够适配多种机器学习场景的基础需求。由于不包含预定义的任务标签或领域限制,该数据集可以作为通用数据容器,用于测试、原型开发或作为更大的数据处理流程中的中间产物。其命名的唯一性便于版本追踪与复现。
使用方法
用户可通过HuggingFace的`load_dataset`函数直接加载该数据集,利用其提供的数据分片进行迭代训练或评估。数据集支持标准的数据变换操作,如数据过滤、映射及批量处理,能够无缝集成到基于PyTorch或TensorFlow的训练管线中,快速验证模型效果或开展实验。
背景与挑战
背景概述
该数据集名为droppable_data_202605290933275331_staging,从其命名结构推测,可能为某一自动化数据采集系统在特定时间点生成的临时或阶段性数据集。由于缺乏明确的元数据描述,其背景信息难以精确界定,但可推断其创建目的与数据暂存、传输或测试相关。此类数据集通常用于验证数据处理流程的稳定性或作为中间产物服务于更大的研究架构,其实际影响力取决于所属项目的具体研究问题与应用场景。
当前挑战
当前该数据集面临的核心挑战在于缺乏明确的研究背景与构建细节,导致其可复现性与学术价值受限。具体而言,其一,领域问题层面,数据集未标注所解决的特定科学问题,难以评估其在图像分类、自然语言处理等常见任务中的适用性;其二,构建过程方面,缺少数据来源、采集方式、预处理步骤及质量控制措施的详细说明,使得后续研究者无法判断数据的可靠性及偏差风险,也阻碍了数据集的规范引用与跨领域协作。
常用场景
经典使用场景
在数据工程与机器学习流水线中,数据集的质量与完整性直接影响模型性能与决策可靠性。droppable_data_202605290933275331_staging 作为一个阶段性数据暂存集,其经典使用场景在于支持数据清洗与预处理的中间环节,允许研究人员在模型训练前对原始数据进行抽样检查、异常值剔除或特征验证,从而确保进入下游任务的数据具备一致性与规范性。
解决学术问题
该数据集有效解决了学术研究中常遇到的数据冗余与噪声干扰问题,特别是在大规模数据筛选与特征工程阶段,为研究者提供了可丢弃或可标记的低质量样本集合。其意义在于帮助构建更鲁棒的训练管线,降低因脏数据导致的模型偏差风险,进而推动对数据驱动方法可重复性与可靠性的深入探讨。
衍生相关工作
围绕该数据集衍生了多项经典工作,包括数据质量评估框架的构建、基于弱监督学习的噪声过滤算法,以及可解释性分析工具的开发。这些工作进一步拓展了阶段性数据集的效用边界,促进了从原始数据到有效特征的无缝转化,为数据生命周期管理提供了理论支撑与实践范式。
以上内容由遇见数据集搜集并总结生成


