
遇见数据集

phongnt251199/vietnam_heritage_wiki_chunks_v2

收藏
Hugging Face2026-05-27 更新2026-05-31 收录
官方服务:

资源简介:

--- dataset_info: features: - name: combined_text dtype: string - name: original_content dtype: string - name: metadata struct: - name: group dtype: string - name: level dtype: int64 - name: path dtype: string - name: section dtype: string - name: topic dtype: string - name: group dtype: string - name: image_urls list: string - name: best_image_url dtype: string - name: match_score dtype: float64 splits: - name: train num_bytes: 178398756 num_examples: 64124 download_size: 102351503 dataset_size: 178398756 configs: - config_name: default data_files: - split: train path: data/train-* ---

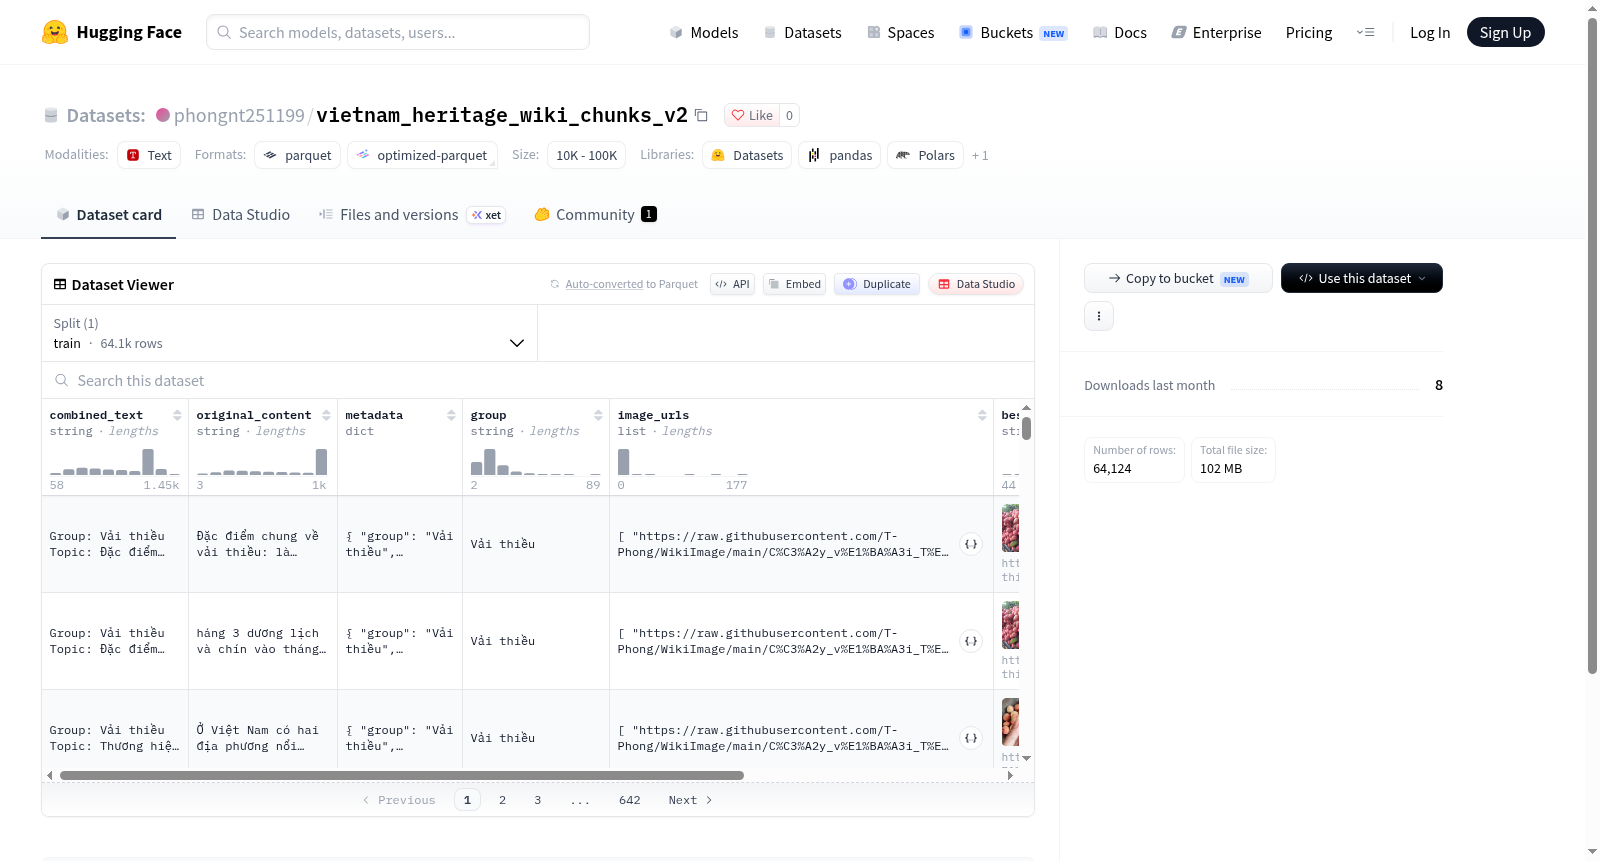
This dataset contains 64,124 training examples, each with features including: combined_text (combined text string), original_content (original content string), metadata (a structure with group, level, path, section, and topic fields), group (group string), image_urls (list of image URLs), best_image_url (best image URL string), and match_score (matching score float). The dataset may be used for text analysis, multimodal learning, or content matching tasks, but its specific purpose is not explicitly stated in the README.
提供机构:
phongnt251199
搜集汇总
数据集介绍
phongnt251199/vietnam_heritage_wiki_chunks_v2 数据集图片
构建方式
该数据集立足于越南文化遗产数字化保护的时代需求,通过对越南语维基百科中涉及遗产主题的条目进行系统化采集与语义分块处理,构建起面向知识密集型应用的语料资源。原始文本经清洗、去重与段落切分后,以多粒度分块策略重组为combined_text字段,同时保留original_content作为溯源依据。每条数据均附加结构化的metadata元信息,涵盖group、level、path、section与topic等维度,并同步提取关联图像资源,形成文本与视觉证据并重的构建范式。
特点
数据集以64124条训练实例、逾1.78亿字节的体量,呈现出越南文化遗产领域知识的广谱覆盖与细粒度组织特征。其核心特质在于文本与图像资源的联合索引,通过image_urls、best_image_url与match_score等字段建立图文语义关联,并借助group与topic等分层元数据支持主题聚类与等级化检索。这种设计既满足传统文本挖掘需求,也为多模态知识推理提供了可扩展的底层结构。
使用方法
研究者可经由HuggingFace datasets库直接加载默认配置下的train划分,利用combined_text进行语言模型预训练或主题分类,同时调用metadata中的结构化字段实现条件过滤与分组分析。图文匹配任务可结合image_urls与match_score开展跨模态对齐研究,而original_content字段则为内容溯源与事实核查提供原始参照。该数据集适用于文化遗产知识问答、多模态检索及越南语自然语言理解等下游任务的实验与评估。
背景与挑战
背景概述
越南文化遗产的数字化保护与传承近年来备受关注,然而缺乏结构化、易于访问的多模态资源库。vietnam_heritage_wiki_chunks_v2数据集由越南研究机构与开源社区共同构建,于2024年发布,旨在为文化遗产领域提供高质量的文本-图像关联数据。该数据集基于维基百科等公开来源,通过细致的分块与元数据标注,将越南遗产相关内容整合为包含文本、分组、层级、主题及图像链接的标准化格式。其核心研究问题在于如何有效组织并利用多模态数据支持文化遗产的检索、推荐与教育应用。该数据集为越南文化遗产的智能处理提供了基础资源,推动了低资源语言环境下多模态学习的研究,对数字人文与文化遗产保护领域具有积极影响。
当前挑战
该数据集所解决的领域问题是越南文化遗产的多模态内容组织与语义关联,其挑战在于从非结构化文本中抽取遗产实体并准确映射到相关图像,同时保持文化语境的完整性。构建过程中面临的挑战包括:多源异构数据的融合与去重,确保分块后的文本与图像在语义上一致;遗产术语的标准化与多语言处理;图像匹配的准确性受限于维基百科等来源的图像质量与版权限制;此外,数据集规模有限且分布不均衡,可能导致模型在特定遗产类别上泛化能力不足,对下游任务如跨模态检索和分类构成挑战。
常用场景
经典使用场景
在文化遗产数字化与多模态学习的研究中,该数据集凭借其精心构建的文本块与图像URL配对结构,成为训练和评估跨模态检索系统的经典资源。其核心使用场景集中于视觉-文本匹配任务,研究者通过计算文本描述与图像的语义相似度,实现文化遗产影像的智能检索与自动标注,亦可用于微调多模态预训练模型,提升模型对越南遗产领域知识的表征能力。
解决学术问题
针对文化遗产研究中长期存在的多源异构数据难以整合、跨模态语义鸿沟显著的问题,该数据集提供了结构化且带有层级元数据的文本-图像对,有效支撑了低资源场景下的多模态理解与生成研究。其意义在于为东南亚文化遗产的数字化保护与知识挖掘建立可复用的基准,推动了领域内关于语义对齐、长文本分割与图像相关性建模等核心学术议题的进展。
衍生相关工作
围绕该数据集,已衍生出一系列经典工作,包括基于多模态对比学习的越南遗产图像-文本检索模型、利用层级元数据进行长文档结构化摘要的生成方法,以及面向低资源语言的文化遗产知识图谱构建研究。这些工作进一步扩展了数据集在跨语言迁移、多模态预训练和数字人文分析中的应用边界,形成了持续演进的学术生态。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

