
stefanocarrera/autophagycode_D_he_train-mercury_Qwen3-4B_strategy_trust_t1.25_g7_run1
收藏数据链接:
官方服务:
资源简介:
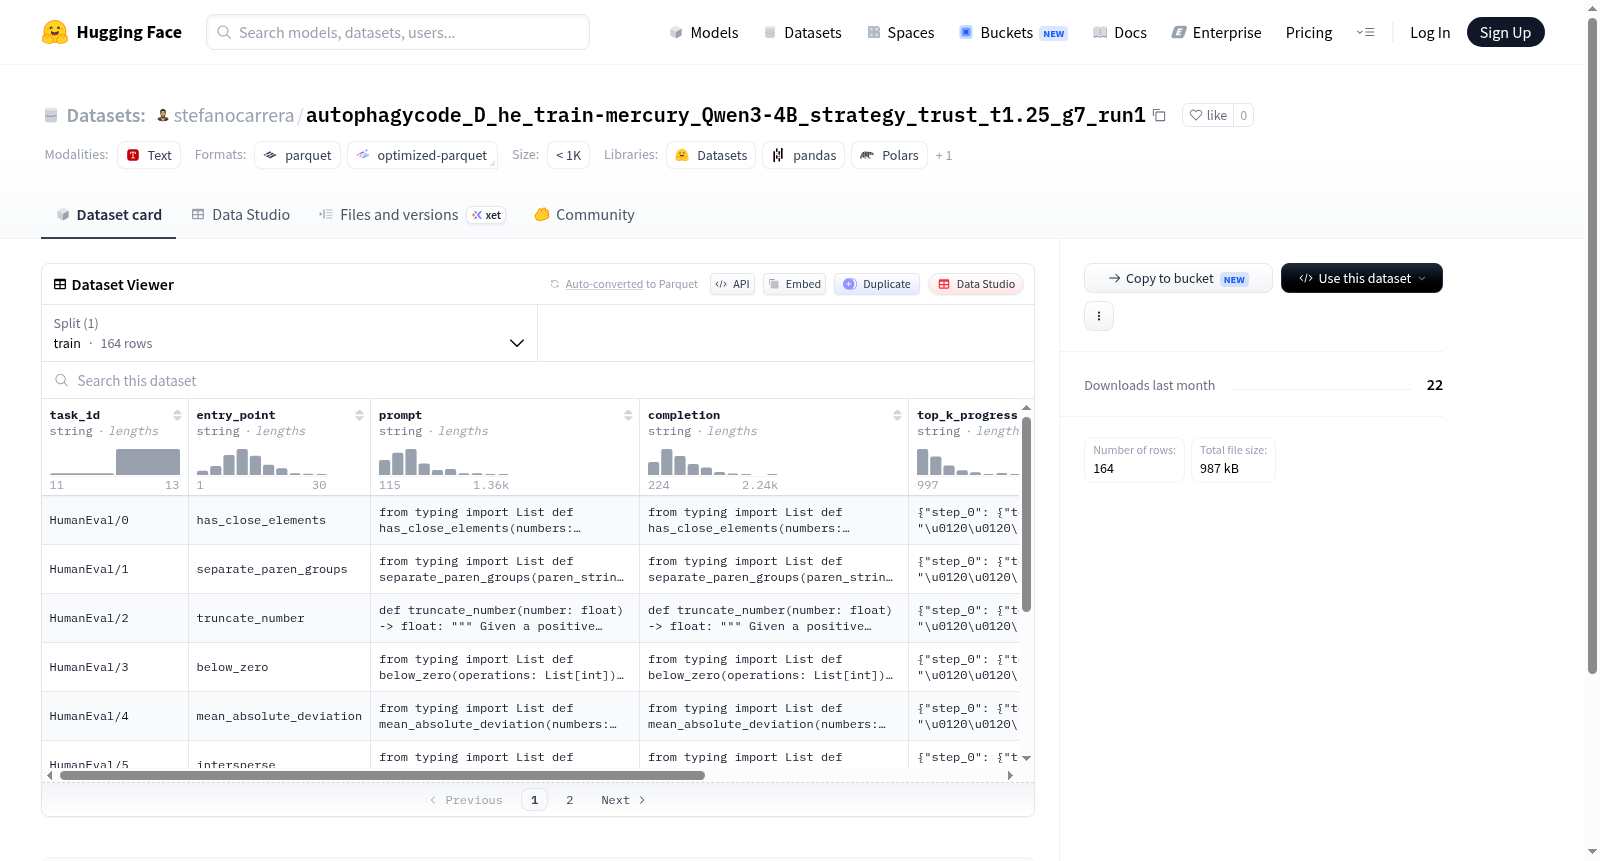
--- dataset_info: features: - name: task_id dtype: string - name: entry_point dtype: string - name: prompt dtype: string - name: completion dtype: string - name: top_k_progression dtype: string - name: test dtype: string splits: - name: train num_bytes: 3669738 num_examples: 164 download_size: 983897 dataset_size: 3669738 configs: - config_name: default data_files: - split: train path: data/train-* ---
提供机构:
stefanocarrera搜集汇总
数据集介绍
构建方式
该数据集名为autophagycode_D_he_train-mercury_Qwen3-4B_strategy_trust_t1.25_g7_run1,专为代码生成与自动推理任务设计。构建过程中,研究者以Qwen3-4B模型为基础,采用名为'信任策略'的采样方法,设定温度参数为1.25,并生成7个候选输出,从中筛选高质量代码片段,从而构建出包含164条训练样本的精炼数据集。每条样本包含任务标识、函数入口点、提示词、补全结果、top-k进展序列以及测试用例,确保数据覆盖从问题定义到验证的完整闭环。
特点
该数据集最显著的特点在于其高度结构化的多字段设计。每个样本均携带task_id、entry_point、prompt、completion、top_k_progression与test六个维度,不仅记录了输入输出对,还保留了模型推理过程中的中间进展信息,为分析模型逐步生成代码的行为提供了宝贵视角。此外,数据集规模虽小但精炼,专注于特定推理策略下的高质量代码补全,适合用于微调、评估或探究模型在受限条件下的生成性能。
使用方法
使用该数据集时,用户可通过HuggingFace的datasets库直接加载,默认配置下仅包含训练集。每条数据可被拆分为输入提示和预期补全,用于监督式微调代码模型。top_k_progression字段可辅助研究者追踪模型在不同阶段的推理轨迹,便于进行可解释性分析或对比不同采样策略的效果。测试字段中的测试用例则可用于自动验证生成代码的正确性,支持端到端的评估流程。
背景与挑战
背景概述
该数据集由autophagycode团队于近期创建,基于Qwen3-4B模型在mercury环境下的训练数据,专注于代码生成任务中的信任度评估与策略优化。核心研究问题在于如何通过top_k采样与信任策略(trust_t1.25_g7)提升语言模型在代码补全任务中的可靠性与准确性。该数据集包含164个训练样本,涵盖task_id、entry_point、prompt、completion等关键特征,旨在为代码智能领域提供细粒度的模型行为分析与训练素材。尽管规模较小,但其聚焦于特定策略下的生成质量评估,为后续大规模代码生成模型的信任机制研究奠定了实验基础,尤其在强化学习与代码安全交叉领域具有启发性价值。
当前挑战
当前该数据集面临的主要挑战包括:领域问题层面,代码生成模型常因采样策略不当导致输出结果不可靠,尤其在逻辑复杂或边界条件模糊的任务中,模型容易生成功能正确但语义谬误的代码,该数据集旨在通过信任参数t=1.25与组大小g=7的约束降低此类风险。构建过程中,由于训练数据仅164例,样本量有限可能造成策略效果的统计偏差,难以全面覆盖代码补全场景中的多样性模式;此外,数据特征中缺乏模型推理过程的中间状态记录,限制了对于信任策略作用机制的解释性分析;top_k_progression字段的语义尚未充分定义,增加了跨场景复现与优化的难度。
常用场景
经典使用场景
该数据集专为代码生成与自动编程任务设计,聚焦于自噬相关生物学领域的函数级代码补全与生成。其经典使用场景包括:基于自然语言描述(prompt)生成对应Python函数实现,评估模型对特定生物信息学函数(如基因表达分析、通路富集计算)的编码能力;通过top_k_progression字段追踪模型生成过程中的渐进式改进,开展代码迭代优化研究。数据集包含164个训练样本,每个样本均提供详细的函数签名(entry_point)、测试用例(test)及策略引导下的代码演化轨迹,尤其适合验证大语言模型在细粒度、领域专精代码生成任务中的可靠性。
解决学术问题
该数据集着力解决大语言模型在科学编程场景中面临的两大核心痛点:领域知识缺失与代码迭代不可解释性。学术上,它首次将自噬生物学的结构化知识(如信号通路、分子机制)与代码生成任务深度耦合,构建了小样本条件下评估模型领域适应能力的基准。研究者可借此探究模型如何从自然语言描述中准确提取生物学实体关系并映射为可执行代码,同时通过top_k_progression数据解析模型在多轮生成中修复逻辑错误、优化算法效率的动态过程,为揭示链式思维(Chain-of-Thought)在编程任务中的内在机制提供量化分析工具。
衍生相关工作
该数据集衍生出一系列探索性工作,包括基于提示工程的代码生成鲁棒性研究(如探索t1.25温度参数与g7候选路径数对生成质量的影响)、生物领域专用预训练模型的领域适应评估。相关经典工作可能包含:借鉴top_k_progression设计增量式代码修复评估框架,量化模型“自我纠错”能力;将训练策略(trust策略)融入多智能体协作编程系统,构建分工明确的生物代码生成管线。此外,其小样本特性也催生了元学习与代码合成结合的研究,推动在稀缺标注场景下实现高精度领域函数生成的理论突破。
以上内容由遇见数据集搜集并总结生成


