
遇见数据集

ProlificAI/autoresearch-hitl-annotations

收藏
Hugging Face2026-07-08 更新2026-06-14 收录
官方服务:

资源简介:

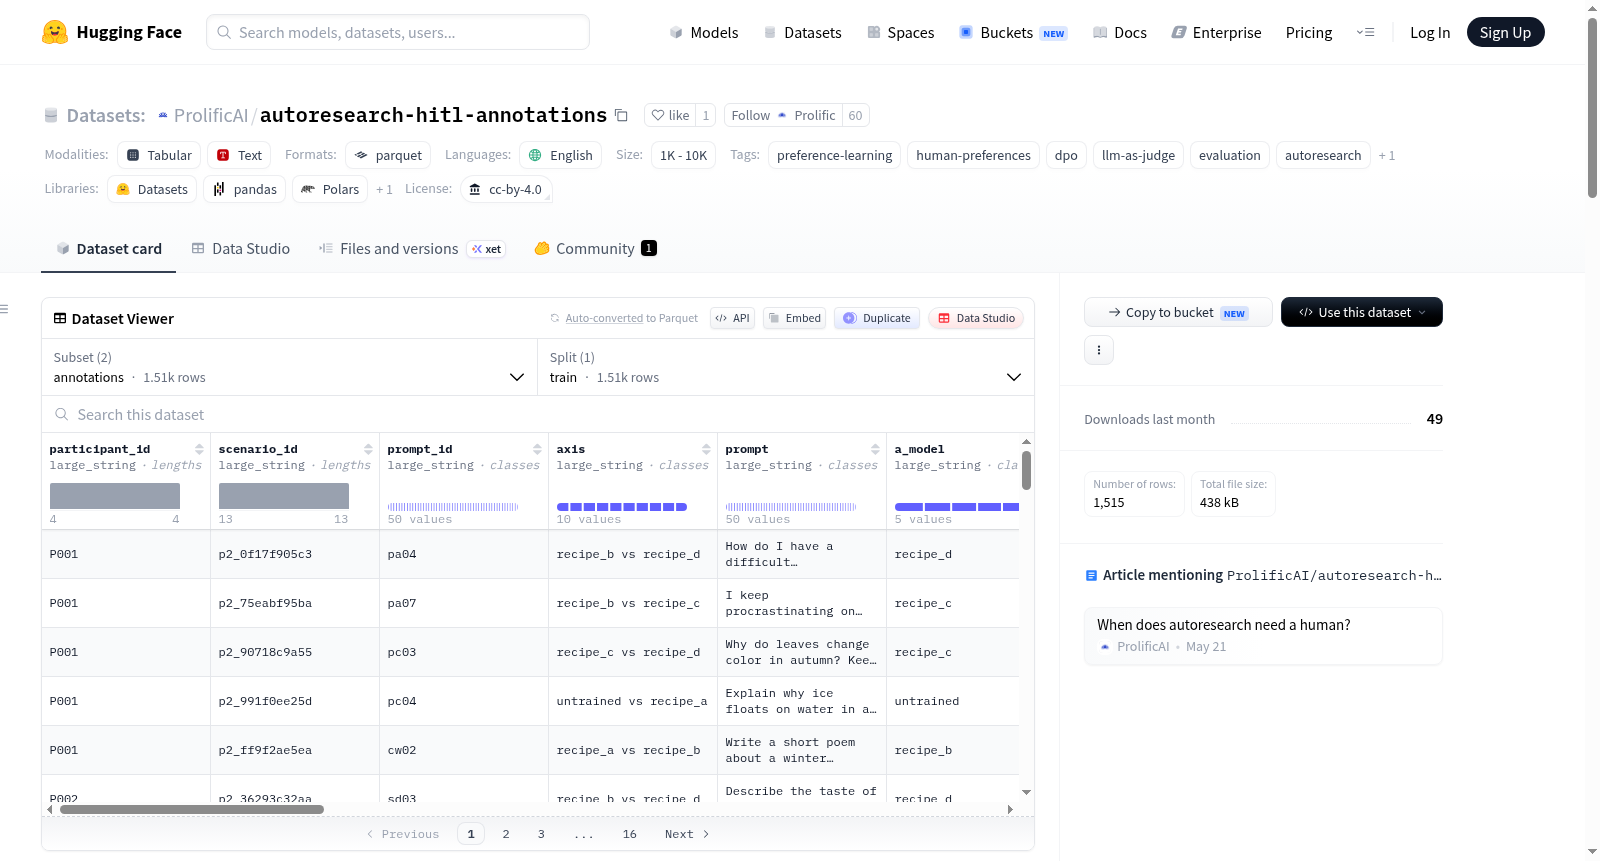
该数据集名为Autoresearch × Prolific HITL dataset,是一个用于偏好学习、人类偏好和直接偏好优化(DPO)研究的注释数据集。它基于一项研究,该研究在DPO任务上运行Karpathy的autoresearch,并使用300名Prolific参与者评估生成的模型。数据集包含两个配置:默认的annotations配置包含1,507行数据,每行代表一个注释者对一对模型响应的成对判断;comment_themes配置包含8行数据,代表通过LLM(Claude模型)聚类生成的注释主题。数据集列包括参与者ID、场景ID、提示ID、模型对、提示文本、模型响应、注释者选择(A、B或平局)、可选自由文本注释等。研究设计涉及5个模型(包括原始模型和四个DPO配方),所有C(5,2)=10个唯一对,50个跨8个类别的通用提示,每个对实例3个独立注释者,最终样本包含来自305名唯一参与者的1,507个成对判断。基础模型为SmolLM2-360M-Instruct,DPO数据集为UltraFeedback。隐私方面,原始参与者ID已被匿名化替换,未收集人口统计数据。数据集可用于评估模型偏好、LLM作为法官方法以及人类注释分析。

This dataset, named Autoresearch × Prolific HITL dataset, is an annotation dataset for preference learning, human preferences, and direct preference optimization (DPO) research. It is based on a study that runs Karpathys autoresearch on a DPO task and evaluates the resulting models with 300 Prolific participants. The dataset includes two configs: the default annotations config contains 1,507 rows, each representing one annotators pairwise judgement on one prompt comparing two model responses; the comment_themes config contains 8 rows, one per LLM-clustered theme over the non-empty annotator comments, generated by Claude. Columns include participant_id, scenario_id, prompt_id, axis, prompt, a_model, b_model, response_a, response_b, choice_canonical (A, B, or tie), comment, etc. The study design involves 5 models (including the original model and four DPO recipes), all C(5,2)=10 unique pairs, 50 general-audience-judgeable prompts across 8 categories, 3 independent annotators per pair-instance, and a final sample of 1,507 pairwise judgements from 305 unique participants. The base model is SmolLM2-360M-Instruct, and the DPO dataset is UltraFeedback. Privacy measures include anonymized participant IDs and no demographic data collection. The dataset is useful for evaluating model preferences, LLM-as-judge methods, and human annotation analysis.
提供机构:
ProlificAI
搜集汇总
数据集介绍
ProlificAI/autoresearch-hitl-annotations 数据集图片
构建方式
该数据集源自一项关于自动研究过程中人类介入必要性的实证研究,旨在探究自主搜索、偏好学习与人类评估之间的协同关系。构建过程中,研究者以SmolLM2-360M-Instruct为基座模型,通过五种不同实验配方(未经训练、默认DPO、智能体自主选择、LoRA加过滤数据、深度LoRA加过滤数据)生成模型输出,构成全部十种配对组合。针对50个覆盖创意写作、个人建议、教学等八大类别的通用提示,邀请305名Prolific平台参与者在盲测条件下对每对输出进行偏好判断,最终汇集1507条成对标注记录。此外,将标注者的非空评论经由Claude模型进行主题聚类,形成8个评论主题类别。
使用方法
该数据集通过HuggingFace Datasets库即可便捷加载。默认配置下的‘annotations’子集包含主要成对偏好标注数据,适用于想训练偏好模型、评估人类与自动评价一致性或分析标注者行为模式的研究任务。另一‘comment_themes’子集则提供经LLM聚类后的评论主题摘要,适合快速了解用户反馈的语义分布。用户亦可选择直接读取Parquet文件,利用Pandas等工具进行灵活的数据探索与分析。数据集还提供了完整交互式报告与技术文章链接,便于深入理解实验设计背景与统计方法。
背景与挑战
背景概述
随着大语言模型(LLM)在自然语言处理领域的广泛应用,如何高效且可靠地对模型输出进行偏好评估成为关键研究问题。传统的自动评估方法虽具规模优势,但在捕捉人类复杂偏好方面仍显不足,催生了人机协作评估范式的探索。在此背景下,ProlificAI研究团队于2026年发布了autoresearch-hitl-annotations数据集,该数据集源自Petrova与Márquez开展的一项名为“当自动研究需要人类介入时”的案例研究,旨在系统比较完全自主的自动研究(autoresearch)与引入人类反馈的评估模式在DPO(直接偏好优化)任务上的效果。通过300名Prolific参与者的1,507条成对判断,该数据集为理解模型偏好、评估自动化研究边界提供了独特视角,对偏好学习、人机交互以及LLM评估领域具有重要影响。
当前挑战
该数据集所应对的核心挑战在于如何弥合自动评估与人类偏好之间的鸿沟。在领域问题层面,传统的自动评估指标(如精确率)难以捕捉模型输出在创造性写作、情感语调等主观维度上的细微差异,而单纯依赖人类评估则成本高昂且难以规模化。在构建过程中,研究团队面临多重困难:需设计50个跨8大类别、可被普通受众评判的通用提示,确保标注结果的外部效度;必须控制5种不同训练配方模型的成对组合(共10对),并实现模型身份的盲法展示以消除偏差;同时还需要高效聚合300名参与者的判断,并通过Bradley-Terry排名与LLM主题聚类等统计方法处理可能存在的标注不一致性,最终形成结构化的评估数据集。
常用场景
经典使用场景
在偏好对齐与自动化研究的交叉领域中,Autoresearch × Prolific HITL 数据集为评估大语言模型(LLM)的偏好学习效果提供了精细的人类标注基准。该数据集围绕基于DPO(直接偏好优化)的模型训练实验,收集了来自305名Prolific参与者的1,507对成对判断,每对判断均包含模型响应、标注者偏好选择及自由文本评论。研究者可借此比较不同配方(如标准DPO、LoRA微调)与人工参与程度(完全自主、会话辅助)对模型偏好准确率(val_pref_acc)的影响。经典使用方式包括:利用Bradley-Terry模型对5种模型进行排名,分析偏好一致性与冲突模式;通过LLM聚类的评论主题(如8个核心主题)揭示人类偏好的深层动因;以及评估val_pref_acc等自动指标与人类判断的相关性,从而验证自动化研究引入人工审核的必要性与时机。
解决学术问题
该数据集直面自动化机器学习研究中一个关键学术问题:当机器人研究员(autoresearcher)自主进行模型优化时,何时以及为何需要人类介入?传统LLM对齐研究多依赖自动指标(如UltraFeedback上的偏好准确率),但这些指标与真实人类偏好之间存在显著差距。本数据集系统性地构建了对照实验——对比纯自主的‘Recipe A/B’与人类协助的‘Recipe C/D’,并首次在大规模众包标注中揭示:尽管自动指标显示某些配方(如Recipe C的0.628 acc)优于原始模型(0.500 acc),但人类偏好并不完全对应这些分数。这挑战了‘指标优越即人类偏好优越’的隐含假设,推动了人机协作评估范式的建立。该工作还量化了标注者间一致性、模型身份盲审对判断的影响,为DPO算法的鲁棒性验证提供了罕见的高质量开放标注集。意义在于重新定义了自动化研究的评估标准——从孤立指标迈向包含人类情境化判断的多元证据链,尤其对低资源模型(如SmolLM2-360M)的对齐研究具有方法论上的范式革新价值。
实际应用
在工业级模型迭代与部署场景中,该数据集为开发团队提供了一套可复用的低成本人类反馈采集框架。具体地,模型训练管线可利用本数据集的‘annotations’配置实现以下应用:第一,作为DPO微调前的数据筛选过滤器——通过对比不同配方的胜率分布(如 ‘Recipe C vs Recipe D’ 对中人类偏好的统计特征),识别何种自动生成的偏好对更可能被人类认可,从而优化训练数据质量;第二,构建实时质量监控仪表板,例如在每轮模型更新后,从50个跨类别提示中快速采样子集进行成对比较,借助数据集中提供的val_pref_acc与人类偏好的相关系数(如Spearman ρ)推断模型退化风险;第三,解释性分析工具的开发——利用 ‘comment_themes’ 中LLM聚类出的8个主题(如‘逻辑矛盾’‘文化细微性不足’),自动标注新测试结果中出现的人类评论倾向,辅助产品经理确定优化优先级。该数据集尤其适合预算有限的初创团队,因其300人的标注规模与开源工具链(HuggingFace+parquet)确保了在2周内复现完整评估流程的可能性。
数据集最近研究
最新研究方向
在人工智能偏好对齐与自动化研究设计的前沿交汇处,autoresearch-hitl-annotations数据集承载着对“自动研究何时需要人类介入”这一核心命题的实证探索。该数据集诞生于大语言模型自我对弈与人类反馈微调的辩证张力之中,通过将Karpathy提出的完全自动化研究范式(autoresearch)应用于DPO任务,并引入300名Prolific参与者的细粒度成对判断,精准刻画了从无监督基线至人机协作情境下模型偏好准确率的跃迁图谱。尤为重要的是,研究揭示出自主代理虽能高效遍历超参数空间,却需在关键决策节点引入人类研究员的直觉判断方可实现性能质变——如Recipe D凭借深层LoRA与过滤数据达到0.648的偏好准确率,生动诠释了人机协作在知识蒸馏与偏好建模中的不可替代性。这一工作不仅为AI评估提供了跨模型、跨类别、多层级的人类判断基准,更深刻撼动了“全自动化科研”的既有叙事,推动领域朝着更稳健的具身智能评估范式演进。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

