
遇见数据集

SinclairSchneider/tweets_correctiv_and_factcheck

收藏
Hugging Face2026-05-15 更新2026-04-26 收录
官方服务:

资源简介:

--- dataset_info: features: - name: search_term dtype: string - name: id dtype: string - name: link dtype: string - name: text dtype: string - name: name dtype: string - name: username dtype: string - name: profile_id dtype: string - name: avatar dtype: string - name: date dtype: string - name: is-retweet dtype: bool - name: is-pinned dtype: bool - name: external-link dtype: string - name: replying-to list: string - name: quoted-post struct: - name: date dtype: string - name: gifs list: string - name: link dtype: string - name: pictures list: string - name: text dtype: string - name: user struct: - name: avatar dtype: string - name: name dtype: string - name: profile_id dtype: string - name: username dtype: string - name: videos list: 'null' - name: comments dtype: int64 - name: retweets dtype: int64 - name: quotes dtype: int64 - name: likes dtype: int64 - name: pictures list: string - name: videos list: 'null' - name: gifs list: string splits: - name: train num_bytes: 4428459599 num_examples: 5101389 download_size: 2333834053 dataset_size: 4428459599 configs: - config_name: default data_files: - split: train path: data/train-* ---

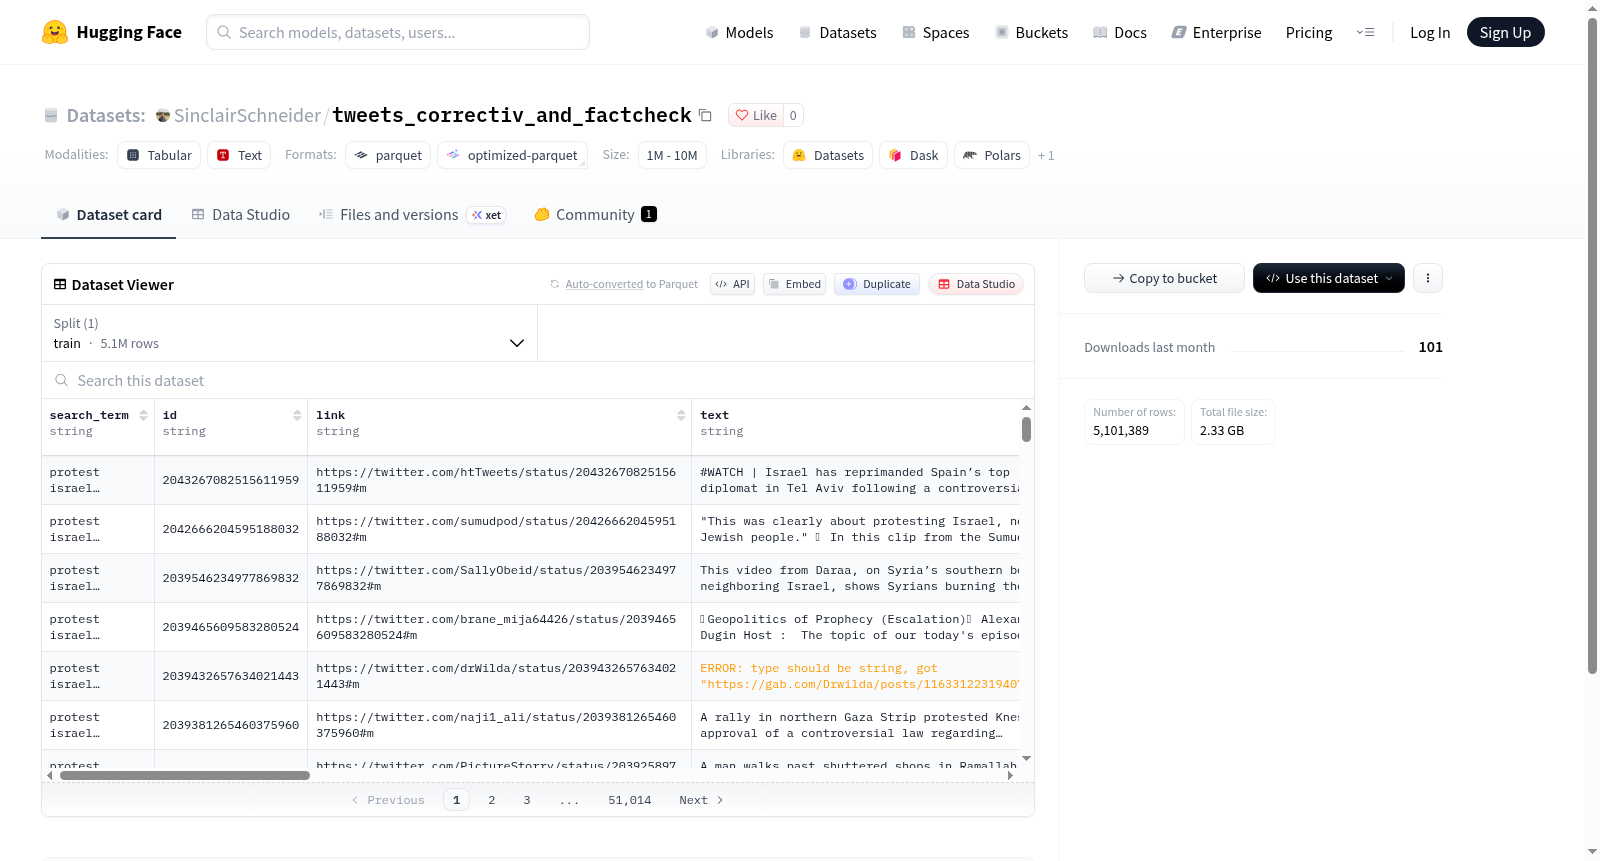
This dataset is a collection of social media data, containing post information from platforms such as Twitter/X. The dataset fields include search term, post ID, link, text content, user name, username, profile ID, avatar, publication date, whether it is a retweet, whether it is pinned, external link, list of replies, quoted post details (including date, GIFs, link, pictures, text, user information), number of comments, retweets, quotes, likes, list of pictures, list of videos, and list of GIFs. The data is provided as a training split with approximately 5.1 million samples and a total size of about 4.43 GB, suitable for natural language processing, social network analysis, and machine learning tasks.
提供机构:
SinclairSchneider
搜集汇总
数据集介绍
SinclairSchneider/tweets_correctiv_and_factcheck 数据集图片
构建方式
在虚假信息治理与计算社会科学交汇的问题域中,面向纠正性回应与事实核查的大规模推文语料构成观察公共讨论纠偏机制的重要经验材料。该数据集以“search_term”为检索入口,围绕纠正与事实核查相关主题汇聚公开推文记录,并对其作者、时间、链接、互动计数、回复对象、引用帖及媒体附件等字段加以结构化保存,最终形成规模约五百一十万条样本的单一训练拆分。其字段组织保留了推文原生语境与关系线索,使后续研究得以在统一数据框架下追溯信息传播链条与纠偏话语实践。
特点
从语料特质观之,该数据集展现出大规模、多维度和强关系嵌入的特征。其文本字段承载推文内容,作者与时间字段勾勒发布主体及历时脉络,评论、转推、引用与点赞等计数提供互动强度度量;“replying-to”列表与“quoted-post”嵌套结构则保留回复和引用关系,外部链接、图片、视频与动图字段补充多模态语境。逾五百万条样本的体量有助于开展细粒度子群比较与传播路径分析,同时嵌套字段要求使用者在解析时兼顾层级结构与缺失情形。
使用方法
就研究应用而言,该数据集可借助Hugging Face datasets接口加载默认配置中的train拆分,并以“search_term”筛选特定主题子集。分析者能够结合“text”“date”“username”“link”等字段开展内容、时间与来源维度分析,亦可利用“replying-to”和“quoted-post”构建回复网络或引用网络,并通过评论、转推、引用与点赞等指标衡量信息扩散与参与程度。使用过程中应遵循平台政策、隐私保护与伦理规范,对用户标识和敏感内容作必要匿名化或聚合处理,以支撑可复现的学术研究。
背景与挑战
背景概述
作为面向社交媒体纠错与事实核查研究的数据资源,tweets_correctiv_and_factcheck在HuggingFace公开页面中呈现为包含5,101,389条训练样本的大规模推文集合,字段覆盖搜索词、推文文本、链接、发布者身份、发布时间、转推与置顶状态、回复对象、引用帖、评论/转推/引用/点赞数以及图片、视频、GIF等。该页面未明确标注创建时间、主要研究人员或机构,故其学术渊源仍需查证。其核心研究问题可理解为从推文及其互动结构中识别纠正性信息与事实核查行为,并为虚假信息传播、计算社会科学与平台治理研究提供潜在语料。
当前挑战
面向推文纠错与事实核查的自动分析,其领域难题在于识别纠正性话语、核验事实主张、解析引用与回复构成的对话脉络,并应对讽刺、反讽、多语言、事件演化与证据链接失效等语境依赖因素。构建此类数据集亦面临多重挑战:Twitter/X平台接口限制与内容删除导致样本动态缺失;五百万级推文需去重、过滤机器人及噪声;引用帖嵌套结构与图片、视频、GIF等多媒体字段可能不完整;互动指标受时间与传播偏差影响;公开推文还涉及隐私、伦理与合规风险。
常用场景
经典使用场景
在计算社会科学与数字传播研究深度交汇的背景下,tweets_correctiv_and_factcheck 的经典用途在于搭建面向事实核查与纠错传播的大规模推文语料库。研究者可借 search_term 定位公共议题,通过 text、replying-to 与 quoted-post 还原纠正性回复、引用推文和转推的对话结构,并结合评论、转推、点赞等互动指标衡量纠错信息的可见度与接受度。该场景通常服务于谣言纠正、立场识别、证据引用和传播路径追踪,为观察事实核查信息如何在平台生态中流动提供细粒度素材。
衍生相关工作
沿循社交媒体事实核查与 misinformation 研究的脉络,该数据集催生或支撑了一系列相关经典工作。它们大致涵盖谣言检测与早期预警、事实核查检索与证据排序、纠正信息传播建模、立场与情绪分类、影响力用户识别以及多模态帖文分析。借助 reply、quote、retweet 和互动计数,研究者可构建传播网络与因果推断框架,检验纠错干预在不同议题和社群中的异质性效果。这些工作共同拓展了计算传播学、信息检索与自然语言处理在真实平台数据上的方法边界。
数据集最近研究
最新研究方向
在计算社会科学持续聚焦信息失序与平台治理的背景下,tweets_correctiv_and_factcheck 以五百一十万余条推文及其回复、引用帖、外部链接与互动计量,构建了观察事实核查和用户纠偏行为的规模化资源。近期研究倚重此类语料,探索纠正性回应的触发条件、话语策略与传播效力,并借助大语言模型识别虚假叙事、生成循证纠正及预测干预增益。引用推文与回复链为追踪错误信息扩散、评估社区纠偏时滞提供细粒度线索,相关议题亦关联选举、公共卫生与地缘冲突中的核查热点。该数据集对平台审核、事实核查生态和可复现计算传播研究具有基础性意义。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

