
遇见数据集

TTS-AGI/advanced-soundscapes-stage-1

收藏
Hugging Face2026-07-03 更新2026-07-22 收录
官方服务:

资源简介:

该数据集是LAION通用音频标注管道(UAAP)数据生成计划的第一阶段输出,名为“高级声景第一阶段——原始组件(5M)”。它包含5000个分片,总计500万个声景配方,每个配方包含原始音频组件:语音(spkN.flac/json)、音乐(musicN.flac/json)、音效(sfxN.flac/json)和人声爆发(vbN.flac/json),以及完整的配方元数据(recipe.json)。数据格式为WebDataset tar分片,每个分片包含1000个片段。源数据集包括laion/majestrino-data(语音,约50种语言,CC0许可证)、laion/captioned-ai-music-snippets(音乐,3-30秒,Apache-2.0许可证)、laion/generated-sound-events(音效,合成,1190个类别,Apache 2.0许可证)和laion/synthetic_vocal_bursts(人声爆发,宽松许可证)。第一阶段流水线在CPU上运行,包括采样配方、从源数据集抽取原始音频、解码并重采样为16 kHz单声道FLAC、计算精确混合计划(包括时间、响度、说话者ID)、收集完整源元数据,并写入WebDataset行。数据集还定义了多种配方原型(如平衡三重奏、语音主导、音乐主导等),以及响度梯度和持续时间频段,用于生成多样化的声景。

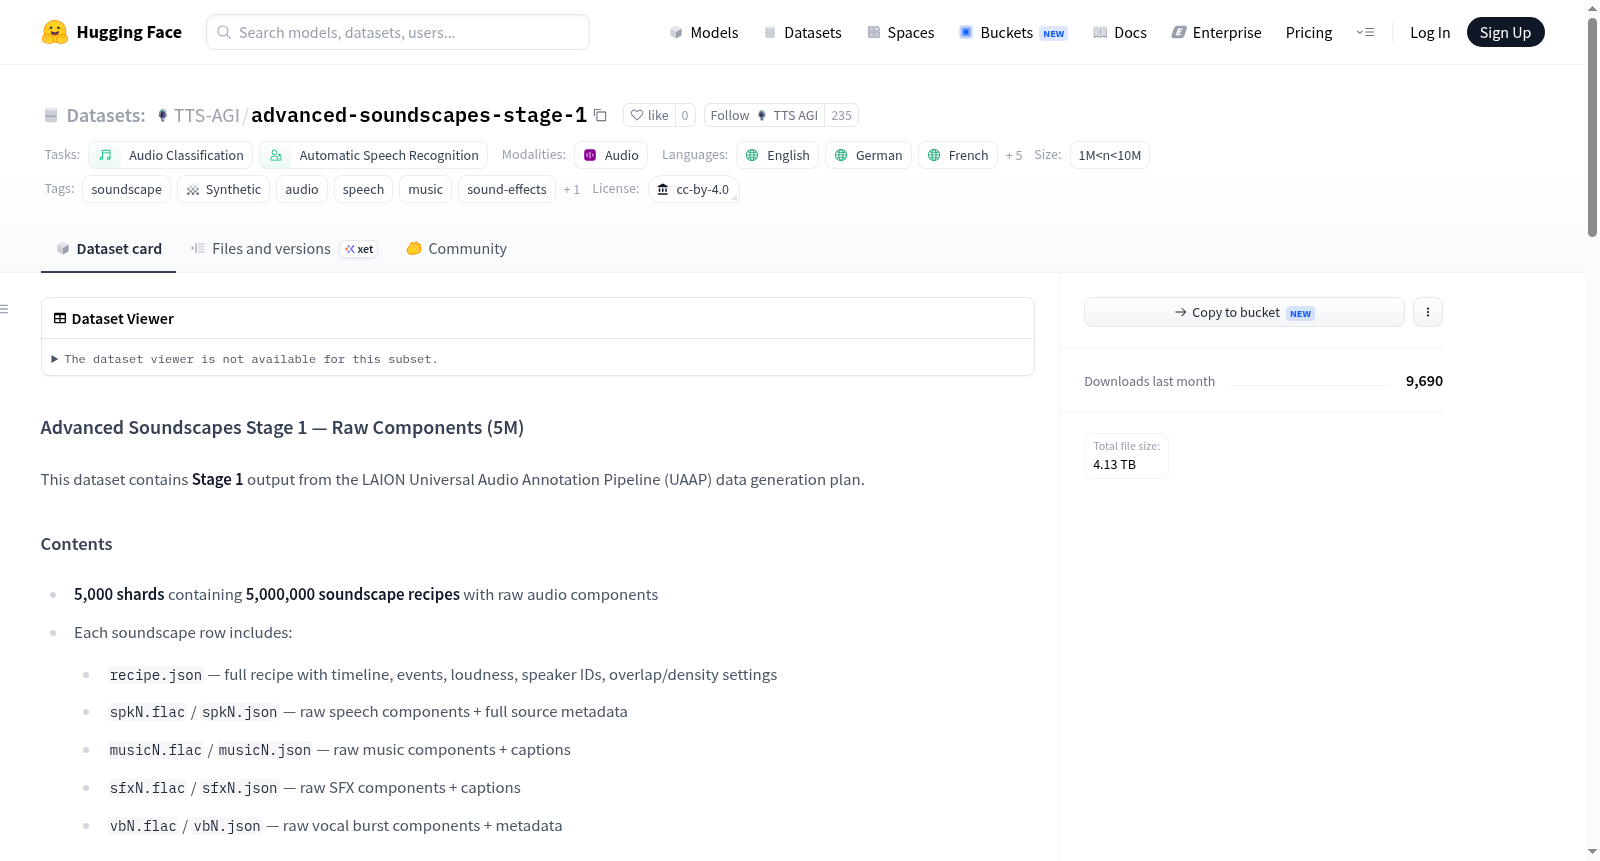
This dataset contains Stage 1 output from the LAION Universal Audio Annotation Pipeline (UAAP) data generation plan, titled Advanced Soundscapes Stage 1 — Raw Components (5M). It includes 5,000 shards with 5,000,000 soundscape recipes, each containing raw audio components: speech (spkN.flac/json), music (musicN.flac/json), sound effects (sfxN.flac/json), and vocal bursts (vbN.flac/json), along with full recipe metadata (recipe.json). The format is WebDataset .tar shards, with 1000 clips per shard. Source datasets are laion/majestrino-data (speech, ~50 languages, CC0 license), laion/captioned-ai-music-snippets (music, 3–30s, Apache-2.0 license), laion/generated-sound-events (SFX, synthetic, 1190 classes, Apache 2.0 license), and laion/synthetic_vocal_bursts (vocal bursts, permissive license). The Stage 1 pipeline is CPU-only and involves sampling a recipe, drawing raw audio pieces from source datasets, decoding and resampling to 16 kHz mono FLAC, computing an exact mix plan (ground-truth timings, loudness, speaker IDs), gathering full source metadata, and writing WebDataset rows. The dataset also defines recipe archetypes (e.g., balanced trio, speech-dominant, music-dominant), a loudness ladder, and duration bands for generating diverse soundscapes.
提供机构:
TTS-AGI
搜集汇总
数据集介绍
TTS-AGI/advanced-soundscapes-stage-1 数据集图片
构建方式
该数据集源自LAION通用音频标注流水线(UAAP)的数据生成计划的第一阶段输出,旨在为复杂声景合成提供原始组件。构建过程中,首先通过CPU流水线对声音场景配方进行采样,涵盖十种不同的声音组合原型(如平衡三元素、语音主导、音乐主导等),并依据预设的密度、重叠度、扬声器配置等参数,从多个开源音频源中抽取原始音频片段。这些片段包括语音(来自约50种语言的CC0许可数据集)、音乐(来自Apache-2.0许可的带标题音乐片段)、音效(源自1190类合成音效)以及人声爆发片段。所有原始音频均被解码并重采样为16 kHz单声道FLAC格式,随后基于精确的混音计划计算真实时间轴、响度及扬声器身份,最终将每1000个剪辑封装为一个WebDataset的.tar分片,共生成5000个分片,总计500万条声景配方记录。
使用方法
该数据集适用于音频分类与自动语音识别任务的训练与评估,也可作为声景合成研究的基准资源。使用时,用户可通过WebDataset协议高效读取.tar分片文件,每个分片包含1000个以剪辑ID为键的目录条目。每个条目内含的原始音频组件(语音、音乐、音效、人声爆发)及其对应的FLAC文件与JSON元数据可直接用于训练多模态模型或进行声音事件检测。研究者亦可依据配方中的响度、原型、时长等参数对数据子集进行采样,以构建定制化的实验配置。值得注意的是,该数据集为流水线第一阶段的产物,尚未经过第二阶段的GPU密集型处理(如生成缺失字幕与最终MP3混音),因此用户需自行实现音频混合逻辑或直接使用原始组件进行特征提取。数据集采用CC-BY-4.0许可协议,兼容开源研究与商业应用。
背景与挑战
背景概述
在声音场景分析与智能音频理解领域,大规模、多模态、标注精细的合成数据集对于推动模型泛化能力至关重要。Advanced Soundscapes Stage 1 数据集由 LAION 研究社区依托其通用音频标注管道(UAAP)于近期构建,核心研究问题在于模拟复杂听觉场景中语音、音乐、音效与发声爆发等多源声学成分的混合与交互。该数据集包含约500万条声音场景配方与原始音频组件,覆盖58种语言,采用高度结构化的配方原型(如语音主导、音乐主导、效果主导及混合类型),并严格遵循预设的响度阶梯与时长区间设计,为后续的自动化标注与混合渲染提供了坚实的数据基础。其系统性构建范式对复杂声音场景识别、多声源分离及语音识别等领域的模型训练与评测具有重要的推动价值。
当前挑战
该数据集所应对的核心挑战在于如何构建高质量、规模庞大且具有生态效度的合成声音场景,以解决真实音频数据中标注成本高昂、声源类别覆盖不均、场景复杂度过低等问题。在领域问题层面,现有模型在弱监督条件下难以精准解析多重声源重叠、背景噪声干扰及语言多样性带来的泛化瓶颈;该数据集通过原型化配方设计(10种声源组合模式)和平衡的音量增益控制,系统性地模拟了现实中从静默到嘈杂的听觉环境。在构建过程中,技术挑战体现在多源数据的高效整合与一致性维护上:需从四个来源子集抽取语音、音乐、音效及发声爆发素材,执行去重、重采样至16 kHz单声道FLAC格式、精确计算混合时序与响度,并跨语言维持均衡分布;此外,全套生产管线仅依赖CPU计算,对大规模并行调度和元数据汇聚的工程稳健性提出了严苛要求。
常用场景
经典使用场景
Advanced Soundscapes Stage 1 数据集为音频场景理解与合成研究提供了极具价值的起点。其核心设计理念在于将复杂声景解构为可控制的独立组件——语音、音乐、音效及人声爆发片段,并附有详尽的元数据,包括时间线、响度、说话人身份及密度设置。研究者通常利用这一数据集进行多模态音频事件的精细标注与分离任务,例如在混合声景中精准定位各类音频成分的起止时间与空间分布。同时,由于其规模达到五百万条记录,且涵盖多种合成配方与响度层级,该数据特别适用于训练和评估基于深度学习的音频源分离模型,以及研究不同声学特征在混合条件下的交互规律。它为后续的音频渲染和场景合成奠定了稳固的数据基础。
解决学术问题
在学术研究领域,该数据集直面了现实声景复杂多变、难以大规模标准化标注的长期困境。传统音频数据集往往局限于单一类型或干净环境下的录音,难以支撑对多源混合音频进行结构化解析的研究需求。Advanced Soundscapes Stage 1 通过程序化合成的方式,系统性地生成了包含已知成分、精确时序和可控重叠程度的声景样本,从而解决了训练数据与真实场景之间存在的分布差异问题。它使得研究者能够在一个受控且可重复的实验框架内,深入探索音频事件检测、声源定位、基于内容的音频检索等核心课题。该数据集的意义在于推动了从粗粒度分类向细粒度场景理解的范式转变,为构建更鲁棒、更具泛化能力的听觉感知模型提供了不可或缺的基准资源。
实际应用
在实际工程应用中,该数据集展现出广泛的适用性。其成分分离的结构直接服务于智能语音助手及会议系统的语音增强模块,通过模拟包含音乐或环境噪声的复杂声场,帮助模型学习在嘈杂背景下准确提取目标语音。对于自动语音识别(ASR)系统而言,该数据集可生成多样化的噪声干扰场景,显著提升模型在咖啡馆、公共交通等真实声学环境下的鲁棒性。此外,在游戏音效、虚拟现实及影视后期制作领域,该数据所提供的分层元数据使得自动化声景编辑与智能混音成为可能。通过联合利用语音、音乐和音效组件,开发者能够构建自适应的音频引擎,根据虚拟环境动态变化实时调整声音的构成与平衡,大幅提升沉浸式体验的质感与真实性。
数据集最近研究
最新研究方向
当前,生成式声音景观数据集的构建正成为多模态智能领域的前沿焦点,该数据集通过LAION通用音频标注管线的第一阶段,系统性地整合了语音、音乐、音效及人声爆发等原始成分,并基于10种精细的声景配方原型实现了语种平衡与多源数据的去重融合。其研究价值显著体现在为大规模自监督音频预训练模型提供了结构化、可控制的训练素材,尤其在跨语种语音识别、复杂环境声学事件检测以及生成式音频模型的条件控制等方向具有突破性意义。该数据集的设计理念呼应了Meta与Google等机构在通用音频表征学习上的前沿探索,通过可复现的流水线架构与分阶段的生成策略,为发展高鲁棒性、低偏见的下一代表征学习范式奠定了数据基础,同时也推动了合成数据在伦理合规与版权安全框架下的健康演进。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

