遇见数据集

Nemotron-RL-litmus-bench-v0.1

收藏
Hugging Face2026-06-04 更新2026-06-05 收录
官方服务:

资源简介:

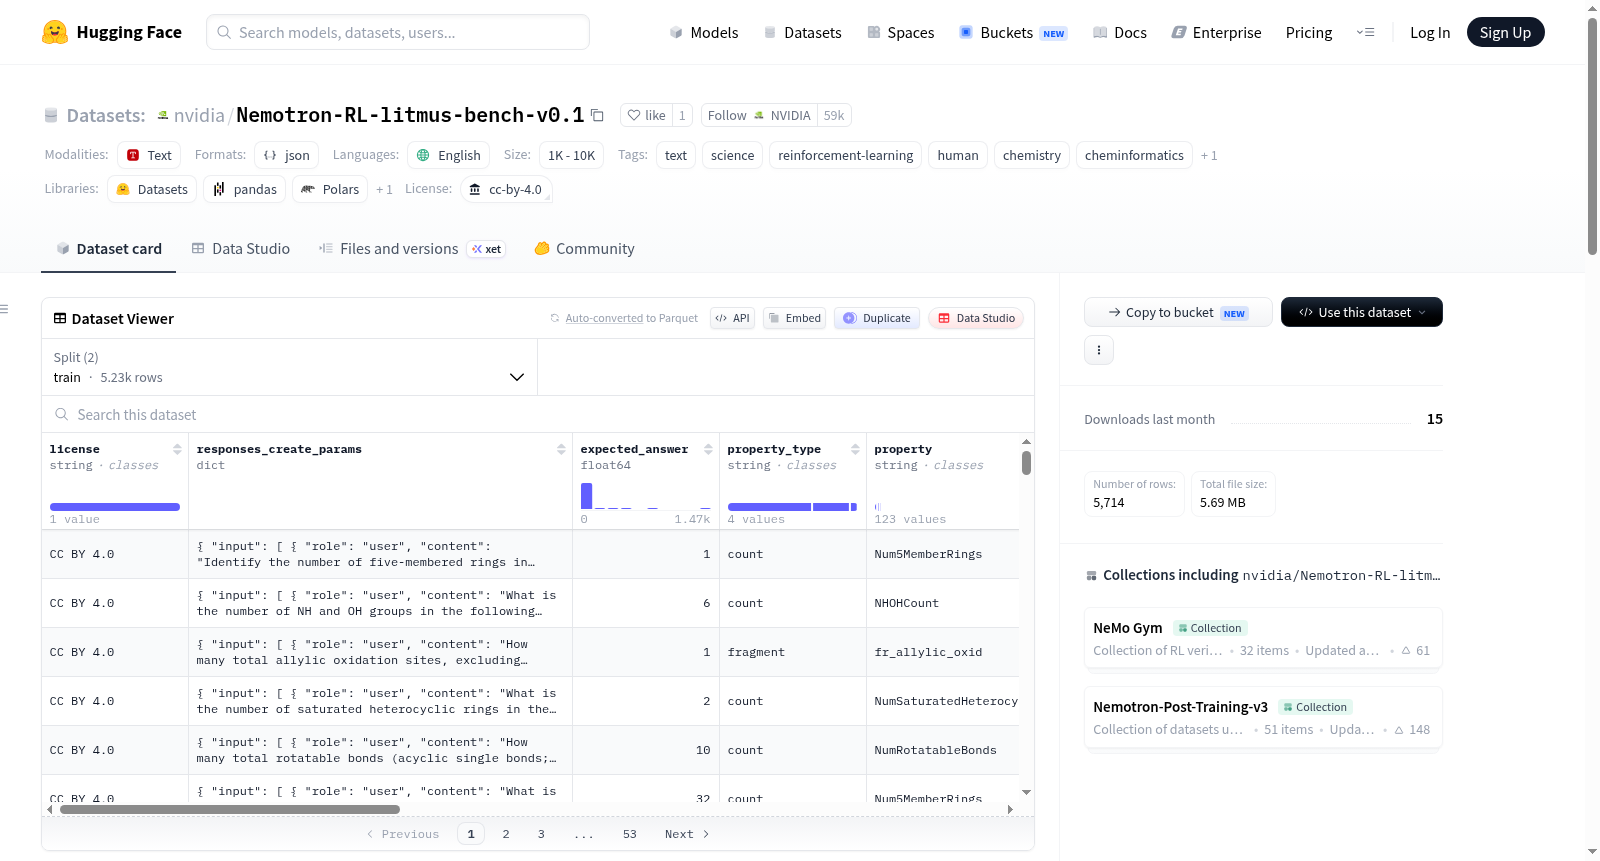
Litmus-Bench v0.1 是一个用于提升推理模型化学理解能力的训练数据集,专为强化学习训练而设计。该数据集基于ChEMBL数据库,利用RDKit描述符生成短答案格式的化学问题。每条数据样本包含一个SMILES字符串(表示化学结构)和一个对应的属性值作为正确答案,共涵盖123种不同的化学性质。数据集包含5,232条训练样本和482条测试样本,总计5,714条记录,存储容量为5.58 MB,格式为纯文本。该数据集作为NVIDIA NeMo-Gym框架的组成部分发布,用于支持基于可验证奖励的强化学习训练范式,旨在为生成式AI模型的后训练生成大规模、高质量的可验证数据。数据集采用CC BY 4.0许可,允许商业和非商业使用,标注方式为人工标注,需与NeMo-Gym工具配合使用。

Litmus-Bench v0.1 is a training dataset designed to enhance the chemical understanding capabilities of reasoning models, specifically tailored for reinforcement learning training. The dataset is based on the ChEMBL database and uses RDKit descriptors to generate chemical questions in short-answer format. Each data sample includes a SMILES string (representing chemical structure) and a corresponding property value as the correct answer, covering a total of 123 different chemical properties. The dataset contains 5,232 training samples and 482 test samples, totaling 5,714 records, with a storage capacity of 5.58 MB in plain text format. It is released as part of the NVIDIA NeMo-Gym framework to support reinforcement learning training paradigms based on verifiable rewards, aiming to generate large-scale, high-quality verifiable data for post-training of generative AI models. The dataset uses the CC BY 4.0 license, allowing both commercial and non-commercial use, is annotated manually, and requires use in conjunction with the NeMo-Gym tool.

提供机构:
NVIDIA
创建时间:
2026-06-02
原始信息汇总

数据集概述

  • 数据集名称: Litmus-Bench v0.1
  • 发布方: NVIDIA Corporation
  • 创建日期: 2026年3月15日
  • 版本: v0.1
  • 许可证: CC BY 4.0(允许商业和非商业使用)
  • 语言: 英文

数据集描述

Litmus-Bench v0.1 是一个用于提升推理模型化学理解能力的训练数据集。每个问题采用短答案格式,基于 ChEMBL 数据集,使用 RDKit 描述符创建,适用于强化学习训练。该数据集作为 NVIDIA NeMo-Gym 的一部分发布,被用于开发 NVIDIA Nemotron 系列模型。

数据集规模和格式

  • 记录总数: 5232条(训练集),482条(测试集)
  • 特征数量: 跨数据集的123种不同属性,每条记录包含一个SMILES和一个作为正确答案的单一属性值
  • 总存储空间: 5.58 MB
  • 格式: 纯文本,兼容 NeMo-Gym

数据收集与标注

  • 数据收集方法: 人工
  • 标注方法: 人工

任务类型

  • 强化学习(Reinforcement Learning)
  • 问答(Question Answering)

用途

该数据集用于配合 NeMo-Gym 进行大语言模型(LLM)的后训练。

伦理考量

NVIDIA 倡导可信赖的人工智能,开发者应根据行业和用例需求评估数据集,并防范潜在的误用风险。相关问题可报告至 NVIDIA 安全漏洞提交页面

搜集汇总
数据集介绍
Nemotron-RL-litmus-bench-v0.1 数据集图片
构建方式
Litmus-Bench v0.1 是一个专为提升推理模型化学理解能力而设计的训练数据集。该数据集基于 ChEMBL 数据库,利用 RDKit 描述符生成短答案格式的化学问题。每个样本包含一个 SMILES 分子结构及其对应的单一属性值作为正确答案,数据集的构建过程融合了人类专家的标注与自动化特征提取技术。整个数据集包含 5232 条训练样本和 482 条测试样本,覆盖了 123 种不同的化学属性,旨在为强化学习从可验证奖励(RLVR)的训练范式提供大规模、高质量的数据支持。
特点
该数据集的核心特点在于其专为 RLVR 训练范式设计,结合了 ChEMBL 数据库的丰富化学信息与 RDKit 描述符的精准计算能力。数据集采用短答案格式,便于自动化验证与反馈;同时,人类专家参与的标注流程确保了标签的准确性与可靠性。此外,数据集规模适中,存储空间仅占 5.58 MB,便于高效训练与迭代,其与 NeMo-Gym 框架的深度集成使其成为 NVIDIA Nemotron 系列模型开发的关键组成部分。
使用方法
该数据集的使用需结合 NeMo-Gym 开源库,该库是 NVIDIA NeMo 框架的一部分,专为大规模、可验证的强化学习数据设计。开发者可将数据集直接用于后训练大型语言模型(LLMs),通过 RLVR 范式优化模型的化学推理能力。数据集以 JSONL 格式提供,包含训练集和测试集两个拆分,方便用户根据需求进行模型训练与评估。该数据集在 CC BY 4.0 许可下发布,支持商业和非商业用途。
背景与挑战
背景概述
在人工智能与化学信息学交叉领域,利用强化学习提升大语言模型对化学分子结构的理解能力成为研究热点。Nemotron-RL-litmus-bench-v0.1数据集由NVIDIA公司于2026年3月15日创建,旨在为可验证奖励的强化学习训练提供标准化化学问题。该数据集基于ChEMBL数据库,利用RDKit描述符生成5232个训练样本和482个测试样本,覆盖123种分子属性。作为NVIDIA NeMo-Gym框架的核心组件,该数据集在Nemotron系列模型的开发中发挥了关键作用,为化学推理模型的训练开辟了新范式,推动了RLVR技术在科学领域的应用。
当前挑战
该数据集致力于解决大语言模型在化学分子结构理解上的领域难题,例如模型常因缺乏细粒度分子性质知识而无法准确回答化学问题。构建过程中面临多重挑战:需从ChEMBL数据库中提取高质量分子数据,并通过RDKit计算多种描述符,确保每个问答对具有唯一正确答案。此外,数据集仅为短答案格式,难点在于平衡问题的简洁性与化学知识的广度,同时确保特征覆盖全面性。标注环节依赖人类专家验证,以维持化学准确性。数据规模虽小(约5.58MB),但需保证训练与测试分布的合理性,以支持有效的可验证奖励学习。
常用场景
经典使用场景
在化学与人工智能的交叉领域中,Nemotron-RL-litmus-bench-v0.1(简称Litmus-Bench v0.1)被设计为强化学习训练数据集,旨在提升推理模型的化学理解能力。该数据集包含5232条训练样本和482条测试样本,每条记录由SMILES表达式及其对应的单一化学属性值构成,涵盖123种不同的分子描述符。这些数据源自ChEMBL数据库,并借助RDKit工具生成,以简短问答形式呈现,为模型提供了精确的化学知识基准。其经典使用场景是作为NVIDIA NeMo-Gym框架的一部分,用于对大型语言模型进行基于可验证奖励的强化学习(RLVR)后训练,从而增强模型在化学推理任务中的准确性与可靠性。
实际应用
在实际应用中,该数据集主要服务于大型语言模型在化学领域的后训练阶段,特别是在药物研发和分子设计场景中发挥关键作用。通过Litmus-Bench v0.1训练后的模型能够更精准地理解分子结构、预测化学性质,从而辅助科研人员加速先导化合物筛选、优化分子骨架。例如,在新药开发流程中,模型可基于SMILES表示快速回答有关分子量、LogP、氢键供体/受体数量等关键属性,提升虚拟筛选效率。此外,该数据集因其CC BY 4.0许可协议,适合商业与非商业用途,可被整合到工业级AI药物发现平台中,降低研发成本并缩短周期。
衍生相关工作
作为NVIDIA NeMo-Gym生态系统的重要组成部分,Litmus-Bench v0.1衍生了多项相关研究工作。其直接关联的工作包括NVIDIA Nemotron系列模型的开发,这些模型利用该数据集进行后训练,在化学推理基准测试中展现出显著性能提升。围绕该数据集,研究者进一步探索了RLVR范式在科学领域泛化能力的边界,例如结合分子动力学模拟和量子化学计算数据来扩展训练集。此外,社区基于该数据集的格式和设计理念,陆续构建了面向生物化学、材料科学等相邻领域的类似基准,推动了可验证奖励强化学习在跨学科科学问题中的标准化应用,形成了以NeMo-Gym为核心的RL数据生态。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务