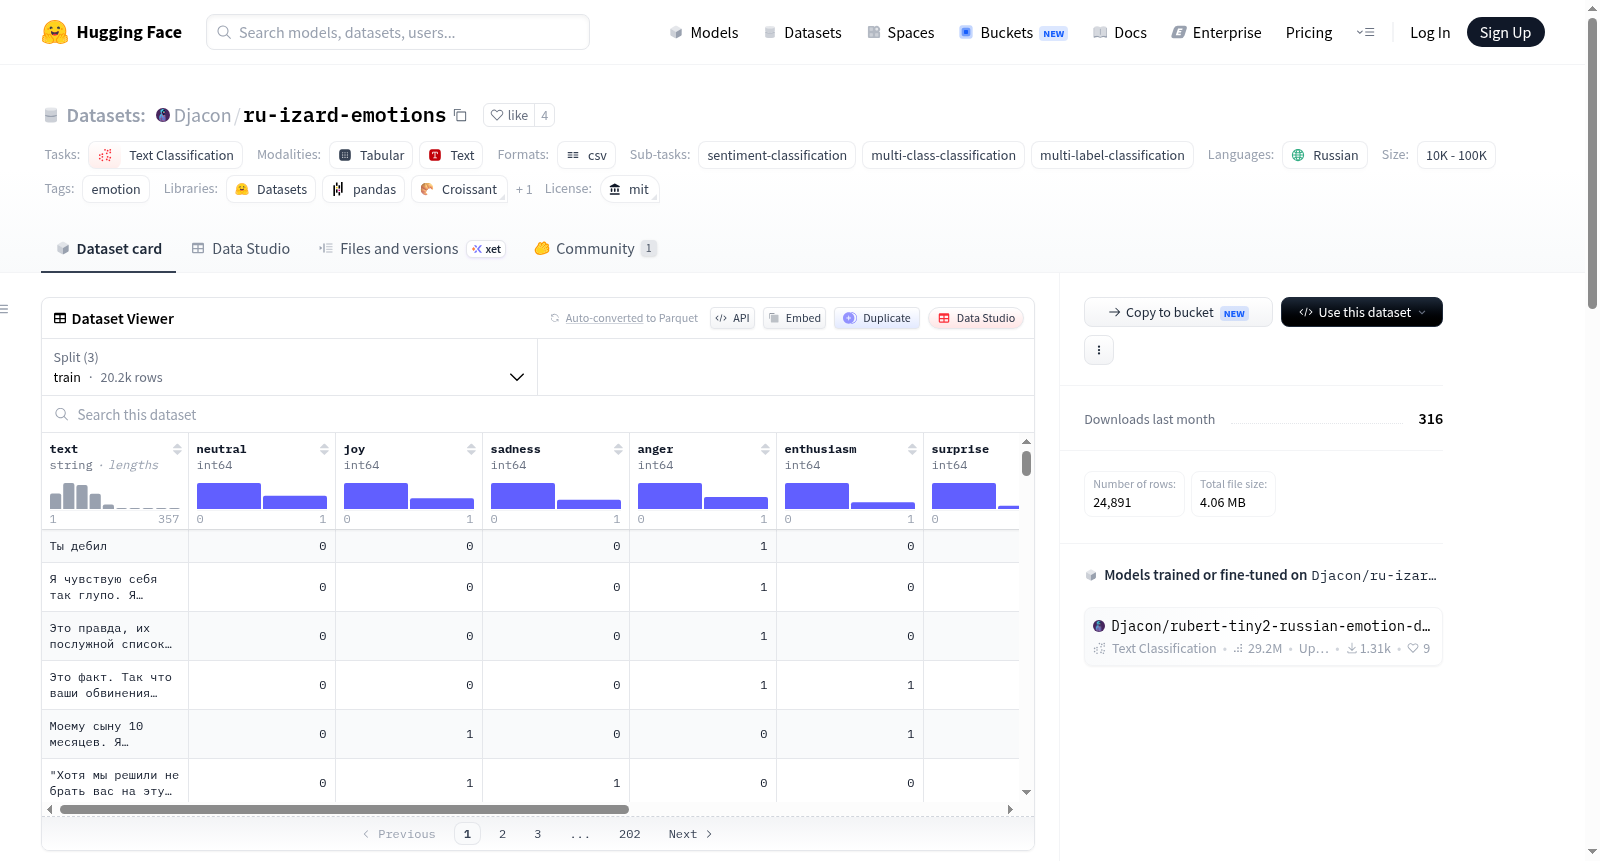
Djacon/ru-izard-emotions
收藏资源简介:
--- language: - ru license: - mit multilinguality: - russian task_categories: - text-classification task_ids: - sentiment-classification - multi-class-classification - multi-label-classification pretty_name: RuIzardEmotions tags: - emotion size_categories: - 10K<n<100K --- # Dataset Card for RuIzardEmotions ## Table of Contents - [Dataset Description](#dataset-description) - [Dataset Summary](#dataset-summary) - [Supported Tasks and Leaderboards](#supported-tasks-and-leaderboards) - [Languages](#languages) - [Dataset Structure](#dataset-structure) - [Data Instances](#data-instances) - [Data Fields](#data-fields) - [Data Splits](#data-splits) - [Dataset Creation](#dataset-creation) - [Curation Rationale](#curation-rationale) - [Source Data](#source-data) - [Annotations](#annotations) - [Personal and Sensitive Information](#personal-and-sensitive-information) - [Considerations for Using the Data](#considerations-for-using-the-data) - [Social Impact of Dataset](#social-impact-of-dataset) - [Discussion of Biases](#discussion-of-biases) - [Other Known Limitations](#other-known-limitations) - [Additional Information](#additional-information) - [Dataset Curators](#dataset-curators) - [Licensing Information](#licensing-information) - [Citation Information](#citation-information) - [Contributions](#contributions) ### Dataset Summary The RuIzardEmotions dataset is a high-quality translation of the [go-emotions](https://huggingface.co/datasets/go_emotions) dataset and the other [emotion-detection](https://www.kaggle.com/datasets/ishantjuyal/emotions-in-text/data) dataset. It contains 30k Reddit comments labeled for 10 emotion categories (__joy__, __sadness__, __anger__, __enthusiasm__, __surprise__, __disgust__, __fear__, __guilt__, __shame__ and __neutral__). The datasets were translated using the accurate translator [DeepL](https://www.deepl.com/translator) and additional processing. The idea for the dataset was inspired by the [Izard's model](https://en.wikipedia.org/wiki/Differential_Emotions_Scale) of human emotions. The dataset already with predefined train/val/test splits. ### Supported Tasks and Leaderboards This dataset is intended for multi-class, multi-label emotion classification. ### Languages The data is in Russian. ## Dataset Structure ### Data Instances Each instance is a reddit comment with one or more emotion annotations (or neutral). ### Data Splits The simplified data includes a set of train/val/test splits with 24k, 3k, and 3k examples respectively. ## Considerations for Using the Data ### Social Impact of Dataset Emotion detection is a worthwhile problem which can potentially lead to improvements such as better human/computer interaction. However, emotion detection algorithms (particularly in computer vision) have been abused in some cases to make erroneous inferences in human monitoring and assessment applications such as hiring decisions, insurance pricing, and student attentiveness ## Additional Information ### Licensing Information The GitHub repository which houses this dataset has an [Apache License 2.0](https://github.com/Djacon/russian-emotion-detection/blob/main/LICENSE). ### Citation Information ``` @inproceedings{Djacon, author={Djacon}, title={RuIzardEmotions: A Dataset of Fine-Grained Emotions}, year={2023} } ```
--- 语言: - 俄语 许可协议: - MIT 多语言属性: - 俄语 任务类别: - 文本分类 任务子任务: - 情感分类 - 多类别分类 - 多标签分类 友好名称:RuIzardEmotions 标签: - 情感 样本规模区间: - 10K<n<100K --- # RuIzardEmotions 数据集卡片 ## 目录 - [数据集描述](#dataset-description) - [数据集摘要](#dataset-summary) - [支持的任务与基准榜单](#supported-tasks-and-leaderboards) - [语言](#languages) - [数据集结构](#dataset-structure) - [数据实例](#data-instances) - [数据字段](#data-fields) - [数据划分](#data-splits) - [数据集构建](#dataset-creation) - [构建初衷](#curation-rationale) - [源数据](#source-data) - [标注信息](#annotations) - [个人与敏感信息](#personal-and-sensitive-information) - [数据集使用注意事项](#considerations-for-using-the-data) - [数据集的社会影响](#social-impact-of-dataset) - [偏差讨论](#discussion-of-biases) - [其他已知局限性](#other-known-limitations) - [附加信息](#additional-information) - [数据集策展人](#dataset-curators) - [许可协议信息](#licensing-information) - [引用信息](#citation-information) - [贡献说明](#contributions) ### 数据集摘要 RuIzardEmotions 数据集是 [go-emotions](https://huggingface.co/datasets/go_emotions) 数据集与另一款 [emotion-detection](https://www.kaggle.com/datasets/ishantjuyal/emotions-in-text/data) 数据集的高质量译制版。本数据集包含3万条Reddit评论,涵盖10个情感类别的标注:**喜悦(joy)**、**悲伤(sadness)**、**愤怒(anger)**、**热情(enthusiasm)**、**惊讶(surprise)**、**厌恶(disgust)**、**恐惧(fear)**、**内疚(guilt)**、**羞愧(shame)** 与 **中性(neutral)**。 数据集通过高精度翻译工具 [DeepL](https://www.deepl.com/translator) 完成翻译,并经过额外预处理。本数据集的设计灵感源自伊扎德(Izard)的人类情感模型[情绪分化量表(Differential Emotions Scale)](https://en.wikipedia.org/wiki/Differential_Emotions_Scale)。 该数据集已预先划分训练集、验证集与测试集。 ### 支持的任务与基准榜单 本数据集适用于多类别、多标签情感分类任务。 ### 语言 本数据集的数据均为俄语。 ## 数据集结构 ### 数据实例 每条数据实例为一条Reddit评论,附带一个或多个情感标注(或中性标注)。 ### 数据字段 (无额外说明) ### 数据划分 精简版数据集已预设训练集、验证集与测试集划分,样本量分别为2.4万、3千与3千。 ## 数据集构建 ### 构建初衷 (无相关说明) ### 源数据 (无相关说明) ### 标注信息 (无相关说明) ### 个人与敏感信息 (无相关说明) ## 数据集使用注意事项 ### 数据集的社会影响 情感检测是一项极具价值的研究课题,有望推动人机交互等领域的优化升级。但需注意,情感检测算法(尤其是计算机视觉方向的此类算法)曾被滥用,在招聘决策、保险定价、学生关注度评估等人类监测与评估场景中得出错误推断。 ### 偏差讨论 (无相关说明) ### 其他已知局限性 (无相关说明) ## 附加信息 ### 数据集策展人 (无相关说明) ### 许可协议信息 本数据集所在的GitHub仓库采用 [Apache许可证2.0(Apache License 2.0)](https://github.com/Djacon/russian-emotion-detection/blob/main/LICENSE) 协议。 ### 引用信息 @inproceedings{Djacon, author={Djacon}, title={RuIzardEmotions: A Dataset of Fine-Grained Emotions}, year={2023} } ### 贡献说明 (无相关说明)
数据集卡片 for RuIzardEmotions
数据集描述
数据集摘要
RuIzardEmotions数据集是go-emotions数据集和其他emotion-detection数据集的高质量翻译版本。它包含30k条Reddit评论,标注了10种情感类别(joy、sadness、anger、enthusiasm、surprise、disgust、fear、guilt、shame__和__neutral)。数据集使用精确的翻译器DeepL进行翻译并进行了额外处理。该数据集的灵感来源于Izards model的人类情感模型。
数据集已经包含了预定义的train/val/test分割。
支持的任务和排行榜
该数据集旨在用于多类别、多标签情感分类。
语言
数据为俄语。
数据集结构
数据实例
每个实例是一条Reddit评论,带有一个或多个情感标注(或中性)。
数据分割
简化数据包括一组train/val/test分割,分别为24k、3k和3k个示例。
使用数据的注意事项
数据集的社会影响
情感检测是一个有价值的问题,可能会带来改进,例如更好的人机交互。然而,情感检测算法(特别是在计算机视觉中)有时会被滥用,在招聘决策、保险定价和学生注意力评估等人类监控和评估应用中做出错误推断。
附加信息
许可信息
该数据集所在的GitHub仓库拥有Apache License 2.0。
引用信息
@inproceedings{Djacon, author={Djacon}, title={RuIzardEmotions: A Dataset of Fine-Grained Emotions}, year={2023} }