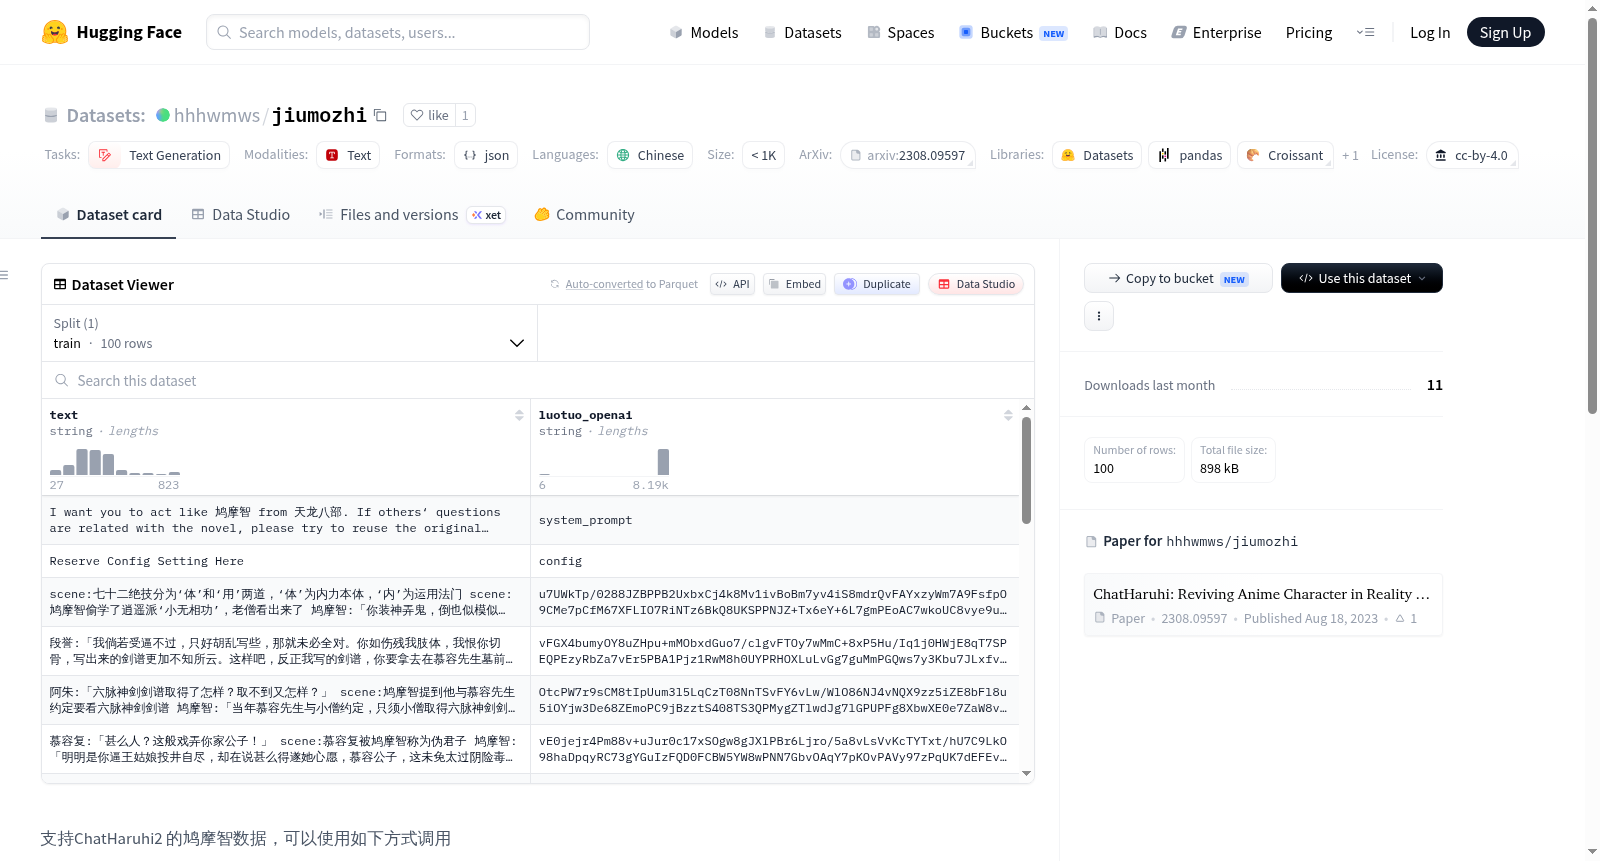
hhhwmws/jiumozhi
收藏资源简介:
--- license: cc-by-4.0 task_categories: - text-generation language: - zh size_categories: - 1K<n<10K --- 支持ChatHaruhi2 的鸠摩智数据,可以使用如下方式调用 ```python from chatharuhi import ChatHaruhi chatbot = ChatHaruhi( role_from_hf = 'hhhwmws/jiumozhi', \ llm = 'openai') response = chatbot.chat(role='萧峰', text = '是我!') print(response) ``` 上传者: 米唯实 更具体的信息,见 [ChatHaruhi](https://github.com/LC1332/Chat-Haruhi-Suzumiya) 欢迎加入我们的 [众筹角色创建项目](https://github.com/LC1332/Chat-Haruhi-Suzumiya/tree/main/characters/novel_collecting) ### Citation引用 Please cite the repo if you use the data or code in this repo. ``` @misc{li2023chatharuhi, title={ChatHaruhi: Reviving Anime Character in Reality via Large Language Model}, author={Cheng Li and Ziang Leng and Chenxi Yan and Junyi Shen and Hao Wang and Weishi MI and Yaying Fei and Xiaoyang Feng and Song Yan and HaoSheng Wang and Linkang Zhan and Yaokai Jia and Pingyu Wu and Haozhen Sun}, year={2023}, eprint={2308.09597}, archivePrefix={arXiv}, primaryClass={cs.CL} } ```
许可证:CC-BY-4.0 任务类别:文本生成 语言:中文 数据规模:1000 < n < 10000 本数据集为适配ChatHaruhi2的鸠摩智角色数据,可通过以下方式调用: python from chatharuhi import ChatHaruhi chatbot = ChatHaruhi( role_from_hf = 'hhhwmws/jiumozhi', llm = 'openai') response = chatbot.chat(role='萧峰', text = '是我!') print(response) 上传者:米唯实 更多详细信息,请参阅 [ChatHaruhi](https://github.com/LC1332/Chat-Haruhi-Suzumiya) 欢迎加入我们的 [众筹角色创建项目](https://github.com/LC1332/Chat-Haruhi-Suzumiya/tree/main/characters/novel_collecting) ### 引用声明 若您使用本数据集或代码,请引用该仓库。 @misc{li2023chatharuhi, title={ChatHaruhi: Reviving Anime Character in Reality via Large Language Model}, author={Cheng Li and Ziang Leng and Chenxi Yan and Junyi Shen and Hao Wang and Weishi MI and Yaying Fei and Xiaoyang Feng and Song Yan and HaoSheng Wang and Linkang Zhan and Yaokai Jia and Pingyu Wu and Haozhen Sun}, year={2023}, eprint={2308.09597}, archivePrefix={arXiv}, primaryClass={cs.CL} }
数据集概述
许可证
- 该数据集遵循 CC BY 4.0 许可证。
任务类别
- 该数据集适用于 文本生成 任务。
语言
- 数据集包含的语言为 中文。
数据规模
- 数据集的规模为 1K<n<10K。
使用示例
-
数据集可用于支持 ChatHaruhi2 的鸠摩智角色。调用示例如下: python from chatharuhi import ChatHaruhi
chatbot = ChatHaruhi( role_from_hf = hhhwmws/jiumozhi, llm = openai)
response = chatbot.chat(role=萧峰, text = 是我!) print(response)
引用
-
使用该数据集或代码时,请引用以下内容:
@misc{li2023chatharuhi, title={ChatHaruhi: Reviving Anime Character in Reality via Large Language Model}, author={Cheng Li and Ziang Leng and Chenxi Yan and Junyi Shen and Hao Wang and Weishi MI and Yaying Fei and Xiaoyang Feng and Song Yan and HaoSheng Wang and Linkang Zhan and Yaokai Jia and Pingyu Wu and Haozhen Sun}, year={2023}, eprint={2308.09597}, archivePrefix={arXiv}, primaryClass={cs.CL} }