
spatial_traveres_results_docent-val-Qwen3-VL-8B-Instruct-for-to-background_no_ref
收藏数据链接:
官方服务:
资源简介:
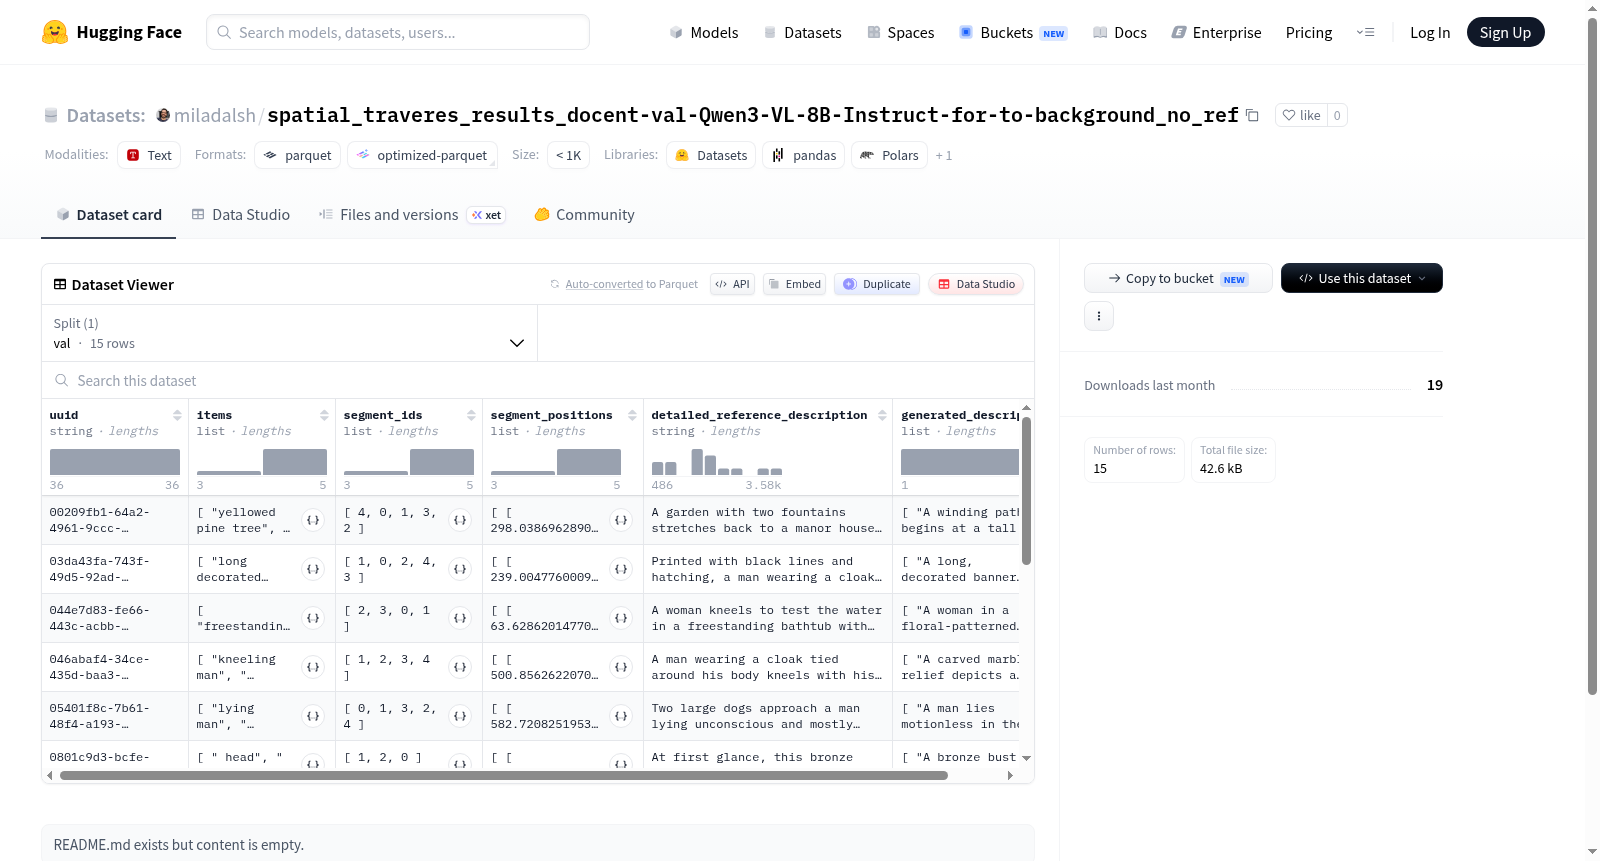
该数据集是一个结构化文本数据集,主要用于描述生成或文本生成相关任务。数据集包含15个样本,存储为结构化格式,每个样本包含以下核心字段:唯一标识符(uuid)、项目列表(items)、分段标识符列表(segment_ids)、分段位置坐标的二维列表(segment_positions)、详细的参考描述文本(detailed_reference_description)以及多个生成描述文本的列表(generated_description)。数据组织方式表明其可能用于评估或训练系统对项目集合进行结构化描述的能力,其中分段信息(segment_ids和segment_positions)可能表示项目在空间或逻辑上的分组关系。数据集仅包含验证集划分,总大小约为38.9KB。适用于自然语言生成、描述质量评估、多描述对比等研究场景。
创建时间:
2026-06-09
原始信息汇总
数据集概述
数据集名称: spatial_traveres_results_docent-val-Qwen3-VL-8B-Instruct-for-to-background_no_ref
数据集特征
该数据集包含以下字段:
- uuid(字符串类型):唯一标识符。
- items(字符串列表):项目列表。
- segment_ids(int64列表):分割片段ID。
- segment_positions(float64嵌套列表):分割片段的位置信息。
- detailed_reference_description(字符串类型):详细的参考描述。
- generated_description(字符串列表):生成的描述。
数据集划分
数据集仅包含一个划分:
- val(验证集):包含15个样本,总字节数为38,884。
数据集大小
- 下载大小:39,551 字节
- 数据集总大小:38,884 字节
配置
数据集只有一个配置,名为 default,其数据文件路径为 data/val-*。
搜集汇总
数据集介绍
构建方式
本数据集名为spatial_traveres_results_docent-val-Qwen3-VL-8B-Instruct-for-to-background_no_ref,其构建基于视觉语言模型Qwen3-VL-8B-Instruct的推理能力,旨在对空间遍历任务结果进行结构化处理。数据集的构建过程以无参考背景信息为条件,通过模型自动生成对场景片段的描述。每条数据包含唯一标识符uuid、项目列表items、片段索引segment_ids、片段在空间中的位置坐标segment_positions、详细的参考描述detailed_reference_description以及模型生成的多条描述文本generated_description。数据集划分为单一验证集val,共计15条样本,总大小为38,884字节,确保数据精炼且便于快速验证模型性能。
特点
该数据集的核心特点在于其精细的结构化设计和对空间信息的显式建模。每条样本不仅提供了文本层面的参考描述与生成描述,还通过segment_ids和segment_positions字段记录了片段级的位置信息,形成图像片段与空间坐标的关联。这种多维度的特征组合使得数据集能够支持对视觉语言模型在空间理解与描述生成一致性上的评估。数据量虽小,但每个样本包含丰富的元数据,适合用于细粒度的质量分析、空间关系推理测试以及生成描述与参考描述的对比研究。
使用方法
使用本数据集时,用户可通过HuggingFace的datasets库加载默认配置下的val分割数据。加载后,每条样本以字典形式提供,可直接访问uuid、items、segment_ids、segment_positions、detailed_reference_description和generated_description字段。研究者可利用detailed_reference_description作为标准答案,与generated_description列表中的多条生成描述进行对比,评估模型在空间场景描述中的准确性、完整性与多样性。segment_positions字段支持结合图像特征进行位置校准,适用于空间推理任务的定量分析。由于数据集规模较小,建议在实验验证阶段用于模型快速迭代或作为人工评估的样本集合。
背景与挑战
背景概述
该数据集由Qwen3-VL-8B-Instruct模型生成,聚焦于空间遍历结果的多模态描述验证。创建时间与Qwen3系列模型发布周期一致,主要依托阿里巴巴通义千问团队在视觉语言模型领域的前沿探索。核心研究问题在于评估大语言模型对复杂空间关系(如路径规划、场景过渡)的理解与自然语言生成能力。作为多模态生成质量验证的基准,该数据集填补了以背景无关性为约束的空间描述文档评估的空白,为推动视觉语言模型在导航辅助、自动驾驶等空间智能体的应用提供了关键参考。
当前挑战
数据集面临的核心挑战包括:1)空间遍历生成的描述需精确捕捉二维图像与三维环境间的映射关系,避免物体方位、路径拓扑等细节歧义,这是视觉语言模型长期未能完美解决的领域难题;2)构建过程中需确保细粒度参考描述与模型生成内容的一致性,防止背景无关性假设被违反,手动标注的15个验证样本虽具代表性,但难以覆盖复杂场景的多样性,易引入标注偏差,影响评估的统计稳健性与泛化性。
常用场景
经典使用场景
spatial_traveres_results_docent-val-Qwen3-VL-8B-Instruct-for-to-background_no_ref数据集专为多模态大语言模型在空间轨迹理解与背景消融条件下的视觉定位任务而构建。其经典使用场景聚焦于评估模型能否在无参考图像指引下,仅凭空间位置信息与分段描述,准确推断并生成指向性语句。数据集提供了精细分段的空间位置向量与对应描述,使研究者能够系统测试模型对空间语义的建模能力,尤其适用于视觉语言导航、指代表达理解与零样本图片定位等核心研究领域。
解决学术问题
该数据集有效解决了多模态模型在空间关系推理与背景无关表述生成中的评估缺失问题。传统数据集常依赖完整参考图像,难以解耦空间位置与视觉内容的贡献。本数据集通过剥离背景信息,迫使模型依据纯坐标语义进行推理,为衡量模型的空间泛化能力提供了标准化基准。其意义在于推动学术界对视觉语言模型中空间编码机制的研究,揭示了模型在缺少显式外观线索时仍能完成精准定位的潜力,对改进注意力机制、位置编码与跨模态对齐具有重要启示。
衍生相关工作
本数据集的衍生工作主要围绕空间推理增强与背景干扰鲁棒性两大方向展开。相关研究者基于其分段位置向量结构,提出了显式位置编码融合模块与空间关系图网络,显著提升了模型对坐标序列的语义理解能力。另有工作以该数据集为基准,对比了不同大语言模型在多视角轨迹对齐中的表现,催生了面向空间语言预训练的对比学习框架。同时,该数据还启发了无参考图像条件下指代分割任务的标准化评测体系,推动了多模态模型从依赖参照物向独立空间推理的范式转变。
以上内容由遇见数据集搜集并总结生成
相关数据集

暂无相关数据集


