ASVspoof2021_LA
收藏资源简介:
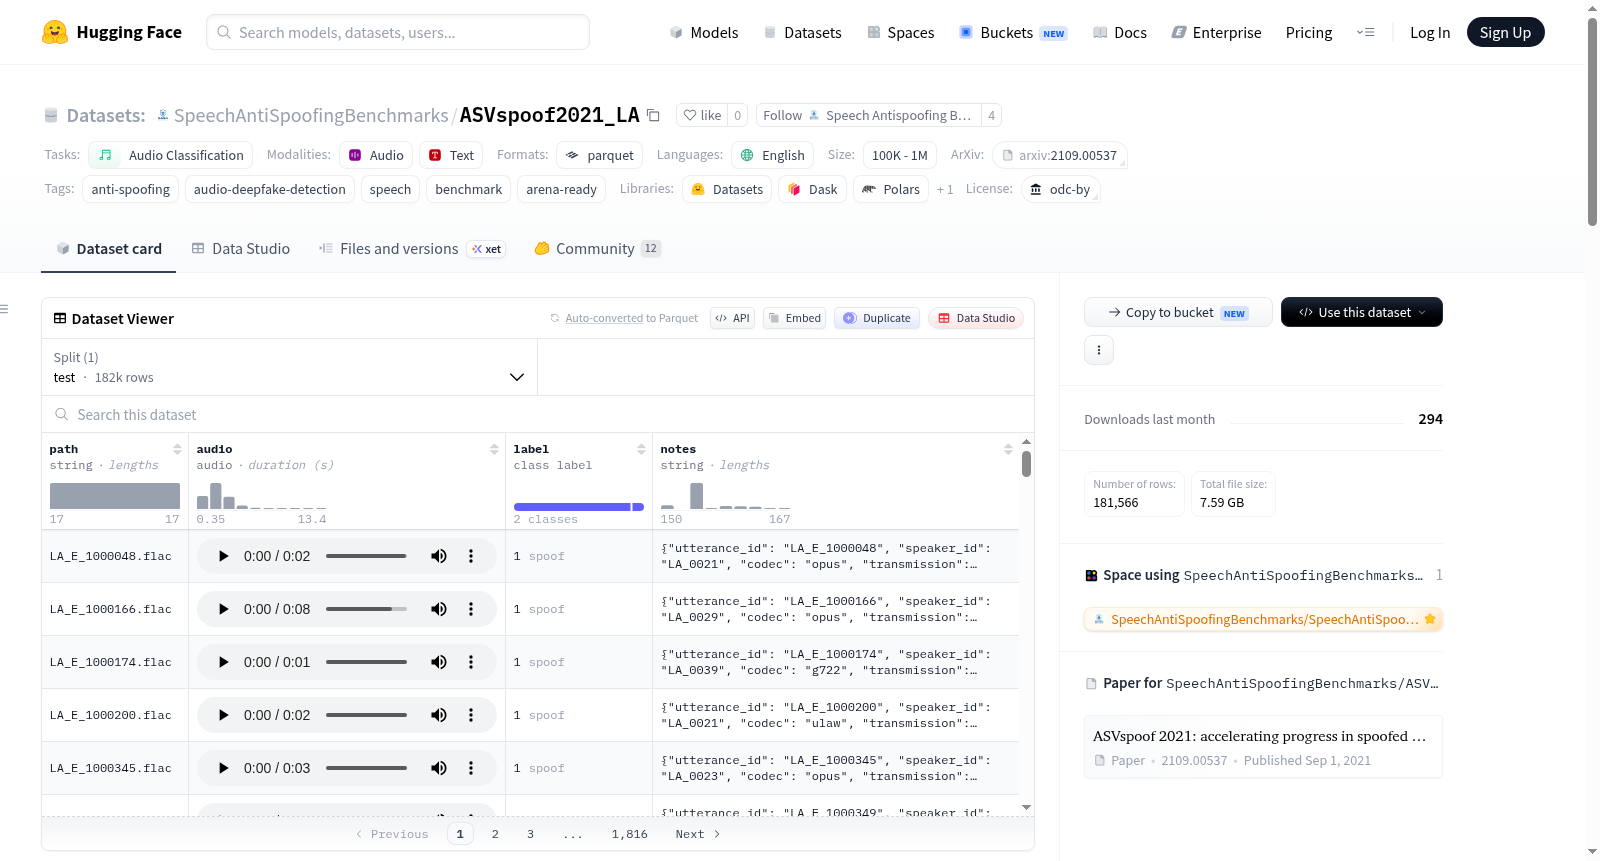
ASVspoop 2021 LA是一个用于语音反欺骗和合成/深度伪造语音检测的基准就绪数据集,包含ASVspoop 2021挑战赛中的逻辑访问(LA)评估子集。该数据集的任务是二分类,旨在区分真实(bonafide,即真实人类语音)与欺骗(spoof,即合成、转换或重放语音)。LA分区在2019年LA攻击基础上增加了真实的电话编解码器/传输条件,以模拟更实际的场景。数据集中音频已转码为标准16 kHz单声道FLAC格式,确保通用可解码性,同时保持PCM样本比特精确和采样率不变。数据集包含181,566个试验,其中真实样本18,452个,欺骗样本163,114个。每个样本包含以下字段:path(稳定存档相对路径)、audio(16 kHz单声道音频波形)、label(分类标签,真实或欺骗)、notes(JSON格式的元数据,包括utterance_id、speaker_id、codec、transmission、attack_id、trim和phase)。该数据集适用于语音反欺骗、深度伪造检测和音频分类基准测试,采用Open Data Commons Attribution License (ODC-By)许可。原始数据集和评估协议可在ASVspoop官网获取,相关研究论文发表于arXiv:2109.00537。
ASVspoop 2021 LA is a benchmark-ready dataset for speech anti-spoofing and synthetic/deepfake speech detection, containing the logical access (LA) evaluation subset from the ASVspoop 2021 challenge. The task is binary classification: distinguishing between bonafide (i.e., genuine human speech) and spoof (i.e., synthetic, converted, or replayed speech). The LA partition incorporates real telephony codec/transmission conditions on top of the 2019 LA attacks. The audio in the dataset has been transcoded to standard 16 kHz mono FLAC format to ensure universal decodability while preserving PCM sample bit-exactness and sampling rate. The dataset includes 181,566 trials, with 18,452 bonafide samples and 163,114 spoof samples. Each sample contains the following fields: path (stable archive relative path), audio (16 kHz mono audio waveform), label (classification label, bonafide or spoof), and notes (JSON-formatted metadata including utterance_id, speaker_id, codec, transmission, attack_id, trim, and phase). This dataset is suitable for speech anti-spoofing, deepfake detection, and audio classification benchmarking, licensed under the Open Data Commons Attribution License (ODC-By). The original dataset and evaluation protocol are available on the ASVspoop website, with related research papers published at arXiv:2109.00537.
ASVspoof 2021 LA 数据集概述
该数据集是 ASVspoof 2021 挑战赛中 逻辑访问(Logical Access, LA)评估分区 的基准封装版本,专用于语音反欺骗和合成/深度伪造语音检测任务。
任务类型
- 音频分类(audio-classification)
- 二分类任务:区分 真实语音(bonafide)与 欺骗语音(spoof,包括合成、转换或重放的语音)
数据集规模
- 总样本数:181,566 条
- 真实语音(Bonafide):18,452 条
- 欺骗语音(Spoof):163,114 条
- 阶段划分(通过
notes.phase字段):- 评估集(eval):148,176 条
- 进度集(progress):16,464 条
- 隐藏集(hidden):16,926 条
- 规模类别:100K < n < 1M
数据格式与结构
| 列名 | 类型 | 说明 |
|---|---|---|
path |
string |
数据集内唯一、稳定的相对路径(如 LA_E_9332881.flac) |
audio |
Audio(16000) |
16 kHz 单声道音频波形 |
label |
ClassLabel |
类别标签:"bonafide"(索引 0)或 "spoof"(索引 1) |
notes |
string |
JSON 格式,包含 utterance_id、speaker_id、codec、transmission、attack_id、trim、phase 等信息 |
核心特点
- 在 ASVspoof 2019 LA 攻击基础上,增加了真实的电话 编解码/传输 条件
- 音频已重新编码为标准 16 kHz 单声道 FLAC 格式,PCM 样本比特级精确,采样率保持不变
- 标签和评估协议未作修改
许可与来源
- 许可协议:Open Data Commons Attribution License (ODC-By)
- 原始数据集地址:https://www.asvspoof.org/index2021.html
- 原始论文:arXiv:2109.00537
- 维护者:k.n.borodin@mtuci.ru
快速使用
python from datasets import load_dataset ds = load_dataset("SpeechAntiSpoofingBenchmarks/ASVspoof2021_LA", split="test") print(ds[0])
引用信息
bibtex @inproceedings{yamagishi21_asvspoof, title = {{ASVspoof 2021: accelerating progress in spoofed and deepfake speech detection}}, author = {Junichi Yamagishi and Xin Wang and Massimiliano Todisco and Md Sahidullah and Jose Patino and Andreas Nautsch and Xuechen Liu and Kong Aik Lee and Tomi Kinnunen and Nicholas Evans and Héctor Delgado}, year = {2021}, booktitle = {{2021 Edition of the Automatic Speaker Verification and Spoofing Countermeasures Challenge}}, pages = {47--54}, doi = {10.21437/ASVSPOOF.2021-8}, }