
遇见数据集

syauqie/IGED

收藏
Hugging Face2026-05-30 更新2026-05-31 收录
官方服务:

资源简介:

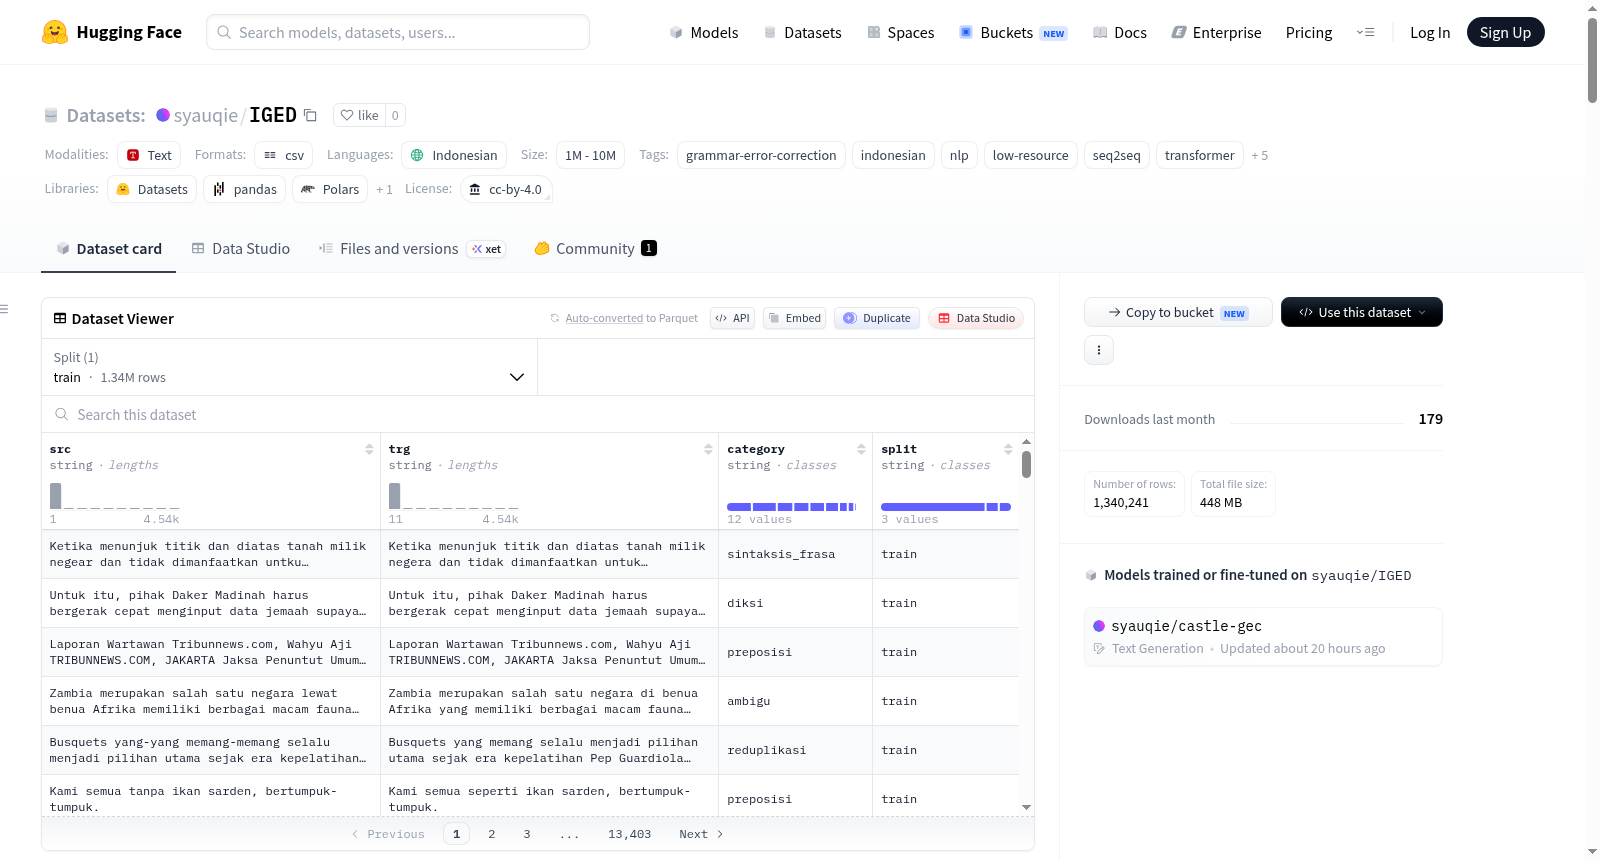
IGED(Indonesian Grammar Error correction Dataset)是一个大规模印尼语语法错误纠正(GEC)数据集,包含1,345,096个句子对,是公开可用的最大印尼语GEC数据集。每个句子对由一个不合语法的源句子和一个语法正确的目标句子组成。数据集覆盖印尼语的三大错误类别:形态学错误(包括词缀、构词和重叠)、句法错误(包括短语结构、介词和句子完整性)和语义错误(包括措辞、冗言和歧义)。IGED是CASTLE系统的一部分,CASTLE是一个用于低资源语法纠正的上下文感知语义Transformer,带有知识图谱增强,相关研究发表于《Expert Systems With Applications》(2026年)。

IGED is a large-scale Indonesian Grammar Error Correction (GEC) dataset containing 1,345,096 sentence pairs — the largest publicly available GEC dataset for Indonesian. Each pair consists of an ungrammatical source sentence and its grammatically correct target. The dataset covers three major error categories in Indonesian: morphological (affixation, word formation, reduplication), syntactic (phrase structure, preposition, sentence completeness), and semantic errors (diction, pleonasm, ambiguity). IGED was introduced as part of the CASTLE system — a Context-Aware Semantic Transformer with Knowledge Graph Enhancement for low-resource grammar correction, published in Expert Systems With Applications (2026).
提供机构:
syauqie
搜集汇总
数据集介绍
syauqie/IGED 数据集图片
构建方式
IGED是印尼语语法错误修正领域迄今规模最大的数据集,包含逾134万对错误-正确句子。其构建源于新闻与学术双源语料:从六大印尼新闻网站与一项本科毕业论文语料库中抽取正确句子后,采用规则与大型语言模型混合的三阶段流水线注入错误。约六成形态学错误(如词缀、重叠)通过Sastrawi词干分析器与词性标注规则生成;约四成语义错误(如歧义、赘述)借助DeepSeek R1模型巧设约束提示构造。最后经由Levenshtein相似度阈值与IndoBERT余弦相似度双重自动筛选,并由语言学专家与研究生手工校验500例样本,Cohen's κ系数达0.82,确保数据质量。
特点
该数据集以细粒度错误分类标签为核心特色,涵盖形态、句法、语义三大主类下含九种子类,如词缀误用、短语结构缺陷与措辞不当等,按比例分布均匀,便于针对性地分析不同错误模式。句对间平均编辑距离高达12.10,显著高于同类数据集,体现出印尼语复杂形态与句法结构带来的纠错难度。数据集已按错误类别分层划分训练(107万)、验证(13.4万)与测试(13.4万)子集,用户可直接按split字段取用,无需再切分。
使用方法
用户可通过HuggingFace的datasets库一键加载数据集:调用load_dataset('syauqie/IGED')即可获取预先切分好的train、val与test子集。每条样本包含src(错误句)、trg(正确句)与category(错误类别)字段,支持按类别过滤——如仅提取语义类错误(diksi、ambiguitas、pleonasme)进行专项训练。该数据集是CASTLE模型的官方训练数据,配合官方代码仓库中的配置文件即可复现论文报道的F1=0.9629、BLEU=92.72的测试集结果。数据集采用CC-BY-4.0许可,使用后须引用CASTLE论文。
背景与挑战
背景概述
印度尼西亚语作为低资源语言,其语法纠错任务长期面临高质量标注数据匮乏的困境。IGED数据集由Syauqie Muhammad Marier及其合作者于2026年提出,旨在填补这一空白。该数据集以CASTLE系统为核心,发表于《Expert Systems With Applications》,包含超过134万句对,覆盖形态、句法和语义三大类九种细粒度错误类型,是迄今为止规模最大的印尼语语法纠错数据集。其构建基于新闻语料库与学术论文语料,融合规则与LLM驱动的错误生成方法,并通过专家验证确保质量,为低资源语言语法纠错研究提供了坚实基础,推动了该领域的发展。
当前挑战
IGED所解决的领域问题在于印尼语复杂的形态结构(如词缀、重叠)与有限的计算资源之间的矛盾,以及错误标注数据稀缺导致的模型泛化能力不足。构建过程中,团队面临两大挑战:一是如何自然生成多样化且真实的语法错误,为此设计了混合三阶段流水线,结合规则与语言模型以确保错误的合理性与覆盖度;二是质量控制,通过自动化过滤与人工审核相结合,达成0.82的Cohen's Kappa一致性。此外,数据集的领域限定于新闻与学术文本,对社交媒体等非正式语境的表现仍待探索,且未覆盖标点错误与语码混用现象,构成其当前局限。
常用场景
经典使用场景
在低资源语言的语法纠错研究中,IGED数据集被广泛用于训练和评估序列到序列(seq2seq)模型,尤其是结合Transformer架构的语法纠错系统。作为当前最大的印尼语语法纠错数据集,它包含超过134万对句子,覆盖形态、句法和语义三大类共计九种细粒度错误类型。研究者通常利用其预划分的训练、验证和测试集来训练模型,并通过BLEU和F1分数等指标评测纠错性能。该数据集特别适合验证知识图谱增强的语义理解方法在低资源语言场景中的有效性。
衍生相关工作
IGED数据集直接催生了CASTLE系统——一种上下文感知语义Transformer框架,通过知识图谱增强技术显著提升了低资源语法纠错的性能。该数据集也被用于微调多语言预训练模型(如IndoBERT和mT5),以探索跨语言迁移学习在印尼语纠错任务中的效果。此外,围绕该数据集的错误分类体系,衍生出多项关于细粒度语法错误诊断的研究,推动了印尼语自然语言处理中错误类型识别与针对性修正的发展方向。
数据集最近研究
最新研究方向
IGED数据集作为印尼语语法纠错领域规模最大的公开资源,有力推动了低资源语言自然语言处理的前沿探索。当前研究热点聚焦于结合上下文感知语义与知识图谱增强的Transformer架构,以应对印尼语复杂的形态、句法和语义错误交织难题。该数据集通过精细的错误类别划分(覆盖九种亚类型)为细粒度纠错和错误模式分析提供了基准,伴随CASTLE系统的高F1与BLEU得分表现,标志着合成数据构造与专家验证结合范式在低资源语法纠错中的突破性进展,为多语言NLP公平性研究奠定了重要基石。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

