
遇见数据集

parsa-mz/puzzlezoo

收藏
Hugging Face2026-05-29 更新2026-05-31 收录
官方服务:

资源简介:

PuzzleZoo是一个包含三个推理/规划基准的数据集,旨在评估大型语言模型在多步骤程序性问题解决上的性能。该数据集是论文《RePoT: Recoverable Program-of-Thought via Checkpoint Repair》的官方评估套件,并作为独立基准发布给更广泛的社区。数据集包括:1) PuzzleZoo-775:包含775个分层谜题实例,覆盖四个经典规划环境(汉诺塔、跳棋过河、河内塔、积木世界),每个环境在可控复杂性下生成,以测量解决率随规划长度下降的情况;2) PlanBench-Blocksworld-378:包含378个Blocksworld实例(3-12个积木),改编自PlanBench,采用与PuzzleZoo相同的记录模式,用于第三方复制;3) Derail-550:包含550个方法无关的中途错误注入案例,每个案例固定一个问题,部分执行预言计划,注入单个错误动作,并将结果状态传递给恢复方法,以隔离驱动恢复的信号。总计1703条记录,所有配置模式兼容。该基准的特点包括按复杂性分层、提供步骤级验证器(无LLM判断)、以及方法无关的恢复评估,支持多步骤程序规划、错误恢复能力和方法对检查点信号依赖的评估。

PuzzleZoo is a collection of three reasoning/planning benchmarks designed to evaluate large language models on multi-step procedural problem-solving. It is the official evaluation suite for the paper RePoT: Recoverable Program-of-Thought via Checkpoint Repair and is released as a standalone benchmark for the broader community. The dataset includes: 1) PuzzleZoo-775 — 775 stratified puzzle instances across four classical planning environments (Tower of Hanoi, Checker Jumping, River Crossing, Blocksworld), each generated at controllable complexity to measure how solve-rate degrades with horizon length; 2) PlanBench-Blocksworld-378 — 378 Blocksworld instances (3–12 blocks) adapted from PlanBench into the same record schema as PuzzleZoo, used as a third-party replication target; 3) Derail-550 — 550 method-agnostic mid-rollout error-injection cases, each fixing a problem, walking an oracle plan partway, injecting a single wrong action, and handing the resulting state to a recovery method to isolate which signal drives recovery. Together, the three configs cover 1703 records, all schema-compatible. The benchmark features stratification by complexity, step-level verifier (no LLM judge), and method-agnostic recovery evaluation, intended to assess multi-step procedural planning, error recovery/replanning ability, and how a methods effectiveness depends on checkpoint signals.
提供机构:
parsa-mz
搜集汇总
数据集介绍
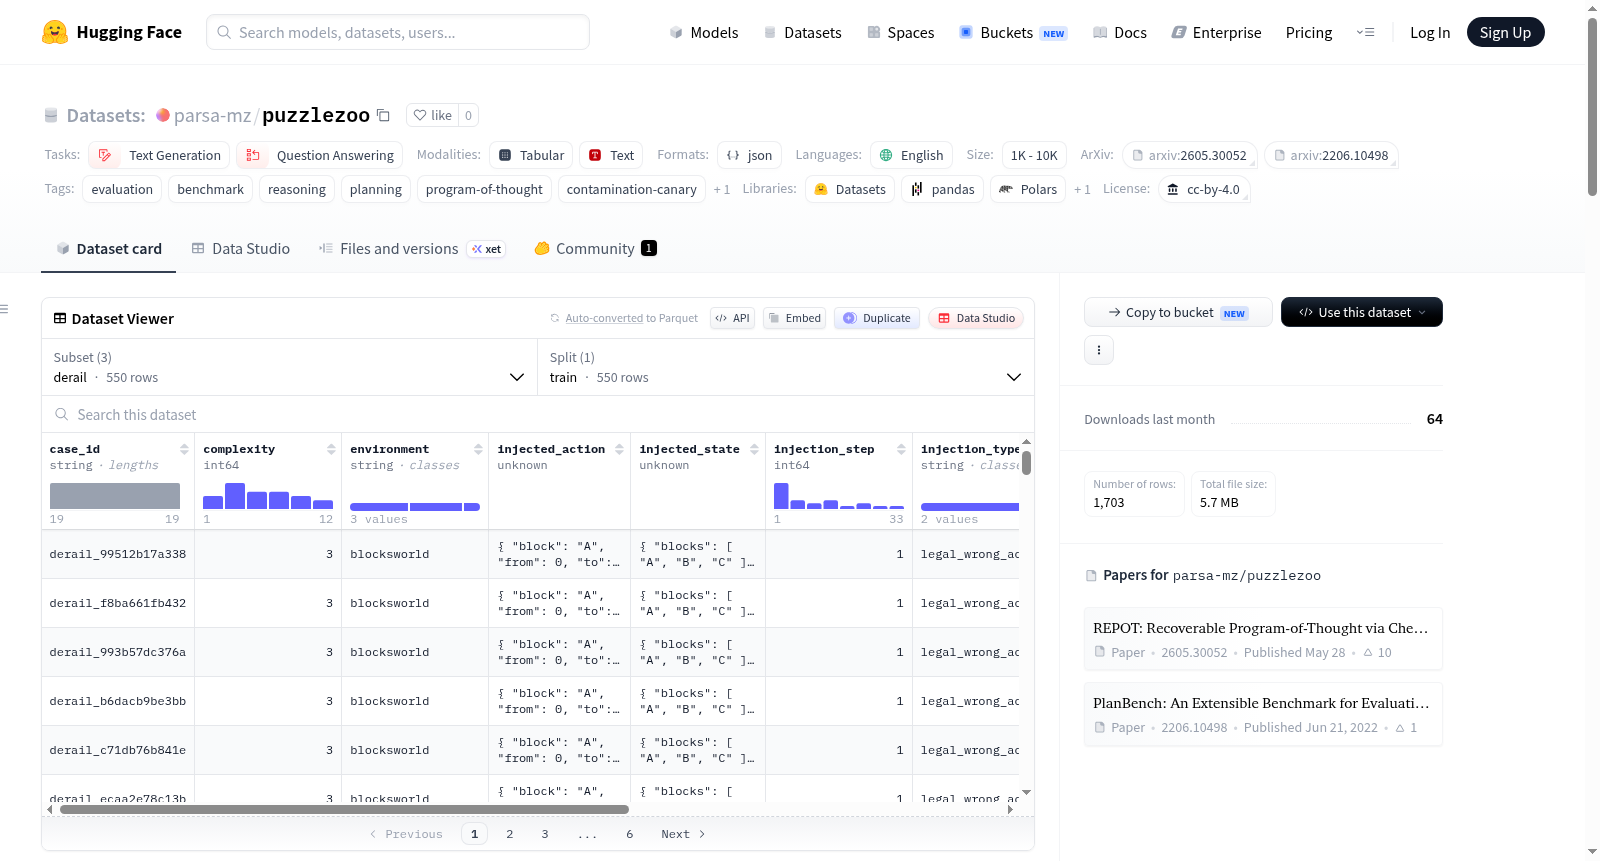
parsa-mz/puzzlezoo 数据集图片
构建方式
PuzzleZoo是由三个子集构成的综合推理与规划评估基准,旨在衡量大语言模型在多步程序性求解中的表现。其核心子集PuzzleZoo-775包含775个分层难度实例,涵盖汉诺塔、跳棋、过河与积木世界四类经典规划环境,每个实例均通过调控圆盘数、积木数等参数生成可控复杂度。PlanBench-Blocksworld-378则从PlanBench基准迁移了378个积木世界问题,统一采用与PuzzleZoo兼容的记录模式。Derail-550子集独创性地固定了故障点,通过预设部分路径、注入单一错误动作与提供可信检查点的方式,为不同恢复方法提供一致的初始状态,从而实现方法间公平的因果比较。
使用方法
用户可通过HuggingFace Datasets库便捷加载PuzzleZoo的三个子集,例如使用load_dataset('parsa-mz/puzzlezoo', 'puzzlezoo')获取主数据集。每个子集均遵循统一的键值模式,包含问题标识、环境类型、复杂度、初始与目标状态、标准解及自然语言提示等字段。Derail子集额外记录了注入步骤、错误动作类型与检查点状态信息。研究者可基于这些数据设计自主的规划与恢复架构,并通过数据集附带的验证器进行公平评估。需要注意的是,该数据集仅供评估使用,其包含的金丝雀标识可用于检测模型是否在训练阶段接触过本基准。
背景与挑战
背景概述
PuzzleZoo是由Parsa Mazaheri于2026年创建的多步骤推理与规划基准测试集,源自论文《RePoT: Recoverable Program-of-Thought via Checkpoint Repair》,旨在评估大语言模型在复杂程序性任务中的表现。该数据集包含1703条记录,横跨三个子集:PuzzleZoo-775(涵盖汉诺塔、跳棋、过河及积木世界四种经典规划环境)、PlanBench-Blocksworld-378(基于PlanBench的积木世界实例)和Derail-550(方法无关的中间阶段错误注入案例)。其核心创新在于通过复杂度分层、确定性验证器及方法无关的错误恢复机制,推动了从单一最终答案评分到过程级失败点分析的范式转变,为推理与规划领域提供了精细化的评估工具。
当前挑战
PuzzleZoo致力于解决主流推理基准测试(如GSM8K、MMLU)仅关注最终答案且已趋饱和的局限,挑战在于量化模型在多步骤规划中逐步失效的位置与原因。具体而言,构建过程中面临三大挑战:一是设计可控复杂度分层(如盘片数、积木数),以精确测量计划长度与成功率的退化曲线;二是实现确定性环境验证器,确保候选计划按步骤回放并定位首个错误动作,替代依赖LLM判断的模糊评估;三是通过Derail-550分离恢复方法与失败点的因果关联——每个案例固定相同的损坏状态、可信检查点和验证器错误,使跨方法对比从相关性提升至因果性,避免因恢复信号差异而混淆结果。
常用场景
经典使用场景
PuzzleZoo数据集主要用于评估大型语言模型在多步程序性规划任务中的推理与规划能力。其核心使用场景包含三个维度:其一,通过775个分层级谜题实例(涵盖汉诺塔、跳棋、过河问题及积木世界四大经典规划环境),系统性地衡量模型在不同复杂度下的求解成功率;其二,包含378个源自PlanBench的积木世界实例,作为跨平台复现基准;其三,提供550个与方法无关的中途错误注入案例,专门用于评估模型的错误恢复与重规划能力。该数据集采用确定性环境验证器,可定位每一步行动的有效性,从而精准刻画模型在长规划链中的性能衰减轨迹。
解决学术问题
该数据集解决了现有推理基准测试中普遍存在的两大核心学术问题:一是传统基准仅评估最终答案正确性,无法揭示模型在规划过程中何时、因何失败;二是多数基准已被前沿模型饱和,难以区分不同模型间的细微能力差异。PuzzleZoo通过将实例按复杂度分层,并引入步骤级验证机制,使得研究人员能够绘制求解率随规划长度的衰减曲线,甄别模型在长链推理中的薄弱环节。此外,Derail子集通过固定失败点的方法,首次实现了不同恢复技术间的因果性比较,推动了对模型鲁棒性和自我纠错能力的系统性研究。
实际应用
在实际应用中,PuzzleZoo可作为大语言模型在自动化规划、具身智能和任务执行等领域的核心评估工具。例如,在机器人任务规划场景中,模型需生成从初始状态到目标状态的动作序列,一旦某一步执行错误,需具备从错误中恢复并重新规划的能力;在代码生成与自动修复系统中,该数据集可模拟程序执行过程中的逻辑错误,测试模型对程序状态的中断检测与修复能力。此外,该数据集适用于智能客服、自动化实验设计等领域,帮助评估模型在复杂、多步决策任务中的可靠性与鲁棒性。
数据集最近研究
最新研究方向
PuzzleZoo数据集聚焦于大规模语言模型在多步程序性规划中的错误恢复与可验证推理能力评估。该基准包含1703个实例,覆盖经典规划环境与受控复杂度分层,通过可恢复程序思维(RePoT)框架引入检查点修复机制,为评估模型在规划轨迹被破坏时的恢复能力提供了因果可比的评测方法。其核心创新在于提供方法无关的错误注入基准(Derail-550),消除恢复策略与失败过程之间的混淆效应,推动规划模型从最终答案评分向细粒度过程诊断的范式转变,对增强语言模型在现实复杂任务中的可信执行具有重要意义。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

