
遇见数据集

erzanugroho/soal-ujian-sd-kurikulum-merdeka

收藏
Hugging Face2026-05-29 更新2026-05-31 收录
官方服务:

资源简介:

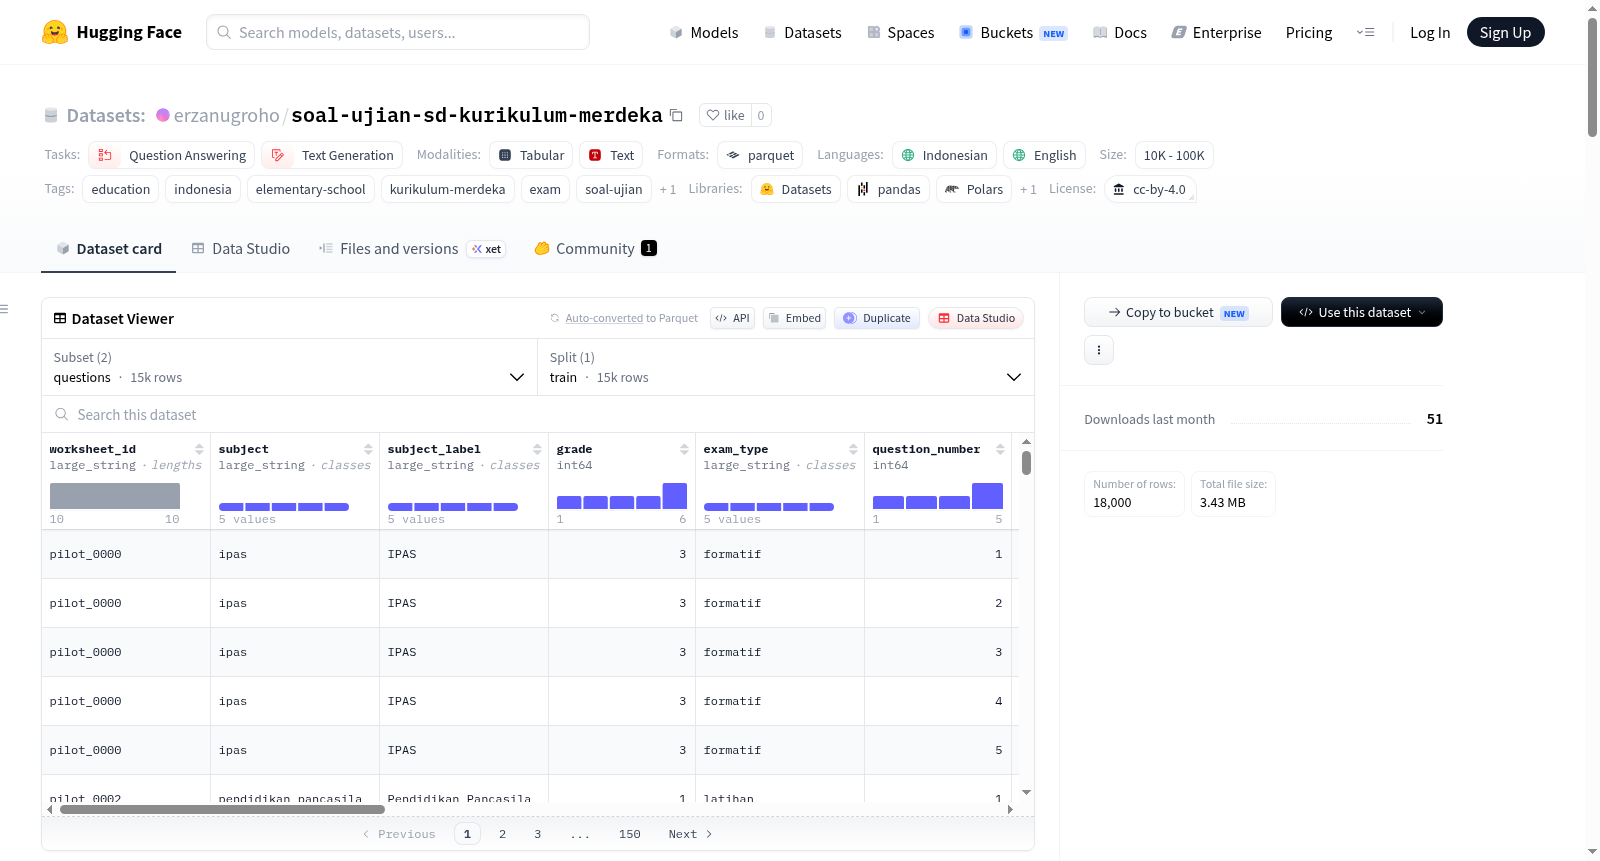
该数据集是一个印度尼西亚小学(SD)考试题目数据集,遵循Kurikulum Merdeka(独立课程)标准,涵盖1至6年级(阶段A、B和C)。每个条目是一张包含5个问题的试卷,问题组成根据考试类型而定。数据集包含3,000张试卷和15,000个问题,均匀分布在5个学科、6个年级和5种考试类型中。数据集有两个配置:worksheets(每张试卷完整信息)和questions(每个问题单独一行,便于过滤和分析)。问题类型包括单选题、多选题和判断题,并标注了认知水平(Bloom的C1-C4)。数据集通过LLM生成并经过自动严格验证,但需教师审查以确保事实准确性。

A dataset of Indonesian elementary school (SD) exam questions, built following the Kurikulum Merdeka curriculum for Grades 1 to 6 (Phase A, B, and C). Each entry is a worksheet containing 5 questions with composition according to the exam type. The dataset includes 3,000 worksheets and 15,000 questions, evenly distributed across 5 subjects, 6 grades, and 5 exam types. It has two configurations: worksheets (complete worksheet per row) and questions (flattened per question for easy filtering/analysis). Question types include single-choice MCQ, multi-choice MCQ, and true/false, with cognitive levels (Blooms C1-C4) annotated. The dataset is generated by LLM and automatically validated, but requires teacher review for factual accuracy.
提供机构:
erzanugroho
搜集汇总
数据集介绍
erzanugroho/soal-ujian-sd-kurikulum-merdeka 数据集图片
构建方式
该数据集由大型语言模型自动生成,并经过严格的自动化验证流程构建而成。所有生成的试题均需通过结构性与规则性校验,包括JSON模式验证、题目类型与考试类型配比检查、主题与对应年级大纲的匹配度审查,以及语言一致性与认知层级(基于布鲁姆分类法C1至C4)的合规性确认。此外,数据集实施了去重机制,确保不存在两份完全相同的试卷。最终,包含逾15,000道试题的约3,000份试卷得以保留,覆盖了印尼小学1至6年级的5门核心学科。
特点
该数据集的一大特色是围绕印尼"独立课程"进行了精细的结构化设计。它提供了两种数据配置:"worksheets"以完整试卷为单位,每份包含5道题目;"questions"则将题目展平至单题层级,便于针对性分析和筛选。数据集在年级、学科和考试类型(练习、形成性测试、期中、期末及升学考)三个维度上实现了均匀分布,每种组合均生成600份试卷。此外,题目类型涵盖了单选题、多选题和是非判断题,并附有详细的元数据标签,如认知层级和主题。
使用方法
使用者可通过HuggingFace的`datasets`库便捷加载数据。加载"worksheets"配置可获取整份试卷,包含试卷ID、学科、年级、考试类型及以JSON字符串形式存储的五道题目,适用于生成式与评估类任务。加载"questions"配置则直接获得每条记录的单个题目及其所有属性,方便进行按学科或年级的过滤与统计分析。使用者在实际教学中需注意,由于内容由模型生成,在课堂应用前建议由教师进行事实性审查。
背景与挑战
背景概述
在印度尼西亚基础教育改革的浪潮中,Kurikulum Merdeka(自由课程)的推行对教学评估体系提出了全新要求,亟需与之匹配的高质量、结构化的评估数据资源。为此,研究者Erza Nugroho于2026年发布了Soal Ujian SD Kurikulum Merdeka数据集,旨在为小学1至6年级提供覆盖五门核心学科(数学、印尼语、科学、潘查希拉教育、英语)的标准化试题库。该数据集包含3000份完整试卷与15000道独立题目,严格遵循Kurikulum Merdeka各阶段(Fase A、B、C)的认知层级要求,并融入了多种题型(单选、多选、判断题)。其出现填补了印尼母语教育评估领域结构化开放数据的空白,为自然语言处理、教育测评及个性化学习系统的研究提供了关键的实证基础。
当前挑战
该数据集所应对的领域核心挑战在于解决印尼基础教育评估中试题资源匮乏、分布不均且与新型课程体系适配性差的问题,尤其是需要生成能精准反映Kurikulum Merdeka各阶段认知梯度(C1至C4)的标准化题目。在构建过程中,研究人员面临严格的结构化约束:需利用大语言模型自动生成内容,并通过自动化管道确保每份试卷的JSON模式、题型组合(如latihan类全为单选)、学科语言一致性(非英语科目必须使用印尼语)以及去重校验均无差错。此外,由于认知层级(Bloom’s taxonomy)与年级(Fase)的强绑定关系,自动生成时需精确控制题目难度与分类标签。最终,数据集虽通过结构验证,但声明内容为模型生成、需教师人工复核,这揭示了当前自动化生成可靠教育评估数据的根本性瓶颈——结构性正确与事实性准确之间的鸿沟。
常用场景
经典使用场景
该数据集在印尼基础教育领域具有广泛的应用场景,尤其是在教育科技与自然语言处理交叉的研究中。其所包含的3000份完整试卷和15000道独立试题,覆盖从一年级至六年级数学、印尼语、科学、公民教育与英语五个核心科目,构成了一个结构清晰、标注丰富的多学科评测资源。研究者可将数据集应用于自动试题生成、阅读理解与多项选择问答系统的训练与评估。此外,数据集按题型(单选题、多选题、判断题)和认知层级(Bloom分类C1至C4)进行精细化标注,使其成为评测智能辅导系统对印尼语学业水平认知能力诊断的理想基准。
衍生相关工作
该数据集在衍生研究工作方面具有深远影响,催生了多项围绕印尼语教育知识图谱构建、试题难度预测模型以及多任务学习框架的学术探索。研究者借鉴其结构化题库设计,开发了面向低年级学生的认知诊断模型与知识点追踪系统,通过分析学生在不同认知层级题目上的表现,实现对个性化学习路径的智能规划。同时,数据集的多种题型与题型混合策略启发了自动生成多样化试题的生成式方法研究,包括基于大语言模型的条件文本生成与多答案选择优化。这些衍生工作不断拓展该数据集的理论边界,并推动低资源语言教育AI向更加稳健、可解释的方向演进。
数据集最近研究
最新研究方向
在教育领域,该数据集契合了印度尼西亚'Kurikulum Merdeka'独立课程改革的前沿动向,聚焦于生成式人工智能与标准化评估的深度融合。通过LLM自动生成覆盖1至6年级、多学科与多题型(如选择题、复合选择、是非题)的考试试题,并辅以严格的自动化验证流程,确保了数据在结构、语义与难度分布上的高保真度。此举不仅大幅降低了人工命题成本,更支撑了AI驱动的自适应学习系统、智能阅卷与个性化诊断等热点研究,为低资源语言环境下的智能教育提供了可复用的可信基准,推动了教育公平与数字转型的实质性落地。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

