
budecosystem/superglue_wic
收藏官方服务:
资源简介:
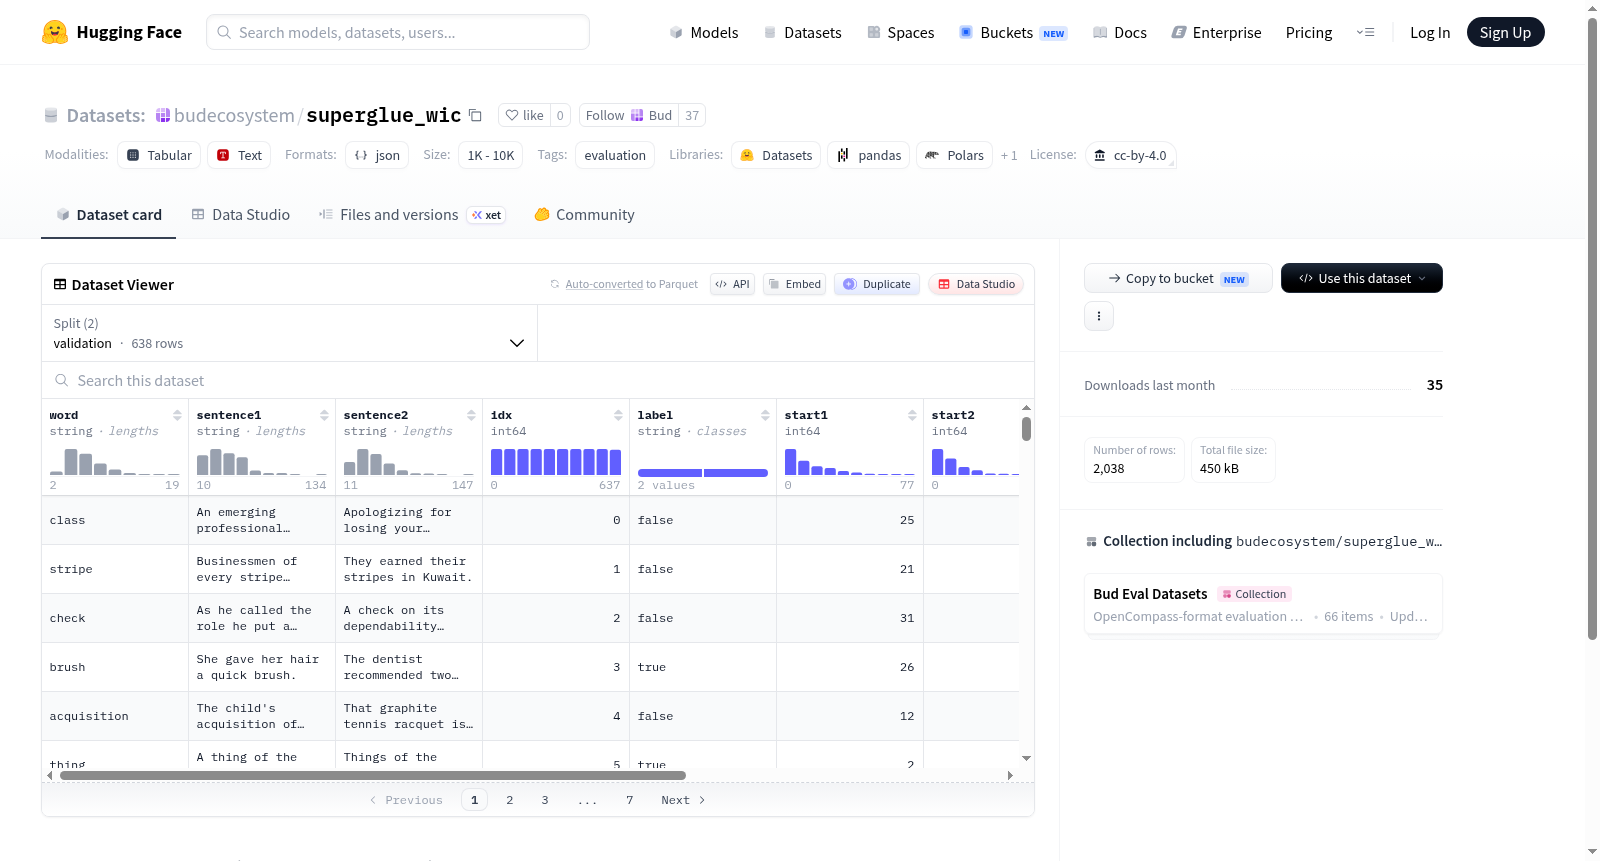
WiC(Words-in-Context)评估数据集,以OpenCompass格式提供,是SuperGLUE基准测试的一部分。该数据集用于评估模型在上下文中的词义理解能力,包含词语在不同句子中的使用示例,要求模型判断同一词语在不同语境中是否具有相同含义。数据以OpenCompass原生格式布局,路径为SuperGLUE/WiC/,源自OpenCompass数据分发,许可证为CC-BY-4.0。
WiC (Words-in-Context) evaluation data in OpenCompass format, part of the SuperGLUE benchmark. This dataset is designed for evaluating models ability to understand word meanings in context, containing examples of words used in different sentences, where models must determine if the same word has identical meanings across contexts. The data is laid out in native OpenCompass format at SuperGLUE/WiC/, sourced from the OpenCompass data distribution, with license CC-BY-4.0.
提供机构:
budecosystem搜集汇总
数据集介绍
构建方式
在自然语言处理的广阔领域中,词汇义项消歧始终是一项核心挑战,而WiC(Word-in-Context)数据集正是为解决这一问题而设计的评测基准。该数据集源自SuperGLUE评测体系,专注于判断同一单词在不同上下文语境中是否具有相同的语义含义。本版本的数据集以OpenCompass格式进行封装,严格遵循SuperGLUE/WiC原有的数据划分与标注结构,确保与OpenCompass数据加载器无缝兼容。数据来源于OpenCompass的官方分发,原始标注与格式未作任何修改,仅对其进行重新整理以适配特定评测框架的需求。
特点
该数据集的突出特点在于其专注于细粒度的词汇语义理解任务,通过成对的上下文句子来考察模型对词义微妙变化的感知能力。每个样本包含一个目标单词及其所处的两个不同句子,标注者需判断该词在两句中的语义是否相同,这一设计直接挑战模型对上下文依赖型词汇歧义的解析能力。数据集规模紧凑但难度较高,是评估模型词汇语义理解深度的关键指标之一。此外,本版本采用CC-BY-4.0许可协议,保障了数据使用的开放性与合规性。
使用方法
在使用方法上,本数据集已按照OpenCompass评测框架的标准目录结构进行组织,用户可直接将其放置于OpenCompass项目的数据目录下,无需额外的格式转换或预处理步骤。通过OpenCompass的配置文件指定数据集路径与评测任务类型,即可自动加载WiC数据并运行模型评估。建议在评估时结合SuperGLUE基准中的其他任务一同使用,以全面衡量模型在词汇语义理解维度的综合表现。数据加载过程中需注意保持原始标注的完整性,避免对标签或文本进行二次修改。
背景与挑战
背景概述
SuperGLUE基准测试是自然语言处理领域继GLUE之后的重要里程碑,于2019年由纽约大学、华盛顿大学等机构联合推出,旨在解决GLUE中模型性能已接近人类水平的问题,提出更具挑战性的任务集。其中,WiC(Word-in-Context)任务聚焦于词汇语义消歧,要求模型判断同一单词在不同上下文语境中是否具有相同含义。该数据集由多所顶尖研究机构共同构建,通过精细设计的情境对比,评估模型对词义动态变化的捕捉能力。作为SuperGLUE子任务之一,WiC对推动自然语言理解中的上下文敏感语义表示研究具有显著影响力,尤其在词义消歧和基于语境的词汇理解领域,成为衡量模型语言理解深度的关键基准。
当前挑战
WiC数据集所解决的领域问题是词汇语义歧义消解,即准确识别单词在不同语境下的含义差异,这是自然语言理解的核心挑战之一。模型需超越表面匹配,深入理解上下文语义关系。构建过程中面临的主要挑战包括:设计具有明确语义差异但不易被浅层特征(如词性、共现词)区分的成对实例;确保数据标注的一致性,因词义边界模糊而需要精确判定;平衡正负样本分布,避免模型倾向于统计捷径。此外,WiC作为SuperGLUE评估子任务,其小样本特性要求模型具备更强的泛化能力,而非依赖大规模参数记忆,这对预训练语言模型的鲁棒性提出更高要求。
常用场景
经典使用场景
WiC(Word-in-Context)数据集是自然语言处理领域中用于评估词汇语义消歧与词义理解能力的经典基准。该数据集聚焦于判断一个多义词在不同句子上下文中是否承载相同的语义含义,旨在检验模型对词语语境化语义的敏感度。研究者通常利用该数据集开展词语级别语义相似性判别任务,通过构造正负样本对,迫使模型不仅理解词汇本身,还需捕捉上下文微妙的语义变迁。作为SuperGLUE评测体系的重要组成部分,WiC广泛用于比较不同语言模型在词义消歧上的表现差异,从而推动更具上下文感知能力的语义表示学习。
衍生相关工作
WiC数据集的提出催生了一系列相关的经典研究工作,包括基于对比学习的词义表示优化方法、融合外部知识库的消歧增强模型以及多任务学习框架下的语义理解方案。许多研究团队以WiC为评估基准,提出了诸如“词汇语义锚定网络”、“上下文感知动态词典”等创新架构,显著提升了细粒度词义判断的性能。此外,该数据集还启发了跨语言版本的词义消歧评测集合构建,推动多语言语义表征的统一研究。这些衍生工作不仅验证了WiC任务设定的有效性,也持续拓展了词汇语义理解的研究边界。
数据集最近研究
最新研究方向
在自然语言理解领域,SuperGLUE WiC数据集聚焦于词义消歧这一核心挑战,其最新研究方向紧密围绕上下文感知的词汇语义判别。随着大语言模型的崛起,研究者利用该数据集评估模型对多义词在特定语境中的细微语义差异的捕捉能力,成为检验模型深度理解文本的关键基准。相关热点事件包括各顶尖团队在SuperGLUE榜单上的激烈角逐,推动了对比学习与动态嵌入技术在词义区分上的创新应用。该数据集的意义在于为词汇级语义理解设立了严格标尺,促进了对模型常识推理与语言歧义处理能力的量化评测,进而深刻影响NLP系统在智能问答、机器翻译等场景中的精准度提升。
以上内容由遇见数据集搜集并总结生成


