
遇见数据集

karthik/voiceenv-money-transfer

收藏
Hugging Face2026-05-28 更新2026-05-31 收录
官方服务:

资源简介:

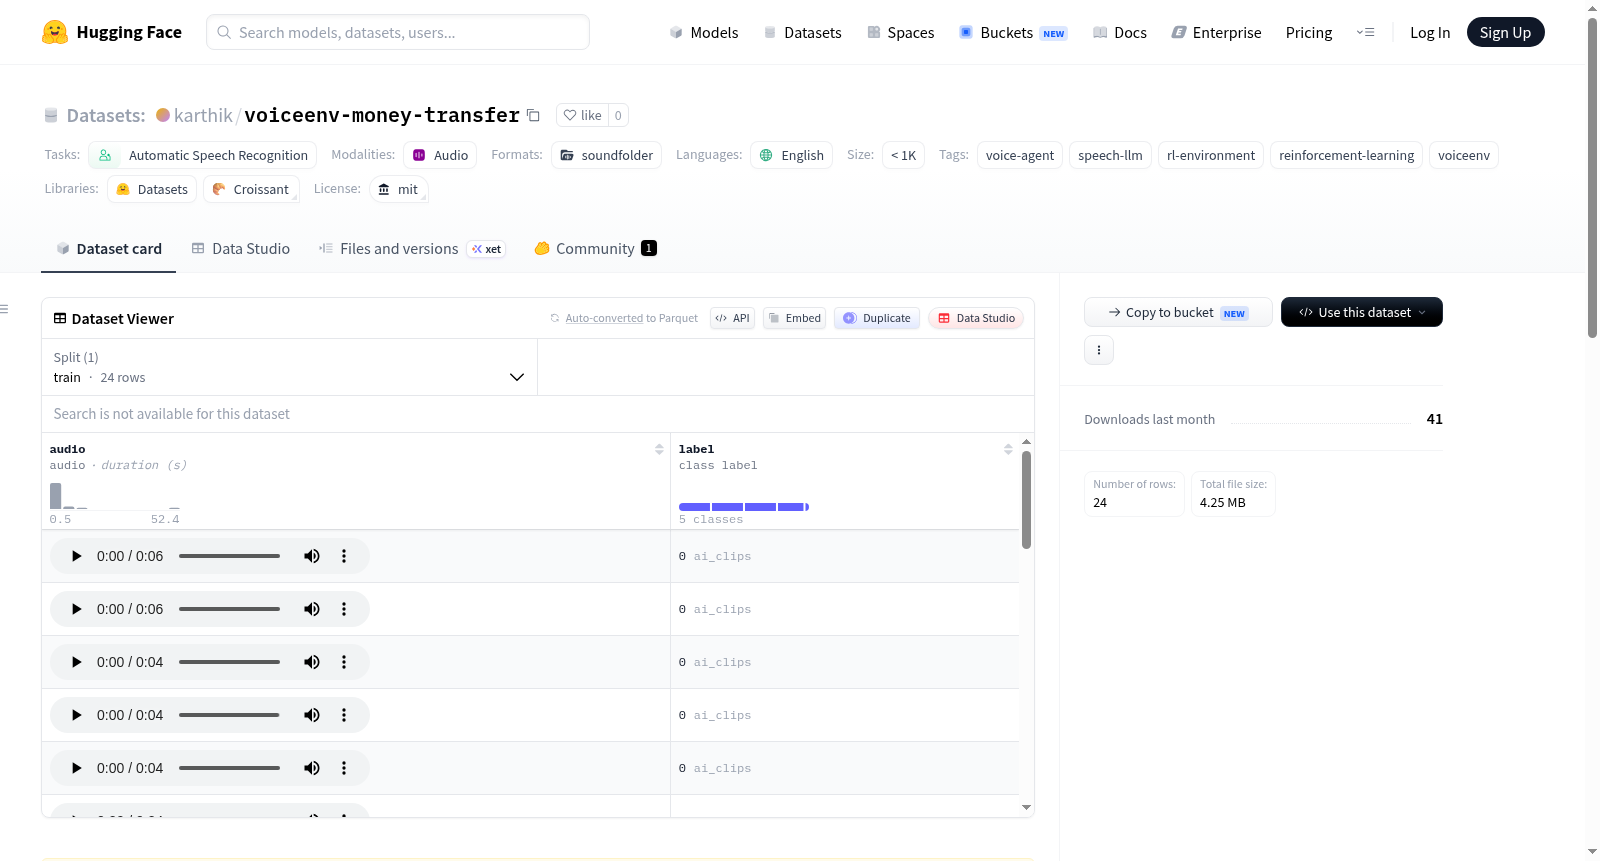
VoiceEnv: Money Transfer是一个基于单个人类真实通话录音(来自HVB数据集)自主提取的语音代理强化学习环境。该数据集专注于转账任务,包含环境规范(任务、角色、工具、评估标准和专家参考)、原始通话录音、通话方音频片段、真实人类代理响应音频以及AI代理响应音频。它旨在支持语音代理的开发和评估,通过强化学习环境促进系统提示的改进。

VoiceEnv: Money Transfer is an autonomously-extracted voice-agent reinforcement learning environment built from a single real human-human call recording (from the HVB dataset). The dataset focuses on a money transfer task and includes the full environment specification (task, persona, tools, rubric, and expert reference), the original real human-human call recording, per-turn caller audio clips, human agent response audio, and AI agent response audio. It is designed to support the development and evaluation of voice agents, facilitating system-prompt improvement through a reinforcement learning environment.

提供机构:
karthik
搜集汇总
数据集介绍
karthik/voiceenv-money-transfer 数据集图片
构建方式
VoiceEnv-Money Transfer数据集源自HVB数据集中一段真实的银行转账人机对话录音,通过全自动化的语音智能体强化学习环境生成流水线构建。该流水线首先利用Whisper模型对原始音频进行转录,随后借助GPT-4o-mini语言模型自动提取任务目标、人设、工具调用模式及可验证的评估规则。在此基础上,采用无状态的轮次级评估方式,以gpt-audio-mini生成智能体响应,并利用Gemini多模态模型锚定真实人类录音进行接地评判。最后,系统通过环境驱动的提示词优化迭代,使评分平均提升0.50分,人类相似度提升1分,从而产生最终版本的环境规格与配套音频素材。
特点
该数据集以单一真实人机对话录音为锚点,构建了一个高度结构化的语音智能体强化学习环境,包含完整的环境规范文档、专家参考音频、逐轮次呼叫者音频切片、人类坐席响应以及多版本AI智能体响应。其核心特色在于利用大语言模型自动抽取可验证的评估准则,并引入多模态接地评判机制,确保评估结果锚定真实人类行为。此外,数据集内置了环境驱动的系统提示词优化循环,能够通过迭代提升智能体在任务完成度和人类相似度等维度的表现,为语音对话智能体的训练与评估提供了可复现的基准场景。
使用方法
用户可通过VoiceEnv核心库的Python接口直接加载环境:首先导入voiceenv.core.schema模块中的VoiceEnvironment类,再调用from_yaml方法解析数据集提供的env.yaml配置文件即可获得完整的强化学习环境。该环境支持基于规则的自动化评估、智能体策略的迭代优化,以及多轮对话模拟。数据集还提供了Docker化的OpenEnv空间封装版本,用户可通过HuggingFace Spaces直接交互体验,无需繁琐的环境配置即可快速开展语音智能体的性能评测与训练实验。
背景与挑战
背景概述
VoiceEnv-Money Transfer数据集诞生于语音交互与强化学习交叉领域的前沿探索,由研究者Karthik Ganesan等人于近期构建,依托于HVB真实人机对话录音库。其核心研究问题聚焦于如何从单一真实通话录音中自动提取可复用的语音智能体强化学习环境,以推动语音大语言模型(Speech-LLM)在任务导向型对话中的自主决策能力。该数据集通过自动化流水线生成环境规范、可验证评估标准及专家参考轨迹,显著降低了构建语音RL环境的成本与门槛,为语音智能体在金融转账等敏感场景中的部署提供了标准化的测试基准,对语音AI领域从规则驱动向数据驱动范式的转变具有启发性影响。
当前挑战
该数据集面临的核心挑战源于所解决的领域问题:语音智能体强化学习环境缺乏从真实通话中自动构建的标准化方法,传统依赖人工标注或合成数据的方式难以捕获真实交互的复杂性与噪声。在构建过程中,主要挑战包括:1)从单一录音中可靠地提取任务、角色、工具架构及可验证评估指标,需克服Whisper转录误差与GPT-4o-mini结构化提取的不稳定性;2)实现状态无关的逐轮评估,需将实时语音交互分解为独立回合,同时保持对话上下文的连贯性;3)基于真实人声录音进行多模态判决时,需对齐AI生成语音与原始对话在韵律、情感及任务完成度上的语义鸿沟,确保评估的公正性与鲁棒性。
常用场景
经典使用场景
VoiceEnv-Money Transfer数据集从一段真实的银行转账客服对话录音中自动提取构建,为语音智能体强化学习环境提供了标准化测试基准。研究者可基于该环境评估和优化语音助手的转账任务完成能力,通过环境规范(env.yaml)定义的任务描述、角色设定、工具调用规则和评分细则,实现对语音AI从理解用户意图到执行转账操作的全流程闭环评测。该数据集的经典用法是利用其内置的多模态裁判机制——以真实人类录音为锚点,结合语义、情感和任务完成度等维度,对语音智能体的每轮对话进行细粒度评分,从而系统性改进系统提示策略。
衍生相关工作
VoiceEnv-Money Transfer作为开源项目VoiceEnv的衍生数据集,启发了多个后续研究方向。研究者在此基础上开发了跨场景的语音环境自动生成工具链,将同样的流水线应用于医疗咨询、外卖点单等其他垂直领域。更重要的是,该数据集催生了以多模态锚定评判为核心的新评估方法——通过对比AI响应与真实人类录音在韵律、情感和语用上的差异,显著提升了语音Agent的自然度评分(提升幅度达+0.50)。这些工作共同推动了语音强化学习从模拟环境向真实数据驱动的生态演进,也为后续构建更大规模的语音交互环境库奠定了方法论基础。
数据集最近研究
最新研究方向
该数据集聚焦于语音代理强化学习环境的自动构建与评估,前沿研究方向包括利用单次真实人机对话录音自动提取任务、角色、工具及可验证评估框架,通过多模态评判(如Gemini与真实录音锚定)提升语音代理在金融转账场景下的表现。相关热点事件涉及语音大模型(Speech-LLM)在客服自动化中的落地,以及强化学习环境从文本向语音模态的迁移。该研究的核心意义在于大幅降低了语音代理训练数据的采集与标注成本,通过环境驱动的提示优化循环实现了代理响应质量(+0.50平均分)与人类相似度的显著提升,为金融、客服等高风险领域构建可扩展的语音交互系统奠定了方法论基础。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

