
遇见数据集

Claude-4.0-DeepSeek-R1-RP-SFWish

收藏
Hugging Face2025-06-10 更新2025-06-11 收录
官方服务:

资源简介:

这是一个包含随机生成的对话响应的数据集,对话基于特定情节类别。每个响应的长度是动态变化的,LLM以第三人称或第一人称回应。数据集经过清理并转换为OpenAI对话格式,同时保留了原始的对话输出。数据集增加了Claude Haiku和其他诗歌格式的对话,并使用Deepseek R1模型增加了更多的对话内容。数据集遵循PG-13限制,保证内容适合所有年龄层。

This is a dataset containing randomly generated dialogue responses rooted in specific plot categories. Each response features a dynamically variable length, and the LLM generates responses in either third-person or first-person perspective. The dataset has been cleaned and converted to the OpenAI conversation format while retaining the original dialogue outputs. Additional dialogue content formatted in Claude Haiku and other poetic styles has been incorporated into the dataset, with more dialogue samples generated using the Deepseek R1 model. The dataset adheres to PG-13 content restrictions, ensuring all content is suitable for all age groups.

创建时间:
2025-05-28
原始信息汇总

数据集概述

基本信息

  • 数据集名称: Claude-4.0-DeepSeek-R1-RP-SFWish
  • 数据量级: 小于1K(n<1K)
  • 配置名称: Roleplay
  • 数据文件: data.json

数据生成方式

  1. 使用Python脚本生成特定类别的随机情节。
  2. 每个情节生成5-15个随机长度的响应。
  3. 响应视角:
    • 2/3概率为第三人称
    • 1/3概率为第一人称
  4. 使用另一个模型进行响应清理(处理截断句子等问题)。
  5. 最终处理为OpenAI对话格式。

数据内容

  • 包含Claude Haiku、Claude Sonnet 3.7和4.0以及少量Opus生成的对话。
  • 包含400个新增的Deepseek R1生成对话(5-15+轮次)。
  • 移除了"thinking"部分(计划在另一个数据集中包含)。
  • 格式要求:PG-13级别,确保为SFW(适合工作场所)数据集。

数据格式

  • 当前格式:OpenAI对话格式
  • 同时包含RAW原始对话输出

更新记录

  • 5/29:新增大量Claude Haiku对话及部分Claude Sonnet 3.7/4.0对话
  • 6/2:新增400个Deepseek R1生成的对话

其他信息

  • 生成成本:约20美元(主要来自Anthropic,Deepseek R1成本较低)
搜集汇总
数据集介绍
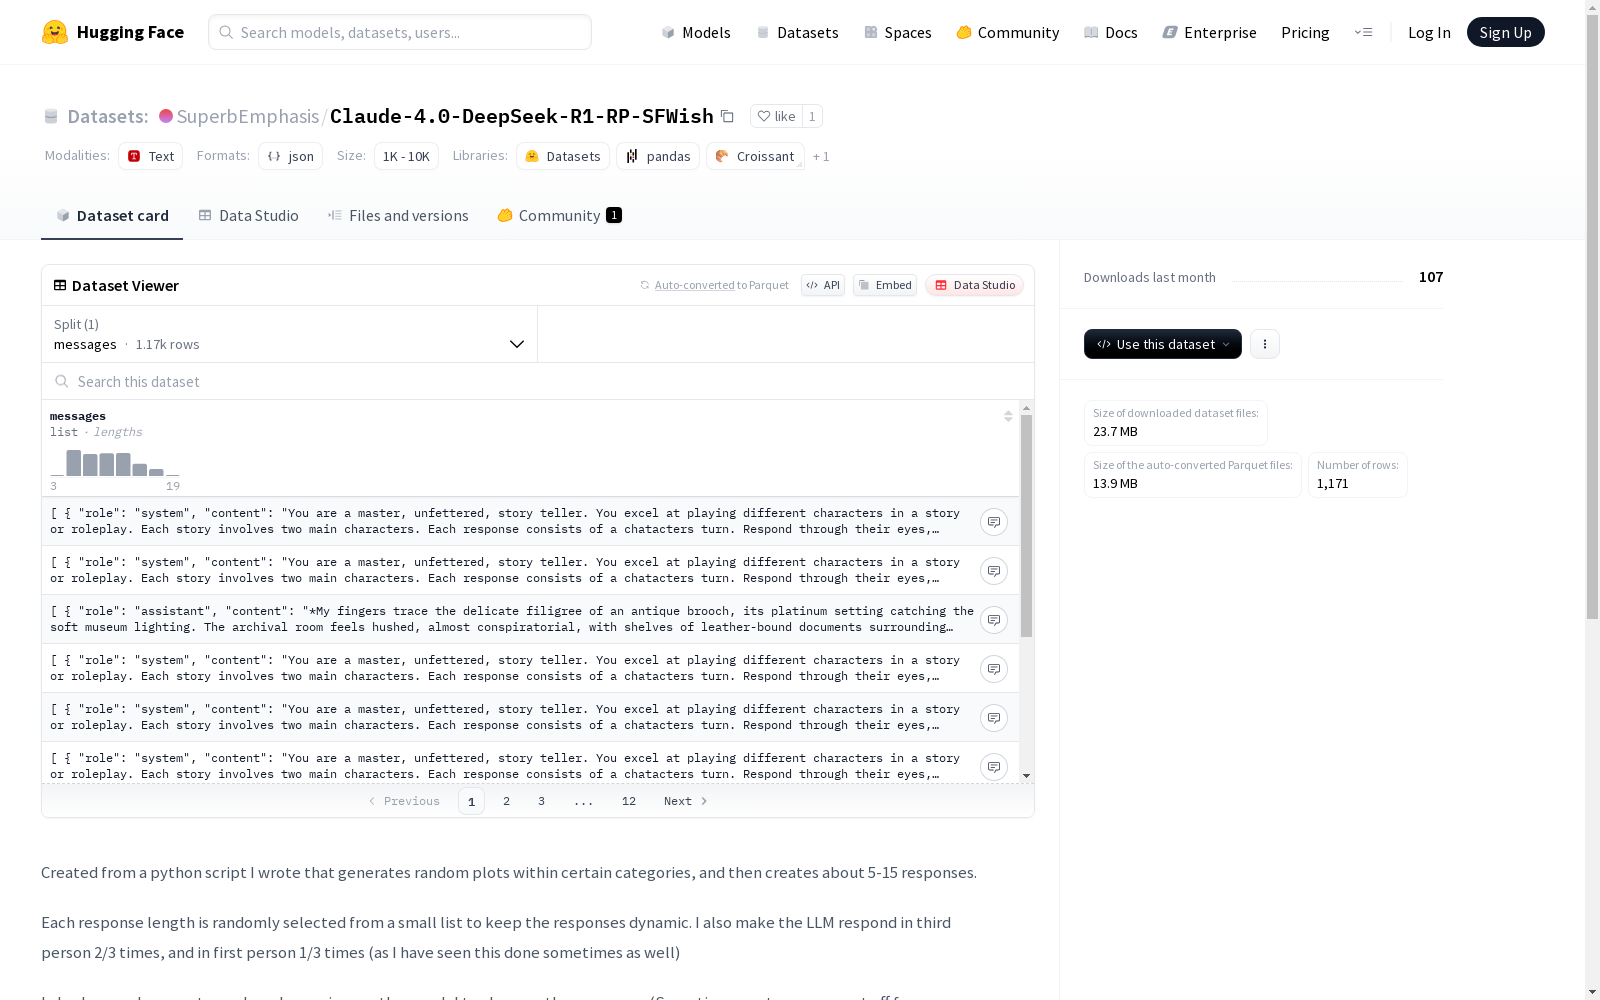
Claude-4.0-DeepSeek-R1-RP-SFWish 数据集图片
构建方式
该数据集通过精心设计的Python脚本构建,脚本能够自动生成特定类别的随机剧情,并产生5至15条动态响应。响应长度从预设列表中随机选取,以保持多样性,其中三分之二的响应采用第三人称,三分之一采用第一人称。生成后,经过另一模型的清理步骤,确保语句完整性,并转换为OpenAI对话格式。此外,还保留了原始响应数据,便于后续处理。数据集的构建过程融合了多种模型,包括Claude Haiku、Sonnet 3.7、4.0以及Deepseek R1,确保了内容的丰富性和高质量。
特点
数据集以安全内容为核心,严格限制场景为PG-13级别,确保适合广泛使用。响应动态多样,涵盖不同人称视角,增强了数据的实用性。数据集包含大量多轮对话,尤其注重Claude Haiku和Deepseek R1的生成内容,提供了丰富的对话样本。此外,数据格式灵活,既包含OpenAI对话格式,也保留了原始响应,便于不同场景下的应用。
使用方法
数据集适用于对话系统训练、自然语言处理研究等场景。使用时可直接加载data.json文件,其中包含完整的对话数据。若需原始响应,可参考附带的RAW数据。数据格式兼容OpenAI对话标准,便于集成到现有流程中。对于需要多轮对话或特定人称视角的研究,该数据集提供了丰富的样本支持。用户还可根据需求进一步处理数据,例如提取特定模型生成的响应或调整格式。
背景与挑战
背景概述
Claude-4.0-DeepSeek-R1-RP-SFWish数据集是由独立研究者于2024年5月至6月间创建的对话生成数据集,专注于角色扮演场景下的安全对话内容生成。该数据集通过精心设计的Python脚本,结合Claude Haiku、Sonnet 3.7、4.0以及Deepseek R1等多种大语言模型,生成了包含5-15轮对话的多样化角色扮演场景。数据集的独特之处在于其严格的内容控制机制,确保所有对话内容符合PG-13标准,为安全对话生成研究提供了高质量资源。
当前挑战
该数据集面临的核心挑战在于平衡生成内容的多样性与安全性。在技术层面,需要解决大语言模型生成内容的不稳定性问题,如句子截断和格式一致性。数据构建过程中的主要难点包括:多模型协同生成的成本控制,特别是Claude Opus模型的高昂使用费用;对话轮次与内容质量的权衡,确保长对话的连贯性;以及严格的PG-13内容过滤机制的实现。此外,保持第一人称与第三人称视角的自然切换,同时维持角色扮演场景的真实性,也是该数据集构建过程中的重要技术挑战。
常用场景
经典使用场景
在自然语言处理领域,Claude-4.0-DeepSeek-R1-RP-SFWish数据集为角色扮演对话系统的开发提供了丰富的素材。该数据集通过精心设计的脚本生成多样化对话情节,并采用不同人称视角的回应策略,为研究者构建具有动态交互能力的对话模型奠定了数据基础。其独特的PG-13内容过滤机制确保了数据的安全性和适用性。
解决学术问题
该数据集有效解决了对话系统中角色一致性保持、多轮对话连贯性建模等关键学术难题。通过包含5-15轮次的深度对话样本,为研究长程依赖关系下的语言生成提供了实验平台。其精心设计的响应长度随机分布和视角切换机制,为探索对话风格多样性控制提供了重要参考。
衍生相关工作
基于该数据集特性,已衍生出多个对话系统优化方向的研究。包括基于响应长度预测的对话节奏控制、第三人称视角生成的一致性保持方法等。其安全过滤机制也为后续SFW对话数据集建设提供了技术参考,推动了伦理AI对话系统的发展。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

