
遇见数据集

theprint/RolePlaying

收藏
Hugging Face2026-05-27 更新2026-05-31 收录
官方服务:

资源简介:

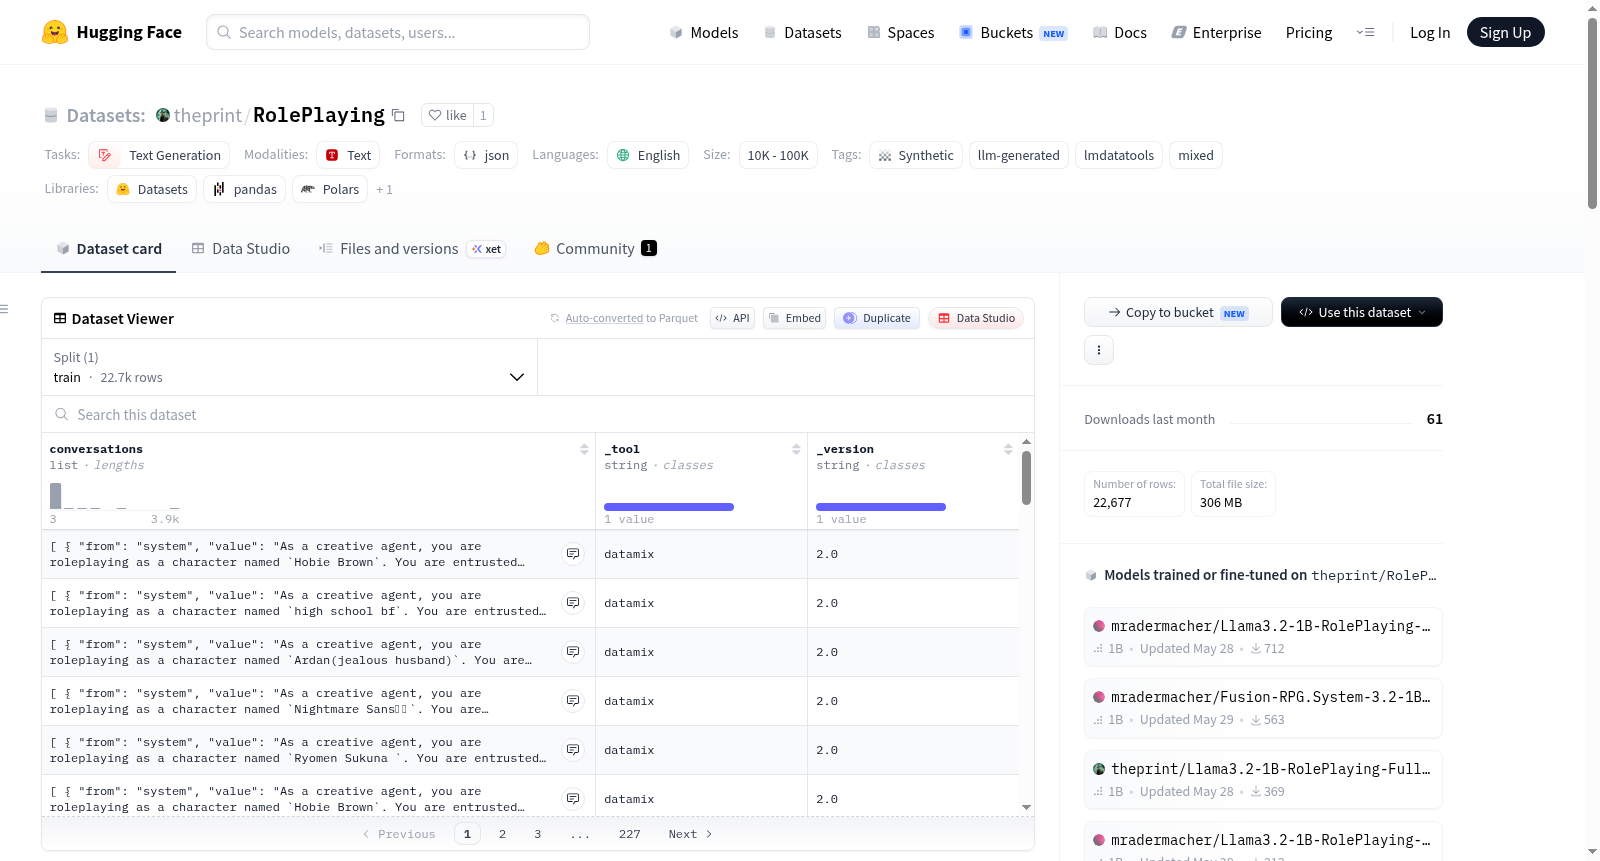
RolePlaying数据集是一个用于文本生成的合成数据集,通过DataMix和LMDataTools工具生成,包含22,677个JSON格式的条目。该数据集通过采样和组合Hugging Face上的多个来源(如andrijdavid/roleplay-conversation、NewEden-Forge/Gryphe-Sonnet3.5-Charcard-Roleplay-unfiltered和chimbiwide/RolePlay-NPC)创建,专注于角色扮演和AI聊天机器人训练。每个条目包含多轮对话数据(如human/gpt或system/human/gpt格式),涉及黑暗奇幻、浪漫/NSFW等主题,例如残酷的女王Kaori和迷信的Olivia Tezuka等具体角色场景。数据集适用于开发者和研究人员,用于训练和评估角色驱动交互式虚构和创意角色扮演模型。

The RolePlaying dataset is a synthetic dataset for text generation, generated using DataMix and LMDataTools, containing 22,677 entries in JSON format. It is created by sampling and combining multiple sources from Hugging Face, such as andrijdavid/roleplay-conversation, NewEden-Forge/Gryphe-Sonnet3.5-Charcard-Roleplay-unfiltered, and chimbiwide/RolePlay-NPC, with a focus on roleplaying and AI chatbot training. Each entry includes multi-turn conversational data (e.g., in human/gpt or system/human/gpt formats), covering topics like dark fantasy and romantic/NSFW themes, with specific character scenarios such as a cruel queen named Kaori and a superstitious woman named Olivia Tezuka. The dataset is most useful for developers and researchers working on training and evaluating models for character-driven interactive fiction and creative, uncensored roleplay.
提供机构:
theprint
搜集汇总
数据集介绍
theprint/RolePlaying 数据集图片
构建方式
RolePlaying数据集由LMDataTools工具中的DataMix模块通过混合多个来源构建而成,具体源自Hugging Face上的andrijdavid/roleplay-conversation、NewEden-Forge/Gryphe-Sonnet3.5-Charcard-Roleplay-unfiltered及chimbiwide/RolePlay-NPC三个子数据集,采用加权比例(0.4、0.3、0.3)进行采样与拼接。生成的对话记录遵循ShareGPT格式,包含指令长度在10至6000字符之间、输出长度10至4000字符的过滤条件。数据集共包含25,000个样本,最终产出22,677条有效条目,所有数据以JSON格式存储。
特点
该数据集聚焦于角色扮演类对话场景,涵盖黑暗奇幻、浪漫、超自然等多样主题,呈现丰富的角色设定和动态叙事风格。其中的对话样本展现了支配型女王、迷信老妇等鲜明角色形象,内容具有较强的叙事张力和情感色彩。通过混搭多个角色扮演语料源,数据集在保持对话多样性的同时,致力于模拟真实、自然且未过滤的交互体验,适合用于大语言模型在创意写作和角色扮演任务上的微调与评估。
使用方法
使用前需从HuggingFace下载名为RolePlaying-Sharegpt-22.68k-270526.json的JSON文件。加载时只需通过Python的json模块读取文件内容,返回列表格式数据,每个条目包含conversations字段用于存储对话轮次。每条对话记录以huma和gpt角色交替出现,系统提示字段可提供角色背景信息。该数据集可直接用于文本生成任务的模型训练,或作为角色扮演类对话系统的微调数据源,支持按需筛选特定风格或角色类型的数据子集。
背景与挑战
背景概述
RolePlaying数据集于2026年5月由LMDataTools工具通过DataMix方法生成,整合了来自HuggingFace平台三个子数据集(andrijdavid/roleplay-conversation、NewEden-Forge/Gryphe-Sonnet3.5-Charcard-Roleplay-unfiltered、chimbiwide/RolePlay-NPC)的角色扮演对话样本,共计22,677条高质量的英文多轮交互数据。该数据集旨在为大规模语言模型在角色扮演与开放域对话生成领域提供训练素材,通过模拟复杂人格设定、暗黑奇幻或情感纠葛等多元化场景,推动模型在个性化角色一致性、上下文建模及情感表达方面的能力提升。作为合成与真实混合生成数据,RolePlaying为开放域对话系统、互动叙事和AI虚拟角色开发提供了高价值的基础资源。
当前挑战
在领域问题层面,RolePlaying着力解决当前大语言模型在长程角色扮演中面临的角色人格漂移、上下文遗忘和情感连贯性不足等核心挑战,尤其在处理包含权力斗争、亲密关系或超自然元素的非结构化对话时,模型需深度理解隐性动机与语境暗示。在数据集构建过程中,挑战主要源于多维数据的异构融合:三个来源子数据集在对话格式、角色设定复杂度和指令长度分布上存在显著差异,需通过自动过滤机制确保样本质量(如设置10至6000令牌的指令长度范围),同时避免引入有害内容或破坏角色一致性,这要求在混合采样时精细平衡各来源权重(0.4、0.3、0.3),以维持数据集整体风格多样性与叙述逻辑的自洽。
常用场景
经典使用场景
RolePlaying数据集专为多轮对话中的角色扮演与情境叙事生成任务而设计,其经典用途在于训练大语言模型模拟特定性格、身份与背景的虚拟角色,在高度沉浸的交互中保持一致性。数据集中包含诸如凯奥里女王这类充满压迫性与黑暗幻想的角色,以及奥利维亚·特斯卡这类迷信而情感细腻的老年女性形象,覆盖了从权力斗争到浪漫邂逅的多元场景。它特别适合用于开发互动式小说、AI伴侣、虚拟NPC对话系统,以及需要深度角色代入的文本冒险游戏,能够促使模型在长程对话中遵从角色卡设定并自然驱动剧情演进。
解决学术问题
该数据集核心解决了大语言模型在开放式角色扮演中面临的角色一致性维持与叙事流畅性不足两大学术挑战。传统对话数据集多聚焦于信息问答或任务导向交互,难以支撑模型理解并延续虚构角色的独特世界观、语言风格与情感动机。RolePlaying通过融合来自Gryphe-Sonnet3.5-Charcard-Roleplay-unfiltered等多个高质量角色扮演数据源,提供了丰富的对话模式与剧情转折示例,使研究者能够探索如何让模型在无显式监督下自主遵循角色设定,并评估角色保持率、剧情连贯性及情感自然度等量化指标,从而推动个性化对话生成与可控文本生成理论的发展。
衍生相关工作
RolePlaying数据集衍生了一系列具有代表意义的经典工作,其中最具影响力的方向包括基于角色卡指令的微调方法研究与多代理叙事框架构建。例如,研究者利用该数据集探索了将结构化角色描述(如年龄、性格、背景故事)注入系统提示的Prompt Engineering技术,显著提升了角色回复的忠实度。同时,数据集中丰富的对话实例启发了如‘虚拟人生模拟器’等多智能体协同生成长篇幅故事的项目,智能体间通过动态的情节分配与冲突管理完成连贯叙事。此外,该数据集还被用于评估和优化对齐技术,如RLHF在创意写作场景中的安全边界,催生了关于角色发言伦理与不确定内容过滤的新讨论。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

