
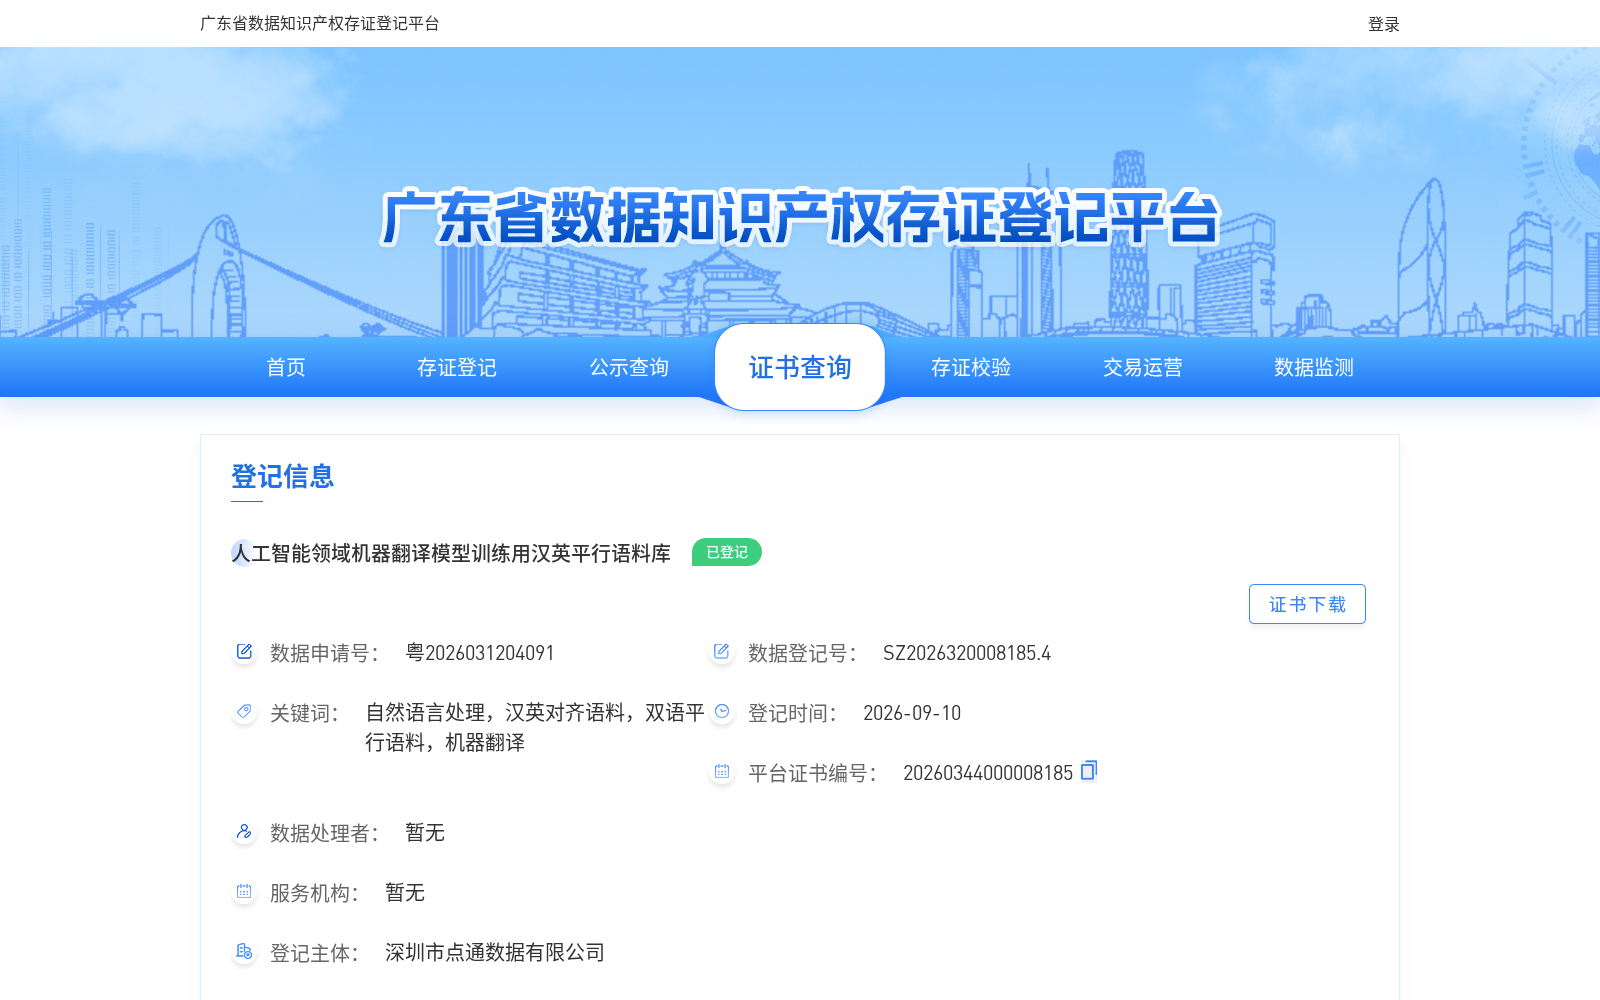
人工智能领域机器翻译模型训练用汉英平行语料库
收藏官方服务:
资源简介:
人工智能领域机器翻译模型训练用的汉英平行语料库是由深圳市点通数据有限公司为面向机器自动翻译的研发项目加工的数据资源。采集内容包含体各类新闻、文献、解说词、法律法规、影视、医学等,涉及政治、经济、军事和生活等各方面的内容。平行语料库的构建遵循国家科研课题的相关规范,是一个高质量的数据资源库。 语料采集来源基于现有各类双语资源,力求覆盖面广泛,采集语料时,在满足规模和质量的条件下,兼顾语料的平衡性,统筹考虑语料在题材、语体和时间跨度方面的平衡。包括语言教材、双语图书、技术文档、双语新闻、政府白皮书、政府公文和Web上双语资源等。 数据处理按相关对齐双语语料库的加工规范进行。主要用于机器翻译、模型训练、数据加工和信息检索等多方面的科学研究。目标客户包括人工智能相关企业、互联网公司、大学和科研机构等。
提供机构:
深圳市点通数据有限公司创建时间:
2026-09-02
搜集汇总
数据集介绍
背景与挑战
背景概述
人工智能领域机器翻译模型训练用汉英平行语料库是由深圳市点通数据有限公司加工的高质量数据资源,采集内容涵盖新闻、文献、法律法规、医学等多领域,遵循国家科研课题规范。该语料库基于各类双语资源构建,兼顾题材、语体和时间跨度平衡,主要用于机器翻译、模型训练等科学研究,目标客户包括人工智能企业、互联网公司、大学和科研机构。数据量为1000万,格式为xlsx。
以上内容由遇见数据集搜集并总结生成


