
fpadovani/goldfish-zho-hans-100mb-tokenized
收藏官方服务:
资源简介:
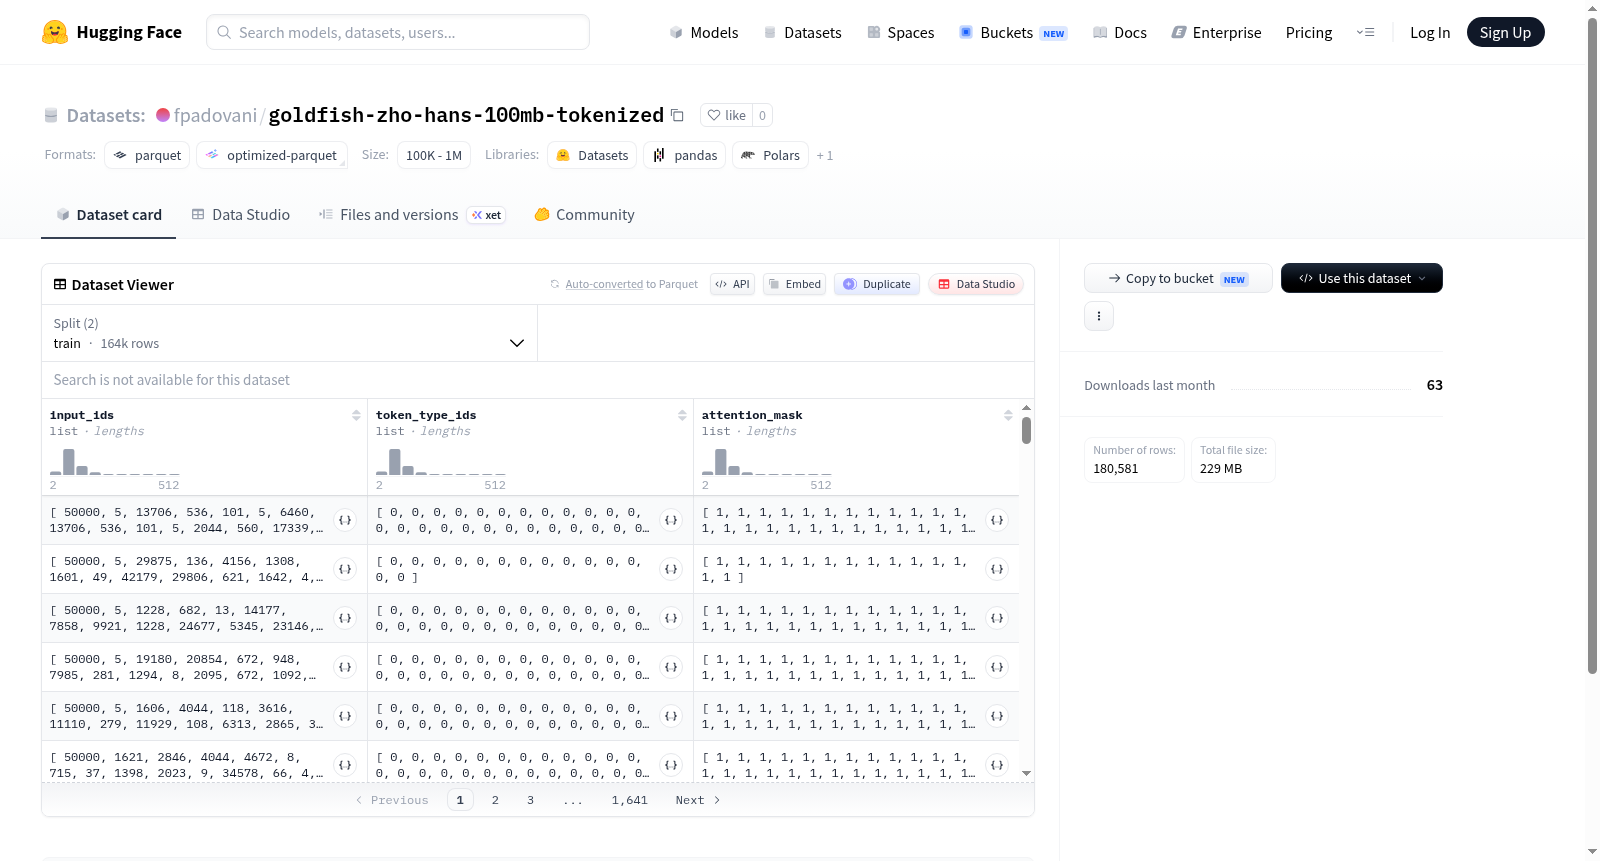
该数据集包含训练和验证两个划分,共有180,581个示例(训练集164,004个,验证集16,577个)。特征包括input_ids(int32列表)和attention_mask(int8列表),用于表示文本的编码和注意力掩码。数据集总大小约为95.86 MB,下载大小约为152.78 MB。
This dataset includes train and validation splits, with a total of 180,581 examples (164,004 in train and 16,577 in validation). Features consist of input_ids (list of int32) and attention_mask (list of int8), representing encoded text and attention masks. The total dataset size is approximately 95.86 MB, and the download size is approximately 152.78 MB.
提供机构:
fpadovani搜集汇总
数据集介绍
构建方式
该数据集名为goldfish-zho-hans-100mb-tokenized,是基于Goldfish项目构建的中文简体语料库的tokenized版本。其构建方式首先从大规模中文文本中采集约100MB的原始语料,随后采用先进的预训练分词器对文本进行编码,转化为模型可理解的输入形式。最终数据以HuggingFace Datasets格式存储,包含train和validation两个划分,分别包含164,004个和16,577个样本,确保数据规模适中且可用于模型训练与验证。
特点
数据集的核心特点在于其预处理后的tokenized结构,每条样本包含input_ids、token_type_ids和attention_mask三个字段,分别存储token索引、片段类型标识和注意力掩码,直接适配主流预训练语言模型的输入格式。此外,数据划分明确,训练集与验证集样本数量比例约为10:1,下载总大小约228MB,数据集大小约115MB,兼顾了资源效率与实验的可靠性。
使用方法
使用该数据集时,用户可通过HuggingFace Datasets库直接加载,指定配置名为'default',并利用train和validation两个拆分进行模型训练与评估。数据已预编码为整数序列,无需额外处理即可输入至BERT、RoBERTa等支持token_type_ids的模型。建议用于中文语言模型的预训练或微调任务,特别适合资源受限场景下的快速实验验证。
背景与挑战
背景概述
在自然语言处理领域,预训练语言模型的性能高度依赖于大规模、高质量语料库的支撑。goldfish-zho-hans-100mb-tokenized数据集由相关研究团队创建,旨在为中文语言模型提供经过精细分词与标记化的训练数据。该数据集包含约164,004条训练样本和16,577条验证样本,总规模约100MB,涵盖input_ids、token_type_ids及attention_mask等关键特征,可直接用于模型预训练与微调任务。其研究核心在于降低中文语料处理的复杂性,促进中文NLP模型的标准化开发。自发布以来,该数据集在中文语言模型研究领域发挥了重要推动作用,尤其为资源受限场景下的模型训练提供了高效的数据基础。
当前挑战
该数据集面临的挑战主要体现在两个方面。首先,在领域问题层面,中文语料因分词、一词多义及语境依赖性强等特点,对模型的语义理解与泛化能力提出更高要求;同时,当前预训练模型对大规模无标注数据的依赖仍未解决,而本数据集的规模仅100MB,难以覆盖丰富的中文语言现象。其次,在构建过程中,需要平衡分词粒度的选择与标注一致性,避免tokenization引入偏差;此外,数据清洗与质量控制需在有限资源下高效完成,以保证attention_mask等标注的准确性,从而支持后续模型训练的稳定收敛。
常用场景
经典使用场景
在自然语言处理与中文文本挖掘的学术探索中,高质量语料资源始终是模型能力跃升的基石。goldfish-zho-hans-100mb-tokenized数据集应运而生,它聚焦于简体中文文本的标记化预处理,为语言模型的预训练与微调提供了标准化的数据基石。该数据集最经典的使用场景集中在基于Transformer架构的中文语言模型训练中,研究人员可直接利用其预置的input_ids、token_type_ids和attention_mask字段,省去繁复的文本清洗与分词步骤,高效构建从词嵌入到语义理解的端到端学习流程。无论是用于掩码语言建模、下一句预测,还是作为跨领域迁移学习的基准语料,该数据集以其精炼的百兆规模与严谨的标记化格式,成为中文自然语言处理入门与进阶研究的理想起点。
解决学术问题
学术界长期面临中文语料非标准化与处理流程歧异化的困扰,不同研究团队因分词策略、编码方式或数据清洗规则的不同,导致实验结果难以复现与横向对比。goldfish-zho-hans-100mb-tokenized数据集通过提供统一的标记化处理方案,直击这一痛点,解决了模型训练中数据预处理环节的重复劳动与一致性问题。其重要意义在于,它使研究者能够将精力从低层次的数据工程解放出来,聚焦于模型架构创新、训练策略优化或语言现象分析等核心学术命题。该数据集的出现促进了中文NLP研究的可复现性,为比较不同模型在相同数据条件下的表现提供了公平基准,从而加速了面向简体中文的语言理解、文本生成与知识抽取等学术领域的理论突破。
衍生相关工作
围绕goldfish-zho-hans-100mb-tokenized数据集,学界与业界涌现出一系列衍生性贡献,深化了其作为中文基准语料的价值。一方面,基于该数据集的多语言扩展版本被相继提出,通过与英文、日文等语言的标记化对齐,催生了跨语言预训练模型的研究热潮,如用于零样本翻译与语义桥接的探索。另一方面,针对该数据集格式的优化工作接连发表,例如引入动态掩码策略和层次化模型方法,显著提升了训练效率与下游任务性能。更有研究以其为训练基座,开发了轻量级中文BERT变体,在移动端部署中平衡了速度与准确率。这些经典工作不仅验证了数据集的通用性与拓展潜力,也为后续中文NLP社区的协作研究与数据集生态建设树立了典范。
以上内容由遇见数据集搜集并总结生成


