
fixie-ai/big_bench_audio
收藏官方服务:
资源简介:
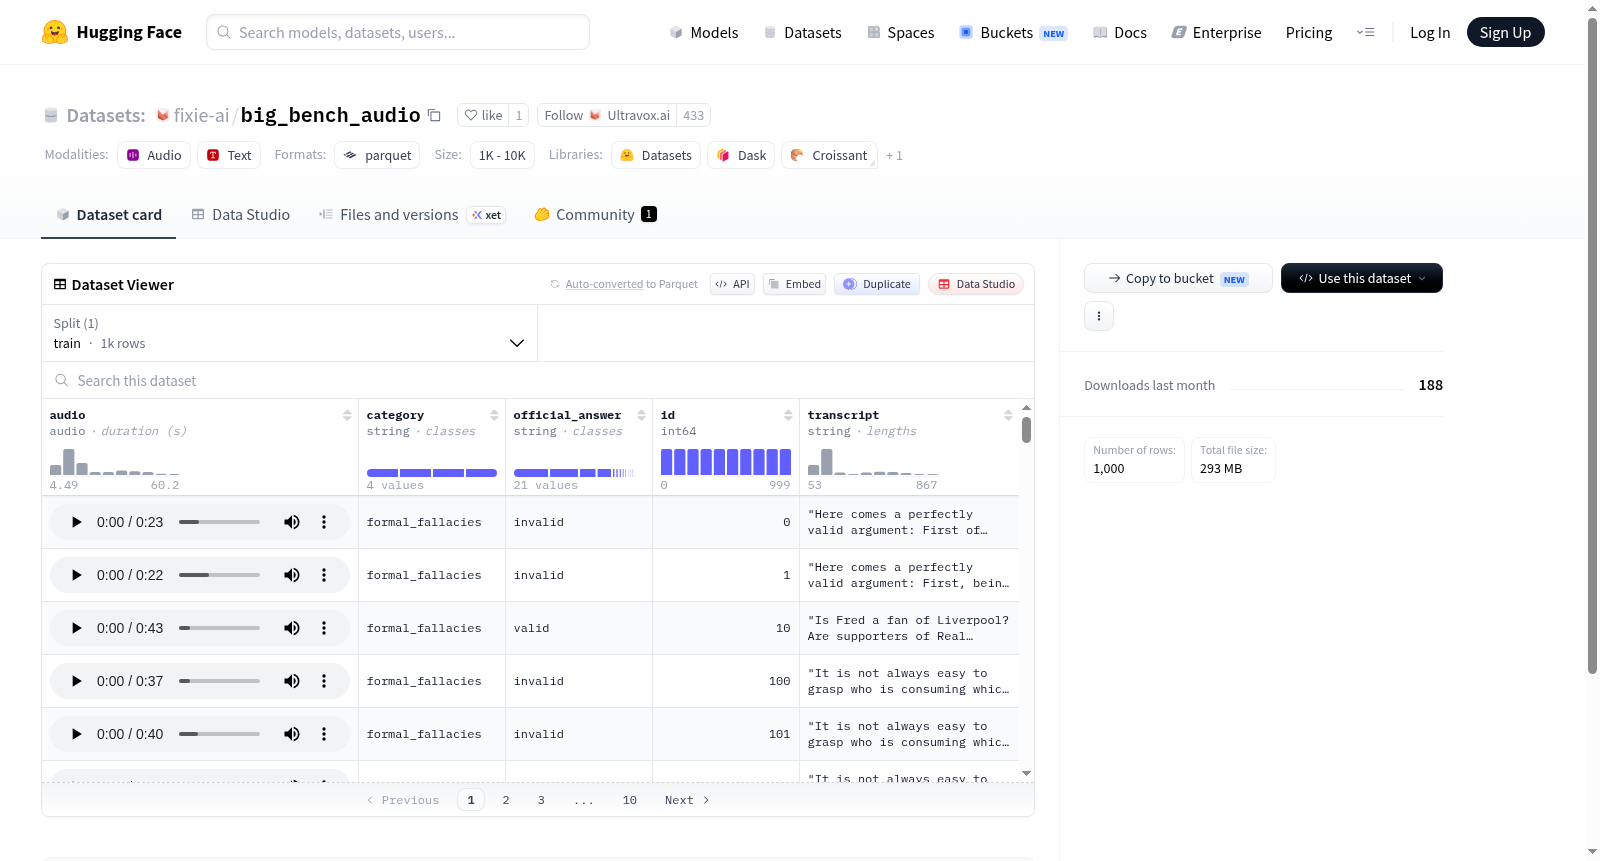
这是一个包含音频数据、分类标签、官方答案、唯一标识符和转录文本的数据集。数据集分为训练集,共有1000个示例,整个数据集的大小为319,558,085字节。数据集适用于机器学习任务,如音频识别和分类。
This dataset includes audio data, category labels, official answers, unique identifiers, and transcript text. It is split into a training set with a total of 1000 examples, and the entire dataset size is 319,558,085 bytes. The dataset is suitable for machine learning tasks such as audio recognition and classification.
提供机构:
fixie-ai搜集汇总
数据集介绍
构建方式
在人工智能与语音交互领域快速发展的背景下,fixie-ai/big_bench_audio数据集应运而生,旨在为多模态语言理解提供基准测试资源。该数据集通过精心设计构建,包含1000条训练样本,每条样本由音频文件、类别标签、官方答案、唯一标识符及转录文本五个字段组成。音频数据以标准音频格式存储,转录文本则忠实记录语音内容,确保信息完整。数据集以默认配置形式组织,数据文件按分片存储于train路径下,便于高效加载与处理。
特点
该数据集的核心特点在于其多维度信息融合与结构化设计。音频字段直接提供原始语音信号,支持端到端语音理解任务;类别标签与官方答案字段赋予数据明确的语义分类与标准答案,适用于有监督学习场景。转录文本的存在弥合了语音与文本之间的模态鸿沟,允许研究者同时利用声学特征与语言学特征。此外,数据集规模适中,千条样本覆盖多样场景,既避免过大数据带来的计算负担,又保证模型训练的充分性。
使用方法
使用该数据集时,研究者可借助HuggingFace datasets库便捷加载,通过指定配置名default与分片train即可获取全部样本。音频字段可直接输入预训练语音模型(如wav2vec 2.0)进行特征提取,结合类别标签完成分类任务;官方答案与转录文本则适用于语音识别或语义理解评估。数据集的ID字段便于样本索引与结果回溯,支持灵活的实验设计与性能分析。建议将音频与转录文本联合用于跨模态对比实验,以深入探究语音与文本表征的相互作用。
背景与挑战
背景概述
在自然语言处理与语音交互的交叉领域,大规模多模态评测基准的缺失长期制约着音频理解模型的进步。fixie-ai/big_bench_audio数据集由Fixie AI团队于近期构建,旨在弥合传统文本基准与真实语音场景之间的鸿沟。该数据集聚焦于音频样本的语义理解与推理能力,包含1000条带有转录文本、官方答案及类别标签的语音数据,覆盖常识问答、逻辑推理等多元认知维度。作为BIG-Bench系列在音频模态的延伸,它继承了该体系对模型泛化能力的严苛评估传统,为衡量语言模型在听觉输入下的知识调用与推理表现提供了标准化测试平台,其发布标志着多模态基准从视觉-文本向听觉-语义融合的关键跨越。
当前挑战
当前数据集面临的核心挑战体现在两个层面。在领域问题层面,音频理解任务需应对真实场景中的噪声干扰、口音变异及语速不均等声学复杂性,同时要求模型将时序语音信号高效映射为结构化语义表征,这对端到端模型的鲁棒性与对齐能力构成严峻考验。在构建过程中,数据收集需平衡自然对话的生态效度与标注一致性,1000条样本的有限规模可能难以覆盖长尾认知任务,且转录与答案标注依赖人工审核,易引入主观偏差。此外,音频与文本模态间的语义鸿沟使得跨模态特征融合成为技术难点,现有模型常在简单声学匹配与深层逻辑推理间顾此失彼。
常用场景
经典使用场景
在语音与语言理解交叉领域,fixie-ai/big_bench_audio数据集以其精炼的音频-文本对齐结构,成为评估多模态模型听觉推理能力的标杆。研究者常利用该数据集中的1000条音频样本,结合其对应的文字转录与官方答案,对模型在嘈杂环境下的语音识别、语义理解及跨模态对齐性能进行系统性基准测试。其简洁的类别标签与结构化ID设计,使得该数据集尤为适合构建从原始声学信号到高层语义推理的端到端评估流水线,在少样本学习与零样本泛化场景中展现出独特价值。
解决学术问题
该数据集的核心学术贡献在于填补了传统语音数据集仅关注转写准确性的空白,转而聚焦于听觉认知中的高阶推理难题。通过引入类别化音频样本与官方标准答案的配对,它有效支撑了针对机器听觉理解能力的量化研究,例如模型能否从非语言线索(如语调、背景声)中提取语义信息。这一设计解决了长期困扰学界的‘语音理解评估碎片化’问题,为对比不同架构(如Transformer与卷积网络)在听觉推理任务上的表现提供了统一基准,进而推动了多模态大模型在听觉通道认知机理上的理论突破。
衍生相关工作
基于该数据集,学术界已衍生出多项开创性工作。一方面,研究者利用其音频-答案对照结构,提出了‘听觉常识推理’新任务,推动了将视觉-语言领域的知识蒸馏方法迁移至音频模态的探索。另一方面,该数据集被用作预训练语言模型(如Whisper、HuBERT)在听觉推理维度的微调基准,催生了若干针对音频语义嵌入的改进算法,例如通过对比学习增强声学特征与文本语义的对齐。此外,部分工作还借鉴其类别划分逻辑,构建了更大规模的跨语言听觉理解测试集,拓展了多语言语音推理的研究边界。
以上内容由遇见数据集搜集并总结生成


