
遇见数据集

Tamazight-NLP/1002-Amazigh-Proverbs

收藏
Hugging Face2026-06-07 更新2026-06-14 收录
官方服务:

资源简介:

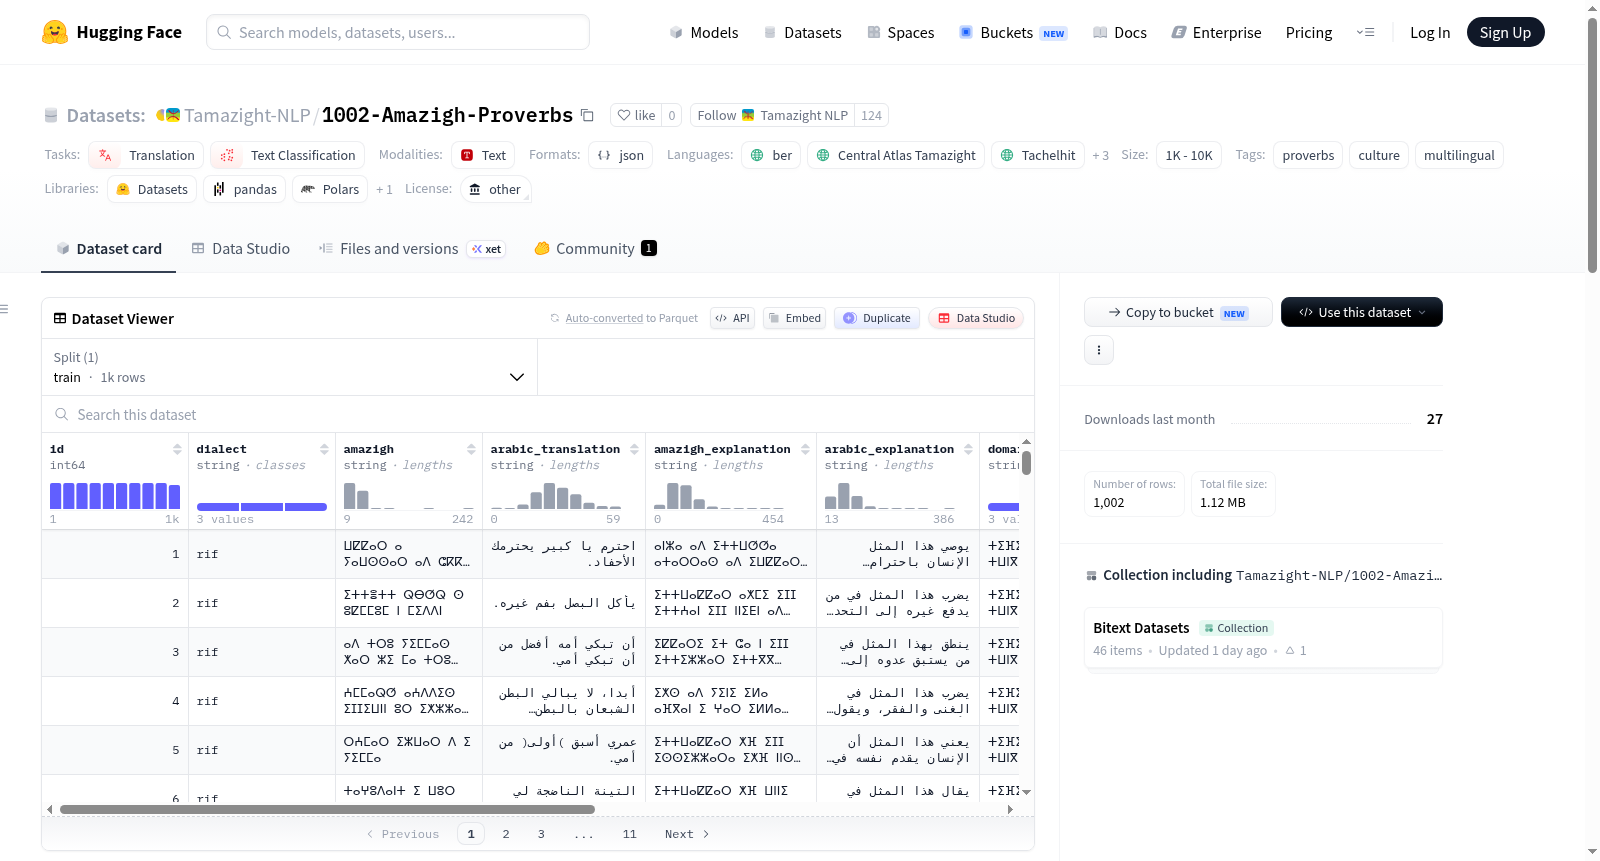
该数据集是一个精心策划的多语言阿马齐格谚语集合,包含传统阿马齐格谚语,并配有方言映射、语言解释以及多语言翻译(阿拉伯语和英语)。它旨在帮助文化保护、语言研究以及阿马齐格语言自然语言处理资源的开发。数据集覆盖阿马齐格(使用阿马齐格文字/字母书写)、阿拉伯语和英语,重点关注区域方言变体(如Tarifit、Central Atlas Tamazight、Tashelhit)。每个条目包含唯一标识符、方言、原始阿马齐格谚语文本、阿拉伯语和英语翻译、阿马齐格和阿拉伯语解释、主题领域分类(以阿马齐格、阿拉伯语和英语表示)以及英语解释。数据集来源包括数字化文献,通过自动提取和处理生成,并使用Gemini 3.1 Flash-Lite模型增强英语翻译和解释。预期用途包括机器翻译、文化保护、语义分析等。

This dataset is a curated collection of traditional Amazigh proverbs, complete with dialect mapping, linguistic explanations, and multilingual translations (Arabic and English). It is designed to aid in cultural preservation, linguistic research, and the development of NLP resources for the Amazigh language. The dataset covers Amazigh (written in Amazigh script/alphabet), Arabic, and English, with a focus on regional dialect variants (e.g., Tarifit, Central Atlas Tamazight, Tashelhit). Each entry includes a unique identifier, dialect, original Amazigh proverb text, Arabic and English translations, Amazigh and Arabic explanations, thematic domain classifications (in Amazigh, Arabic, and English), and English explanations. The dataset is sourced from digitized literature, processed through automated extraction and text scraping, and enhanced with English translations and explanations using the Gemini 3.1 Flash-Lite model. Intended use cases include machine translation, cultural preservation, and semantic analysis.
提供机构:
Tamazight-NLP
搜集汇总
数据集介绍
Tamazight-NLP/1002-Amazigh-Proverbs 数据集图片
构建方式
该数据集精心搜集了传统阿马齐格谚语,源材料来源于数字文献与传统谚语资料。为确保文化数据全球可及,借助Gemini 3.1 Flash-Lite模型生成了英文翻译、英文解释及英文领域标签。数据提取过程中采用了自动化抓取技术,但需注意少数阿拉伯语连字可能存在编码不一致的细微问题。
使用方法
数据集适用于机器翻译模型的训练与评估,特别是在低资源与区域语言场景中。亦可用于北非口头文化遗产的数字索引与分类,以及跨语言概念映射与隐喻表达的语义分析。其多语言标注结构支持翻译、文本分类等任务,为阿马齐格语言的数字生态建设提供基础语料。
背景与挑战
背景概述
该数据集名为1002-Amazigh-Proverbs,由未知研究机构或团队创建,旨在系统整理与数字化传统阿马齐格谚语。阿马齐格语作为北非地区的重要少数民族语言,长期以来在自然语言处理领域缺乏规范化资源,尤其是口语化的谚语文化承载着丰富的社会智慧与历史记忆。数据集收录了1002条谚语,覆盖Tarifit、Central Atlas Tamazight、Tashelhit等主要方言变体,并提供阿拉伯语和英语的多语翻译与语义域标注。这一工作不仅为低资源语言的机器翻译与语义分析研究提供了基础语料,更在数字化保护北非非物质文化遗产方面具有深远意义,推动了少数民族语言在NLP领域的平等发展。
当前挑战
数据集面临的核心挑战在于其解决的领域问题:低资源语言,特别是阿马齐格语方言的复杂性与标准化缺失,使得跨语言语义对齐和机器翻译任务极具难度,需要精准处理谚语中隐喻表达与文化负载概念。构建过程中,数据源自数字化文献的自动提取可能引入编码异常,例如阿拉伯语复合连字断裂,需人工校验修复。此外,英语翻译与语义域标注依赖Gemini 3.1 Flash-Lite模型生成,尽管效率高,但模型可能无法准确捕捉深层文化内涵,导致翻译语境偏差或语义失真。数据量不足千条也限制了模型的泛化能力,需进一步扩展与验证标注一致性。
常用场景
经典使用场景
在低资源自然语言处理领域,该数据集为研究者提供了珍贵的平行语料资源,尤其适用于训练和评估跨语言机器翻译模型。其独特的语种组合——涵盖三种柏柏尔方言、阿拉伯语和英语,使得研究者能够针对区域性、濒危语言进行稳健的神经机器翻译系统开发。此外,数据集内嵌的释义字段与主题域标注,为跨语言语义分析、隐喻计算以及多语概念映射研究提供了坚实的数据基石,推动了低资源语种的模型泛化能力提升。
解决学术问题
该数据集系统性地解决了柏柏尔语作为低资源语言在自然语言处理研究中长期面临的语料匮乏困境。通过提供结构化的多语对齐语料,它支持了机器翻译中的零样本与少样本学习研究,缓解了数据稀疏性问题。同时,数据集内置的多语言解释与主题域标注,为跨文化语言对比与语义表征学习开辟了新路径,助力学术界探索语言文化惯用语在神经模型中的可迁移性,对计算语言学的理论发展具有显著推动作用。
实际应用
从实际应用视角审视,该数据集能够服务于北非地区面向柏柏尔族裔的语言技术与文化服务平台建设。例如,基于该语料可以开发低资源语言的智能翻译系统和词典工具,辅助方言保护与教育普及。同时,数据集中的谚语解释与主题分类可嵌入文化旅游应用,帮助非本族语者理解柏柏尔民族的传统智慧与哲学思想。在文化遗产数字化方面,该资源为构建知识图谱与数字百科全书提供了标准化的多语数据支撑,推动了濒危语言在互联网时代的可访问性与生命力延续。
数据集最近研究
最新研究方向
该数据集聚焦于柏柏尔语(Amazigh)谚语的多语言数字化建档与文化传承,为低资源语言自然语言处理开辟了新前沿。当前研究热点集中于利用此资源训练机器翻译模型,以弥合柏柏尔语、阿拉伯语与英语之间的语义鸿沟,同时通过跨语言概念域标注探索隐喻表达的认知映射机制。结合全球对濒危语言保护的日益关注,该数据集不仅推动了北非口述遗产的语义分析与数字索引,还在多模态语境理解、方言变体分类及文化特定短语的跨语言对齐等方向上提供了基准,对促进语言多样性与AI包容性发展具有深远意义。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

