
遇见数据集

Finglish-To-Persian-Dataset-Large

收藏
Hugging Face2026-07-22 更新2026-07-23 收录
官方服务:

资源简介:

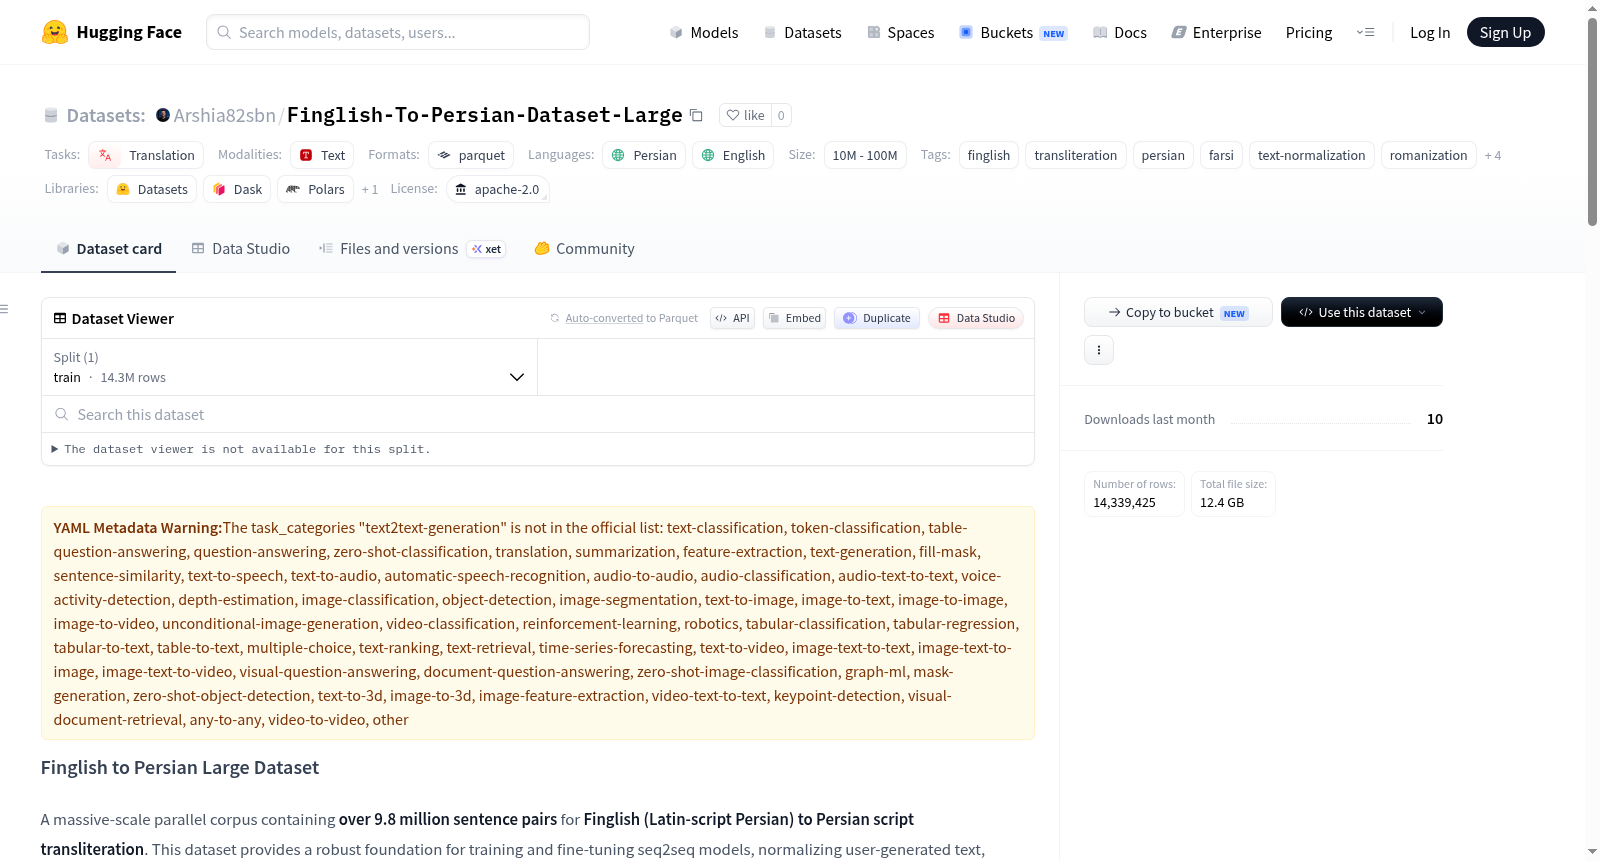
Finglish to Persian Large Dataset 是一个大规模平行语料库,专门用于Finglish(拉丁字母波斯语)到波斯文字母的转写任务。该数据集包含约9,851,664个句对,数据格式为Parquet,总大小约9.72 GB。数据通过合成方法生成,结合了基于规则和词典的转换技术。数据集包含两个主要字段:finglish_input(拉丁字母书写的波斯语字符串)和persian_output(对应的原生波斯文字母字符串)。Finglish是指在非正式数字通信(如社交媒体、短信、电子邮件)中使用拉丁字母书写波斯语的实践,由于缺乏统一标准,其书写方式变化较大。该数据集通过多阶段NLP流水线构建:首先从高质量波斯语句子源获取语料,然后进行长度和字符内容过滤,接着集成多个词典资源(包括finglify和Virastyar)以确保高覆盖率,最后应用逐词转换引擎和回退音素表处理未登录词。该数据集适用于训练序列到序列模型、用户生成文本的规范化、增强波斯语输入法以及开发能够处理非正式罗马化波斯语输入的AI代理等任务。需要注意的是,由于数据是算法生成的,可能无法完全捕捉真实世界中高度风格化的Finglish变体,且基于规则的转换可能无法覆盖所有区域性的打字习惯。

创建时间:
2026-07-18
原始信息汇总

数据集概述

Finglish to Persian Large Dataset 是一个大规模平行语料库,包含超过 980万条句子对,专门用于将 Finglish(拉丁字母书写的波斯语) 转换为 波斯语(Persian script) 的音译任务。该数据集为训练和微调序列到序列模型、用户生成文本规范化以及增强波斯语输入法提供了坚实基础。

Finglish 简介

Finglish(又称 Pinglish)是在非正式数字通信(如社交媒体、短信、邮件)中使用拉丁字母书写波斯语的实践。由于缺乏统一标准,其表达方式多样。

Finglish 输入 波斯语输出 含义
salam khoobi سلام خوبی 你好,你好吗?
man daram miravam من دارم می‌روم 我正在走
khosh amadid خوش آمدید 欢迎

数据集统计

属性
总句子对数量 ~9,851,664
数据格式 Parquet
总大小 ~9.72 GB
生成方法 合成(基于规则 + 词典)

数据字段

该数据集包含两个主要列:

  • finglish_input:拉丁字母音译字符串。
  • persian_output:原生波斯语脚本字符串(目标)。

方法论与流程

该数据集通过多阶段 NLP 流程合成生成:

  1. 语料获取:从 mshojaei77/PersianCorpus_merged 数据集中获取高质量波斯语句子。
  2. 过滤:对句子进行长度限制(10–2000 字符)并确保包含原生波斯语字符。
  3. 词典集成:整合三个主要来源的词法映射:
    • finglify:用于高频词映射。
    • Virastyar:利用 PingHelperPinglish.dat XML 提供详尽的字符级音译规则。
  4. 生成:采用逐词转换引擎,并配有回退音素表以处理词汇外标记,确保对整个语料库的全面覆盖。

使用方法

可通过 Hugging Face datasets 库直接加载: python from datasets import load_dataset ds = load_dataset("Arshia82sbn/Finglish-To-Persian-Dataset-Large") print(ds["train"][0])

潜在应用

  • 音译模型:训练 seq2seq 架构(如 mT5、ByT5、Llama-3)以将 Finglish 转换为波斯语。
  • 文本规范化:清理用户生成内容,用于下游 NLP 任务(如情感分析、命名实体识别)。
  • 聊天机器人开发:使 AI 代理能够处理非正式的罗马化波斯语输入。
  • 拼写检查:纠正非正式的打字模式。

局限性

  • 合成性质:数据集通过算法生成,可能无法完全捕捉真实世界“俚语”Finglish 的混乱变化(如高度风格化的缩写)。
  • 基于规则的约束:尽管回退音素表较为鲁棒,但词汇外单词按音位映射,可能与特定地区的打字习惯存在差异。

引用

若使用该数据集,请致谢基础工作: bibtex @misc{finglish_large_2026, author = {Arshia Saberian}, title = {Finglish to Persian Large Dataset}, year = {2026}, publisher = {Hugging Face}, howpublished = {url{https://huggingface.co/datasets/Arshia82sbn/Finglish-To-Persian-Dataset-Large}} }
搜集汇总
数据集介绍
Finglish-To-Persian-Dataset-Large 数据集图片
构建方式
在波斯语数字交流中,由于缺乏统一的拉丁化转写标准,用户常以Finglish(拉丁字母拼写的波斯语)表达,这为自然语言处理带来了巨大挑战。为应对这一难题,本数据集构建了一个规模宏大的平行语料库,包含超过980万对Finglish与波斯语脚本间的句子对。其构建过程采用合成方法,首先从高质量波斯语语料库中筛选出长度在10至2000字符之间的纯波斯语句子,随后整合了finglify、Virastyar等三种词典资源,形成统一的词汇映射表。最后,通过一个逐词转换引擎,并辅以音素回退表处理未登录词,从而系统性地生成了完整的平行语料。
特点
该数据集最为显著的特点在于其庞大体量,拥有约985万对句子对,总容量接近9.72 GB,为序列到序列模型的训练提供了深厚的数据基础。所有数据均以高效的Parquet格式存储,仅包含“finglish_input”和“persian_output”两个核心字段,结构简洁而明确。此外,数据集的合成性质确保了覆盖范围的全面性,通过整合多种词典资源和音素回退机制,能够有效地将多种多样甚至未见过的Finglish输入映射到标准波斯语,在模拟真实用户拼写变体方面展现出了强大的鲁棒性。
使用方法
使用本数据集极为便捷,依托Hugging Face的datasets库即可一键加载。用户只需执行“from datasets import load_dataset”并调用“load_dataset”函数,指定数据集标识符,即可快速获取训练数据。加载后的数据集将自动划分为训练集,用户可像操作普通Python字典一样索引样本,获取Finglish输入及对应的波斯语目标。该数据集可广泛用于训练mT5、ByT5等序列到序列模型以执行转写任务,也可作为文本标准化组件,用于净化社交媒体等非正式文本,或集成至聊天机器人中,使其具备处理拉丁化波斯语输入的能力。
背景与挑战
背景概述
在数字通信日益普及的背景下,波斯语用户广泛使用拉丁字母拼写波斯语的现象被称为Finglish(亦作Pinglish)。由于缺乏统一的转写标准,Finglish在社交媒体、短信和电子邮件等非正式场景中呈现出高度的变异性和不规范性,给自然语言处理系统带来了严峻挑战。为填补这一领域大规模高质量平行语料的空白,Arshia Saberian于2026年创建了Finglish-To-Persian-Dataset-Large,该数据集包含超过980万对Finglish与波斯语文本的平行句对,采用基于规则与词典结合的合成方法生成。研究团队整合了finglify、Virastyar等多个开源资源,构建了从语料获取、过滤到词级转换的完整流水线,为波斯语转写模型的训练、用户生成文本的规范化以及波斯语输入法的优化提供了坚实的数据基础,显著推动了低资源语言转写与文本标准化方向的研究。
当前挑战
该数据集的核心挑战在于解决Finglish转写为波斯语的领域问题:非正式数字通信中的Finglish缺乏统一标准,同一波斯词汇可能对应多种拉丁拼写变体,且高频使用网络缩写、表情符号等非标准形式,使得传统规则驱动的转写系统难以全面覆盖。构建过程中,由于真实Finglish语料的稀缺性和标注成本的高昂,团队选择合成生成策略,但这一方法面临两大挑战:一是如何确保合成数据能够模拟真实场景中用户随性、高度变化的拼写习惯,而非过度依赖理想化的音素映射;二是词典覆盖有限,对于未登录词汇只能依赖后备音素表进行近似的音译,这可能导致与特定地区或群体的实际打字习惯存在偏差,从而影响模型的泛化能力与鲁棒性。
常用场景
经典使用场景
在波斯语自然语言处理领域,Finglish-To-Persian-Dataset-Large 最经典的使用场景是构建序列到序列(seq2seq)的转写模型。该数据集涵盖了超过980万对Finglish(拉丁字母拼写的波斯语)与标准波斯语脚本之间的平行语料,为训练诸如mT5、ByT5等端到端神经机器翻译架构提供了充足且成对的数据资源。研究人员能够以此为基石,学习从非标准拉丁化波斯语到正统波斯文的高度非线性映射规律,从而有效弥合因网络通信中缺乏统一拼写标准所带来的语言表示鸿沟。
解决学术问题
该数据集的核心价值在于解决了波斯语自然语言处理中长期存在的非标准书写形式转写难题。在学术研究中,Finglish这种非正式且变体繁多的书写方式严重妨碍了后续文本分析任务的准确性,诸如情感分析、命名实体识别等经典问题在面对Finglish输入时往往性能骤降。借助该大规模平行语料,研究者能够训练出稳健的转写系统,将嘈杂的拉丁化用户生成内容归一化为标准波斯文,从而显著提升下游任务的基准表现,推动了波斯语非正式文本语义处理的理论边界扩展。
衍生相关工作
此数据集的发布催生了诸多在波斯语文本归一化与多语种转写领域的经典衍生工作。基于该语料库,研究者开发了针对OOV词汇的增强型音素回退转写算法,并利用规则与字典融合的方法提升了词汇覆盖的完备性。后续工作进一步借鉴了finglify与Virastyar等项目的构建思路,将高频词映射与字符级转写规则相结合,为跨脚本的神经转写模型提供了强有力的基准评估框架。这些成果不仅巩固了Finglish转写作为波斯语NLP基石的地位,也为其他非标准拉丁化语言(如阿拉伯语的Arabizi)的处理提供了可迁移的范例。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

